1,393 subagentes, 19 horas, un solo escritorio: cómo Nous refactorizó un millón de líneas con Hermes
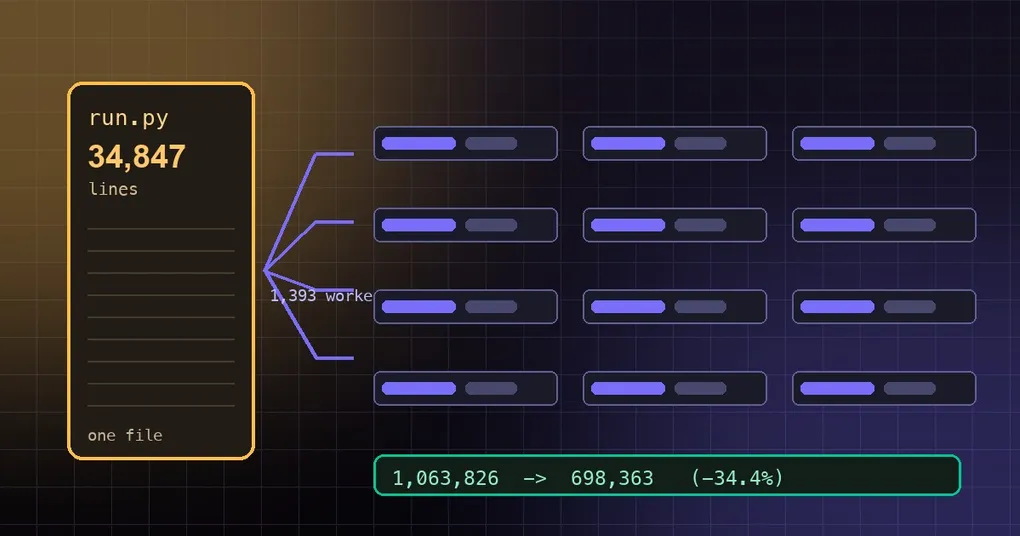
Todo repositorio que lleva unos años en mantenimiento tiene un puñado de archivos que nadie se atreve a abrir: un run.py de 34,000 líneas, una sola función de 700 líneas, una escalera de if/elif con 92 ramas de profundidad. Sabes que habría que dividirlo, pero nunca llega al sprint: no entrega ninguna funcionalidad y puede introducir regresiones, mientras las horas del equipo se van en atender a los usuarios. Esa era exactamente la situación de Nous Research, y su respuesta fue dejar que el agente lo hiciera. El 2 de septiembre de 2026, un solo /goal se ejecutó durante 19 horas, despachó 1,393 subagentes y produjo el PR #102117, eliminando el 34.4% del código fuente no de test. Después publicaron su propia telemetría, la contabilidad de costos y las nueve cosas que se rompen a esa escala, lo que convierte esto en un postmortem muy útil para cualquiera que se plantee el mismo movimiento.
El resultado, primero
| Métrica | Antes | Después |
|---|---|---|
| Líneas de código fuente no de test (todos los directorios) | 1,063,826 | 698,363 (−34.4%) |
| Archivos de más de 5,000 líneas | 37 | 6 |
| Funciones de más de 300 líneas | 192 | 2 |
Cadena de if/elif más larga |
92 ramas | 9 |
gateway/run.py |
34,847 líneas | 5,512 líneas |
| Peor complejidad ciclomática | 1,075 | 84 |
El diff final fue de 4,271 commits repartidos en 2,655 archivos (+436,199 / −784,430), un commit por cada paso verificado. La ejecución principal duró unas 19 horas y 93,284 llamadas, con un costo de unos $19,300, o aproximadamente $25,000 si se incluyen las sesiones de seguimiento. Su estimación de personal para hacerlo a mano era de $150,000–$1.8M, que es precisamente por lo que nunca se llegó a programar.
También publicaron las contramétricas. El número de módulos subió de 1,152 a 1,551 y las aristas de importación de 5,245 a 7,135; los puntos de entrada divididos importan algo más lento (run_agent de 270 a 292 ms, gateway.run de 154 a 196 ms). Dividir compró legibilidad, y no salió gratis.
Por qué vale la pena medir «cuánto le cuesta a un agente leer el código»
La idea más transferible de todo esto es que trataron cuántos tokens tiene que gastar un agente para entender el repositorio como una métrica medible, y no como un eslogan. Dejaron cuatro arneses en el repositorio (bench.py, lookup_sim.py, static_metrics.py, runtime_bench.py bajo evals/codebase_navigability/, junto con un README), de modo que cualquiera puede reproducirlos:
| Por cada tarea de «muéstrame este símbolo» | Antes | Después |
|---|---|---|
| Búsquedas cuyo archivo no cabe en un contexto de 128k | 1,589 | 0 |
| Tokens del archivo que lo define (mediana) | 30,762 | 10,333 (−66%) |
| Tokens del archivo que lo define (máx.) | 330,028 | 85,075 (−74%) |
| Tokens realmente devueltos por búsqueda (media) | 2,218 | 993 (−55%) |
Dicho en términos simples: antes de la refactorización, 1,589 de los símbolos que importa la suite de test vivían en un archivo que ningún modelo con contexto de 128k puede cargar. Eso no es un problema de estilo; es un límite duro de capacidad. La media se redujo a la mitad porque la cola se desplomó —las definiciones individuales pasaron de 38,691 tokens a 2,348—, mientras que la mediana subió ligeramente (de 564 a 680) porque quitar los comentarios hace que cada línea superviviente sea más densa en tokens. La cola larga es donde se estaba quemando el contexto.
Cómo se organizó
- Un único
/goalfijó el estándar en lugar de dar instrucciones. El prompt original decía, en esencia: una simplificación masiva, al menos 30% menos de líneas, archivos dios descompuestos, helpers unificados, menos enrutamiento de if-if-if, más legibilidad y elegancia, grasa eliminada, todo terminado, entregado como un PR y, de forma crítica, «sin esperar mis decisiones». - El orquestador midió primero y luego dividió. Partió el código en 36 grupos sin solapamiento y redactó él mismo las asignaciones, de modo que el autor nunca tuvo que briefear a un worker individualmente.
- Un git worktree por worker. Los workers editaban checkouts separados, así que no podían sobrescribirse entre sí; cada brief indicaba el código que había que simplificar, las interfaces que había que preservar y las comprobaciones requeridas antes de hacer commit.
- La paridad de interfaces fue una restricción dura. El esquema JSON de una herramienta tenía que permanecer byte a byte idéntico, y la salida de
--helpde un CLI se podía comparar byte a byte. Cada paso verificado tenía que acabar en un commit. - La escala que implicó. La orquestación corría como un único proceso de Python en un escritorio i7 con 64 GB de RAM, alcanzando un pico de 218 agentes concurrentes (unos 110 de media), con la inferencia en remoto. A lo largo de la ejecución: 478 lotes de delegación, 1,652 tareas de subagente, 111,352 llamadas a herramientas (70,046 de terminal, 14,223 de read_file, 9,224 de execute_code, 8,631 de write_file, 5,042 de patch, 1,328 delegaciones anidadas), una tarea mediana de 39 minutos y un p90 de 3.2 horas.
Las nueve cosas que se rompen a escala
La auditoría forense posterior (issue de seguimiento #103563) corrigió nueve clases de problemas. Estos son los muros contra los que te vas a chocar de verdad:
| Síntoma | Medido | Después del arreglo |
|---|---|---|
| Estampida de auth — muchos agentes renovando tokens a la vez | 620 × 401 en una sola ventana; el padre murió, 329 hijos quedaron huérfanos y 74 se redespacharon (~$3,900) | 40 agentes expirando: 40 × 401 → 0 |
| Subagentes muertos que nadie nota | una oleada entera muerta pasó desapercibida durante 66 minutos | se detectaba en 0.3 segundos |
| Resúmenes de hijos truncados a muñones | 114 de 121 recortados a 2K caracteres — conclusiones sin proceso | resúmenes completos |
| Timeouts en delegaciones anidadas | 332 timeouts; solo 89 de unos 1,400 llamadas anidadas llegaron a devolver algo | exentos de deadline en todos los niveles |
| Nivel de caché equivocado | los hijos escribían en el nivel de 1 hora ($20/M) para una retención que un worker de 20 minutos nunca usa | nivel de 5 minutos ($12.51/M, mismo bucle, medido) |
| Fricción de herramientas | 546 bloqueos falsos de hardline, 454 rechazos por timeout, 661 reescrituras de archivo completo (~$155) | las tres clases desaparecieron |
| Pérdida silenciosa de API pública | 1,703 nombres públicos y 126 tests eliminados al abrir el PR; la revisión humana encontró unos 30 | detectados mecánicamente en 18 segundos, integrado en CI |
| Estancamiento del bucle de goal | aparcado 3 h 22 min en el poller de un nieto; 4 de 5 empujones desperdiciados | solo procesos propios, tope de 30 minutos, reanudación por idle-hook |
| Dispersión de servidores de lenguaje | unos 30 procesos de Pyright consumiendo 8.7 GB | los worktrees comparten un único servidor, con una comprobación de que los diagnósticos siguen llegando |
Lee con atención la fila de costos: los autores la describen explícitamente como una comparación de precio por escritura, no un ahorro agregado, y el issue de seguimiento separa cuatro cosas a propósito: lo que la ejecución gastó históricamente, lo que se observó que iba mal, lo que una simulación dice que cambiaría un arreglo, y lo que realmente cambió. Esa contención merece copiarse.
El riesgo real vive en la revisión
Por muy fluida que sea la automatización, los humanos siguen atrapando las regresiones. Dos rondas de revisión de la comunidad encontraron:
- Nombres públicos eliminados porque un worker no veía llamadores dentro del repositorio, mientras que los plugins externos sí los importan.
- Una reescritura automática de
suppress()que cambió el manejo de excepciones en unos 65 sitios, algo que los tests existentes no cubrían en absoluto.
La respuesta de compatibilidad fue concreta: 2,091 nombres movidos seguían siendo importables desde sus módulos antiguos mediante un puntero PLUGIN-COMPAT, cada uno verificado por identidad de objeto contra su nuevo dueño, y no se permitió que ningún código del árbol usara un puntero (una comprobación AST lo hacía cumplir en CI). Los punteros eran explícitamente temporales y se revirtieron el 14 de septiembre de 2026. Hoy hermes plugins compat escanea los plugins afectados, con plugins.allow_deprecated_imports: true como vía de escape.
La escala de verificación también merece mención: la suite completa reportó 44,859 passed / 51 failed, y esos mismos 17 archivos fallan de forma idéntica en main limpio (mismo conjunto de archivos, mismos conteos por archivo). Regresiones atribuibles a la refactorización: 0. Esa disciplina de línea base congelada es un hábito que sus propias skills codifican: reproducir un fallo en un entorno limpio primero para saber si ya estaba roto.
Si quieres probar esto en tu propio repositorio
- Escribe el objetivo como criterios de aceptación decidibles: la reducción de LOC, qué archivos se dividen, qué interfaces deben permanecer byte a byte idénticas.
- Mide antes de mover nada. Sus cuatro arneses están en el repositorio; la idea se transfiere aunque los scripts no.
- Un worktree por worker, un commit por paso verificado: eso es lo que hace que una ejecución fallida se pueda reanudar.
- Cuenta con las interrupciones. Unos cincuenta minutos después de empezar su ejecución, el token de auth del provider expiró y mató todo el proceso; como los commits y los briefs sobrevivieron, una sesión aparte pudo diagnosticar, escribir un handoff y reanudar con éxito.
- Presupuesta la revisión. De los commits de arreglo posteriores al merge, dieciséis pertenecían a la clase «API pública descartada en silencio».
- Acepta el intercambio. El número de módulos y el tiempo de importación empeoraron; quedan seis archivos de más de 5,000 líneas, que el equipo señala como la siguiente ronda.
Fuentes y contabilidad
Cada cifra de este artículo proviene de material público oficial: el propio write-up de Nous Research (publicado el 17 de septiembre de 2026), el PR #102117 (mergeado el 4 de septiembre de 2026) y el issue forense de seguimiento #103563. Estos son los datos y las estimaciones de la propia ejecución del proyecto —incluido el rango de costos y la comparación con personal humano—, no mediciones que hayamos reproducido localmente, y los enlaces están ahí para que los compruebes.
Otros enfoques sobre la misma capacidad: orquestación en vivo de subagentes cubre cómo observar agentes en paralelo mientras trabajan, heartbeats y goal gates explica por qué las ejecuciones de /goal de largo horizonte necesitan heartbeats y comprobaciones de aceptación, el catálogo de plugins es el contexto práctico de esa sección sobre compatibilidad con plugins externos y, si los agentes de varias personas editan un mismo repositorio, el arbitraje neutral de conflictos de merge es el siguiente paso natural.
Resumen
- Un solo
/goal, 19 horas, 1,393 subagentes (218 concurrentes en el pico): el código fuente no de test pasó de 1,063,826 → 698,363 líneas (−34.4%),gateway/run.pyde 34,847 a 5,512 líneas y las funciones de más de 300 líneas de 192 a 2. - Costo de unos $19,300 (alrededor de $25,000 con los seguimientos) frente a una estimación de personal de $150,000–$1.8M; el precio que se paga son más módulos y importaciones más lentas.
- Convirtieron «los tokens que un agente gasta leyendo el código» en una métrica reproducible: las búsquedas cuyo archivo no cabe en un contexto de 128k bajaron de 1,589 a 0.
- Los verdaderos obstáculos están a nivel de orquestación: estampidas de auth (620 × 401 → 0), hijos muertos sin detectar durante 66 minutos (→ 0.3 s), resúmenes truncados en 114 de 121 hijos, el nivel de caché equivocado y 1,703 nombres públicos descartados en silencio, ahora detectados en 18 segundos por una comprobación mecánica.