Tu agente solo ve un nombre de archivo: cambiar el speech-to-text de Hermes a Qwen
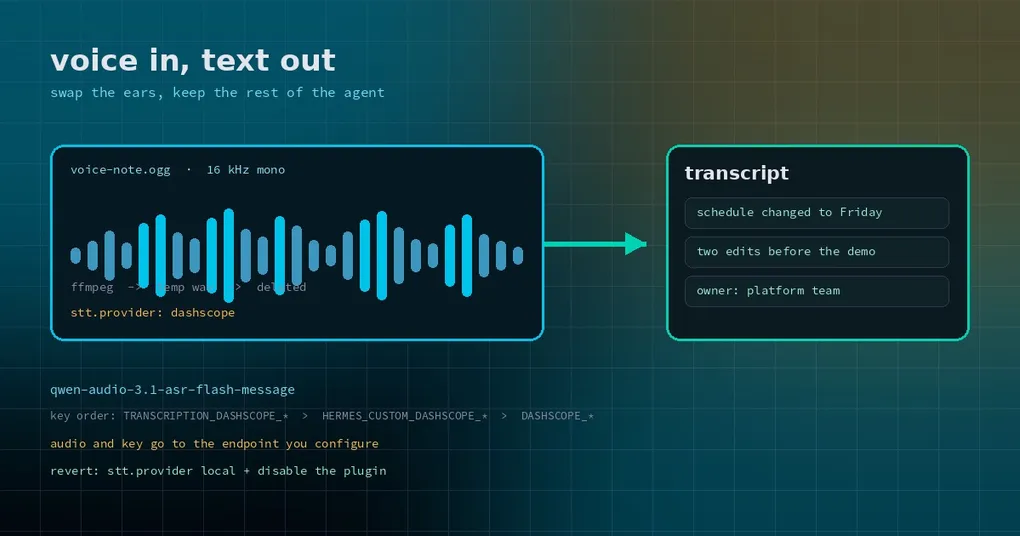
Un socio te manda una nota de voz de dos minutos y medio: el calendario y dos cosas que cambiar. Se la reenvías a Hermes y le pides una lista de tareas. Te responde que ha recibido un archivo de audio y luego pregunta qué contenía. Desde el lado del agente, eso es exactamente lo que recibió: un .ogg.
Las notas de voz son la entrada más común que un agente descarta en silencio. Hermes tiene una capa de speech-to-text con una opción local de Whisper y varios backends en la nube, y cada uno tiene un precio: Whisper local come CPU y tarda en cargar; los backends en la nube piden una clave en una red que quizá no tengas, o una factura por minuto. Si tu equipo ya vive en el stack Qwen/Alibaba, ahora hay un tercer camino: el plugin comunitario transcription-dashscope, que conecta el STT de Hermes a Qwen-Audio-ASR en la Qwen AI Platform (DashScope).
Qué capa sustituye
Hermes divide la voz en dos mitades independientes: stt.* convierte sonido en texto y tts.* convierte texto en sonido. Por defecto stt.enabled está activo, y también echo_transcripts: el gateway transcribe un mensaje de voz entrante y devuelve la transcripción como un mensaje 🎙️.
El backend es intercambiable. Core trae varios (Whisper local, Groq, OpenAI, Mistral, ElevenLabs, DeepInfra, xAI), y los plugins pueden registrar nombres de proveedor adicionales. Este plugin registra dashscope, así que lo único que cambias es stt.provider.
Cubre dos flujos: la transcripción automática de mensajes de voz del gateway y el dictado en Desktop o en la CLI, con texto parcial en vivo cuando stt.streaming está activo. El modelo por defecto es qwen-audio-3.1-asr-flash-message.
Tres cosas antes de instalar
Una clave de API de la Qwen AI Platform. Sin ella no funciona nada.
ffmpeg en la máquina. El plugin lo usa para normalizar cada grabación a 16 kHz mono, la tasa que acepta el endpoint de transcripción en vivo y que no es la que suelen usar los archivos de voz de Telegram o WhatsApp. La conversión escribe un wav temporal y lo borra después.
Un Hermes lo bastante reciente. La entrada del catálogo exige >=0.22.5. No lo fuerces en una compilación antigua; actualiza primero.
Luego instala en orden:
hermes plugins install transcription-dashscope
hermes plugins enable transcription-dashscope
hermes gateway restart
El reinicio no es opcional. El plugin trae dependencias de Python y el proceso en marcha todavía no las ha cargado. Sáltate ese paso y el siguiente comando falla con algo como DashScope SDK is not importable in this process: eso no es una instalación rota, es un proceso que no ha cambiado todavía.
Cuatro líneas para activarlo
Pon la clave en el .env del perfil:
DASHSCOPE_API_KEY=sk-your-keyEl plugin lee tres variables, por prioridad: TRANSCRIPTION_DASHSCOPE_API_KEY (específica del plugin), HERMES_CUSTOM_DASHSCOPE_API_KEY (el conjunto de proveedor personalizado) y por último DASHSCOPE_API_KEY (el proveedor Alibaba integrado). Cualquiera de las tres sirve, así que una instalación de Alibaba que ya exista no necesita clave nueva.
Apunta el STT ahí:
hermes config set stt.provider dashscope
hermes config set stt.enabled true
hermes config set stt.streaming true
stt.streaming es el modo “el texto aparece mientras hablas”. Si solo necesitas transcribir notas de voz, déjalo en false: también elimina el ruido de las revisiones a mitad de frase.
Las perillas que importan con audio real
El modelo por defecto maneja bien el mandarín, pero las grabaciones reales tienen muletillas, acentos y ruido de fondo. El plugin pasa los parámetros de reconocimiento de DashScope, y tres merecen configurarse el primer día:
hermes config set stt.dashscope.disfluency_removal_enabled true
hermes config set stt.dashscope.max_sentence_silence 400
hermes config set stt.dashscope.vad_model near_meeting_16kdisfluency_removal_enabledquita los “eh”, “o sea”, “¿sabes?”. Vale la pena para notas de reunión.max_sentence_silencees cuánto tiene que durar una pausa para cerrar una frase, en milisegundos. Súbelo con hablantes lentos que hacen muchas pausas y la segmentación sale menos entrecortada.vad_modelelige el modelo de actividad de voz usado para segmentar. Un modelo de reunión de campo cercano comonear_meeting_16kes más estable que uno genérico en una sala.
Hay algunas más que conviene conocer: keep_dialect conserva el dialecto en lugar de normalizar al mandarín estándar, speech_noise_threshold ajusta el corte entre voz y ruido, vocabulary_id asocia una lista de hotwords precompilada (un salto grande de precisión con nombres de producto y jerga) y language_hints acepta hasta cuatro indicaciones de idioma. Todo lo que no tenga una clave de configuración dedicada se puede pasar en bloque mediante un diccionario parameters.
Fija también el idioma explícitamente. El valor global por defecto de Hermes es en, por una buena razón: la detección automática de Whisper falla con clips cortos. Para entrada en chino:
hermes config set stt.language zhLas claves no definidas bajo stt.dashscope caen a los valores por defecto. El endpoint por defecto es https://maas.qianwenaiapi.com/api/v1; dale una dirección HTTP y el plugin sustituye él mismo el endpoint en vivo. Las direcciones compatibles con OpenAI (con /compatible-mode/v1) también funcionan, porque el SDK solo lee el nombre de host. workspace solo se usa cuando lo defines.
A dónde va el audio
Sé claro con esto: el audio y la clave de API van al endpoint que hayas configurado — la Qwen AI Platform por defecto — y nada más sale de la máquina. En local hay un wav temporal usado para la transcodificación, borrado después de la llamada. Esto es una llamada a la nube. Si las grabaciones son sensibles, quédate en Whisper local o confirma que la ruta cumple tus reglas de cumplimiento antes de cambiar.
Cómo dar marcha atrás
Dos comandos:
hermes config set stt.provider local
hermes plugins disable transcription-dashscope
Los querrás en tres casos: la cuenta se quedó sin crédito o el modelo no está habilitado (Arrearage: Access denied); el audio es demasiado largo — este modelo apunta a clips cortos y reconocimiento a nivel de conversación, así que una entrevista de una hora quiere un modelo dedicado a transcripción de archivos; o simplemente no quieres que el audio salga de la máquina.
Una cosa más que saber de antemano: la interfaz de voz del SDK 2.0 está oficialmente etiquetada como preview. Después de cualquier actualización del SDK, manda un mensaje de voz y confirma que aún transcribe, en lugar de descubrir la rotura durante una reunión importante.
¿Merece la pena cambiar?
Si tu entrada de voz es sobre todo chino, no es de volumen muy alto y prefieres no ejecutar Whisper en local, es un buen intercambio: dos comandos de instalación, cuatro líneas de configuración y la plataforma se encarga del resto. No cambia nada por encima de la capa STT: las transcripciones siguen llegando a la sesión y siguen disparando las mismas llamadas a herramientas; solo cambian los oídos.
Si tu audio es sobre todo inglés, o la privacidad es la restricción, el Whisper local integrado sigue siendo la opción más tranquila, a costa de una primera carga lenta y de CPU constante. Para recortar el silencio antes de subir y descargar el modelo cuando está inactivo, la guía de recorte de silencio y descarga por inactividad del STT entra más a fondo. La mitad de salida — texto a voz — se cubre en la guía del selector de voces.