Votre agent ne voit qu'un nom de fichier : passer la reconnaissance vocale de Hermes à Qwen
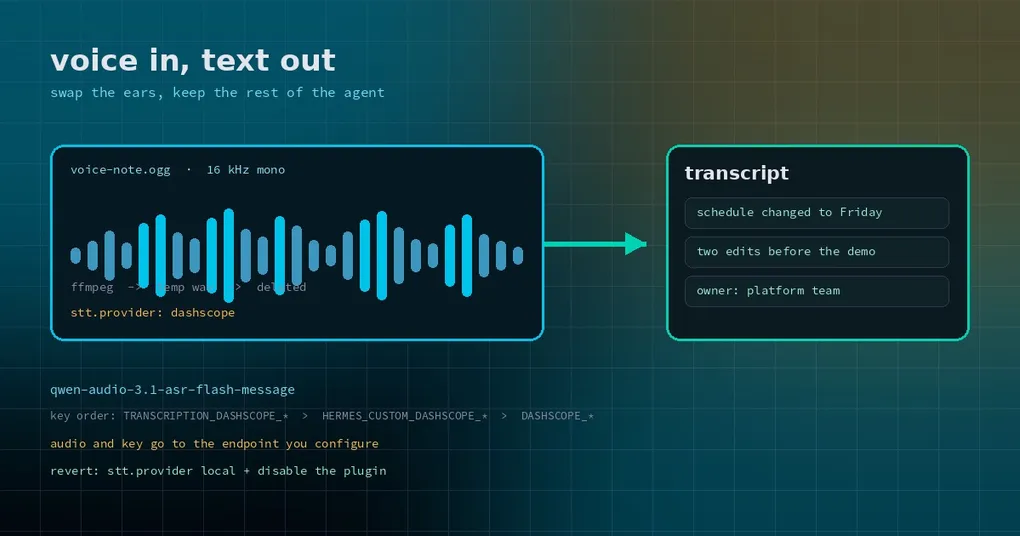
Un partenaire vous envoie un message vocal de deux minutes et demie : le planning, plus deux choses à modifier. Vous le transmettez à Hermes et demandez une liste de tâches. Il répond qu’il a bien reçu un fichier audio, puis demande ce qu’il contenait. Du point de vue de l’agent, c’est exactement ce qu’il a reçu — un .ogg.
Les messages vocaux sont l’entrée la plus courante qu’un agent laisse tomber en silence. Hermes dispose d’une couche de reconnaissance vocale avec une option Whisper locale et plusieurs backends cloud, et chacun a un prix : Whisper en local mange du CPU et met du temps à se charger ; les backends cloud réclament soit une clé sur un réseau que vous n’avez peut-être pas, soit une facture à la minute. Si votre équipe vit déjà dans l’écosystème Qwen/Alibaba, il existe désormais une troisième voie — le plugin communautaire transcription-dashscope, qui branche le STT de Hermes sur Qwen-Audio-ASR de la Qwen AI Platform (DashScope).
Quelle couche il remplace
Hermes sépare la voix en deux moitiés indépendantes : stt.* transforme le son en texte, tts.* transforme le texte en son. Par défaut, stt.enabled est actif, tout comme echo_transcripts — la gateway transcrit un message vocal entrant et renvoie la transcription sous forme de message 🎙️.
Le backend est interchangeable. Le cœur embarque plusieurs implémentations (Whisper local, Groq, OpenAI, Mistral, ElevenLabs, DeepInfra, xAI), et les plugins peuvent enregistrer des noms de fournisseurs supplémentaires. Ce plugin enregistre dashscope, donc la seule chose que vous changez est stt.provider.
Il couvre deux flux : la transcription automatique des messages vocaux de la gateway, et la dictée sur Desktop ou en CLI avec du texte partiel en direct quand stt.streaming est actif. Le modèle par défaut est qwen-audio-3.1-asr-flash-message.
Trois choses avant d’installer
Une clé d’API Qwen AI Platform. Rien ne fonctionne sans elle.
ffmpeg sur la machine. Le plugin l’utilise pour normaliser chaque enregistrement en mono 16 kHz — le débit qu’accepte l’endpoint de transcription en direct, et qui n’est pas celui des fichiers vocaux de Telegram ou WhatsApp. La conversion écrit un wav temporaire puis le supprime.
Un Hermes assez récent. L’entrée du catalogue exige >=0.22.5. Ne le forcez pas sur une version plus ancienne ; mettez à jour d’abord.
Puis installez dans cet ordre :
hermes plugins install transcription-dashscope
hermes plugins enable transcription-dashscope
hermes gateway restart
Le redémarrage n’est pas facultatif. Le plugin apporte des dépendances Python, et le processus en cours ne les a pas encore chargées. Sautez cette étape et la commande suivante échoue avec un message du genre DashScope SDK is not importable in this process — ce n’est pas une installation cassée, c’est un processus qui n’a pas basculé.
Quatre lignes pour l’activer
Mettez la clé dans le .env du profil :
DASHSCOPE_API_KEY=sk-your-keyLe plugin lit trois variables, par ordre de priorité décroissante : TRANSCRIPTION_DASHSCOPE_API_KEY (propre au plugin), HERMES_CUSTOM_DASHSCOPE_API_KEY (l’ensemble des fournisseurs personnalisés), puis DASHSCOPE_API_KEY (le fournisseur Alibaba intégré). N’importe laquelle suffit, donc une installation Alibaba existante n’a pas besoin d’une nouvelle clé.
Pointez le STT dessus :
hermes config set stt.provider dashscope
hermes config set stt.enabled true
hermes config set stt.streaming truestt.streaming, c’est le mode « le texte apparaît pendant que vous parlez ». Si vous voulez seulement transcrire les messages vocaux, laissez-le à false — cela supprime aussi le bruit des révisions en milieu de phrase.
Les réglages qui comptent pour de l’audio réel
Le modèle par défaut gère bien le mandarin, mais de vrais enregistrements contiennent des mots de remplissage, des accents et du bruit de fond. Le plugin transmet les paramètres de reconnaissance de DashScope, et trois méritent d’être réglés dès le premier jour :
hermes config set stt.dashscope.disfluency_removal_enabled true
hermes config set stt.dashscope.max_sentence_silence 400
hermes config set stt.dashscope.vad_model near_meeting_16kdisfluency_removal_enabledretire les « euh », « genre », « tu vois ». Utile pour des notes de réunion.max_sentence_silenceest la durée minimale d’une pause pour terminer une phrase, en millisecondes. Augmentez-la pour les personnes lentes qui marquent beaucoup d’arrêts et la segmentation devient moins hachée.vad_modelchoisit le modèle de détection d’activité vocale utilisé pour la segmentation. Un modèle de réunion en champ proche commenear_meeting_16kest plus stable qu’un modèle générique dans une salle.
Quelques autres valent la peine d’être connus : keep_dialect préserve le dialecte au lieu de normaliser vers le mandarin standard, speech_noise_threshold ajuste le seuil parole/bruit, vocabulary_id attache une liste de mots-clés précompilée (un gain de précision important pour les noms de produits et le jargon), et language_hints accepte jusqu’à quatre indications de langue. Tout ce qui n’a pas de clé de configuration dédiée peut être transmis en bloc via un dictionnaire parameters.
Définissez aussi la langue explicitement. La valeur globale par défaut de Hermes est en, pour une bonne raison — la détection automatique de Whisper se trompe sur les clips courts. Pour de l’entrée en chinois :
hermes config set stt.language zhLes clés non définies sous stt.dashscope retombent sur les valeurs par défaut. L’endpoint pointe par défaut sur https://maas.qianwenaiapi.com/api/v1 ; donnez-lui une adresse HTTP et le plugin substitue lui-même l’endpoint du direct. Les adresses compatibles OpenAI (avec /compatible-mode/v1) fonctionnent aussi, puisque le SDK ne lit que le nom d’hôte. workspace n’est utilisé que si vous le définissez.
Où va l’audio
Soyons clairs : l’audio et la clé d’API partent vers l’endpoint que vous avez configuré — la Qwen AI Platform par défaut — et rien d’autre ne quitte la machine. En local, il y a un wav temporaire utilisé pour le transcodage, supprimé après l’appel. C’est un appel cloud. Si les enregistrements sont sensibles, restez sur Whisper local ou vérifiez que ce chemin correspond à vos règles de conformité avant de basculer.
Comment revenir en arrière
Deux commandes :
hermes config set stt.provider local
hermes plugins disable transcription-dashscope
Vous en aurez besoin dans trois cas : le compte n’a plus de crédit ou le modèle n’est pas activé (Arrearage: Access denied) ; l’audio est trop long — ce modèle vise les clips courts et la reconnaissance de conversation, donc une interview d’une heure réclame un modèle dédié à la transcription de fichiers ; ou vous ne voulez tout simplement pas que l’audio quitte la machine.
Une dernière chose à savoir d’emblée : l’interface vocale du SDK 2.0 est officiellement étiquetée preview. Après toute mise à jour du SDK, envoyez un message vocal et confirmez qu’il est toujours transcrit, plutôt que de découvrir la casse pendant une réunion importante.
Est-ce que le changement vaut le coup
Si votre entrée vocale est surtout du chinois, à volume modéré, et que vous préférez éviter de faire tourner Whisper en local, c’est un bon compromis : deux commandes d’installation, quatre lignes de configuration, et la plateforme gère le reste. Cela ne change rien au-dessus de la couche STT — les transcriptions arrivent toujours dans la session et déclenchent toujours les mêmes appels d’outils ; seules les oreilles changent.
Si votre audio est surtout de l’anglais, ou si la confidentialité est la contrainte, Whisper local intégré reste l’option la plus tranquille, au prix d’un premier chargement lent et d’un CPU sollicité en continu. Pour rogner le silence avant l’envoi et décharger le modèle au repos, le guide sur le rognage du silence et le déchargement à l’inactivité va plus loin. La moitié sortante — la synthèse vocale — est traitée dans le guide du sélecteur de voix.