Seu agente só vê um nome de arquivo: trocando o speech-to-text do Hermes pelo Qwen
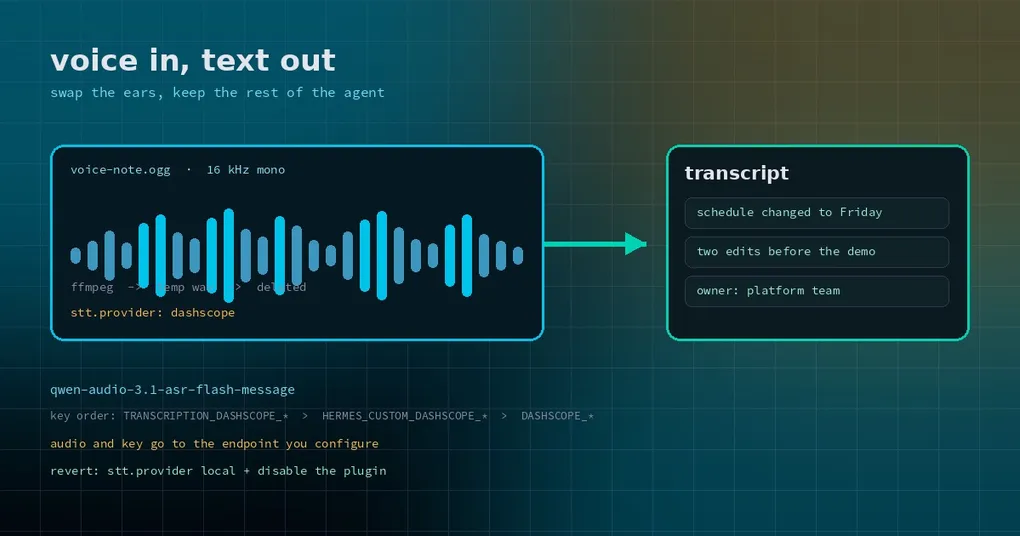
Um parceiro te manda um áudio de dois minutos e meio: o cronograma, mais duas coisas a mudar. Você encaminha para o Hermes e pede uma lista de tarefas. Ele responde que recebeu um arquivo de áudio e então pergunta o que havia nele. Do ponto de vista do agente, foi exatamente isso que ele recebeu — um .ogg.
Notas de voz são a entrada mais comum que um agente descarta em silêncio. O Hermes tem uma camada de fala para texto com uma opção Whisper local e vários backends na nuvem, e cada um tem um preço: o Whisper local consome CPU e demora para carregar; backends na nuvem pedem uma chave em uma rede que você talvez não tenha, ou uma conta por minuto. Se seu time já vive no stack Qwen/Alibaba, agora existe um terceiro caminho — o plugin da comunidade transcription-dashscope, que liga o STT do Hermes ao Qwen-Audio-ASR na Qwen AI Platform (DashScope).
Qual camada ele substitui
O Hermes divide voz em duas metades independentes: stt.* transforma som em texto, tts.* transforma texto em som. Por padrão, stt.enabled está ligado, e echo_transcripts também — o gateway transcreve uma mensagem de voz recebida e devolve a transcrição como uma mensagem 🎙️.
O backend é plugável. O core traz vários (Whisper local, Groq, OpenAI, Mistral, ElevenLabs, DeepInfra, xAI), e plugins podem registrar nomes de provedor adicionais. Este plugin registra dashscope, então a única coisa que você muda é stt.provider.
Ele cobre dois fluxos: transcrição automática de mensagens de voz do gateway, e ditado no Desktop ou na CLI com texto parcial ao vivo quando stt.streaming está ligado. O modelo padrão é qwen-audio-3.1-asr-flash-message.
Três coisas antes de instalar
Uma chave de API da Qwen AI Platform. Nada funciona sem ela.
ffmpeg na máquina. O plugin usa para normalizar toda gravação em 16 kHz mono — a taxa que o endpoint de transcrição ao vivo aceita, e não o que arquivos de voz do Telegram ou do WhatsApp costumam usar. A conversão grava um wav temporário e o apaga depois.
Um Hermes recente o suficiente. A entrada do catálogo exige >=0.22.5. Não force em uma build antiga; atualize primeiro.
Depois instale na ordem:
hermes plugins install transcription-dashscope
hermes plugins enable transcription-dashscope
hermes gateway restart
O restart não é opcional. O plugin traz dependências Python, e o processo em execução ainda não as carregou. Pule esse passo e o próximo comando falha com algo como DashScope SDK is not importable in this process — isso não é uma instalação quebrada, é um processo que ainda não trocou de código.
Quatro linhas para ligar
Coloque a chave no .env do perfil:
DASHSCOPE_API_KEY=sk-your-keyO plugin lê três variáveis, da maior para a menor prioridade: TRANSCRIPTION_DASHSCOPE_API_KEY (específica do plugin), HERMES_CUSTOM_DASHSCOPE_API_KEY (o conjunto de provedor customizado) e DASHSCOPE_API_KEY (o provedor Alibaba nativo). Qualquer uma serve, então uma configuração Alibaba já existente não precisa de chave nova.
Aponte o STT para ele:
hermes config set stt.provider dashscope
hermes config set stt.enabled true
hermes config set stt.streaming true
stt.streaming é o modo “o texto aparece enquanto você fala”. Se você só precisa transcrever mensagens de voz, deixe false — isso também remove o ruído das revisões no meio da frase.
Os ajustes que importam para áudio real
O modelo padrão lida bem com mandarim, mas gravações reais têm vícios de linguagem, sotaques e ruído de fundo. O plugin repassa os parâmetros de reconhecimento do DashScope, e três valem a pena definir no primeiro dia:
hermes config set stt.dashscope.disfluency_removal_enabled true
hermes config set stt.dashscope.max_sentence_silence 400
hermes config set stt.dashscope.vad_model near_meeting_16kdisfluency_removal_enabledremove “hum”, “tipo”, “sabe”. Vale a pena para notas de reunião.max_sentence_silenceé quanto tempo uma pausa precisa durar para encerrar uma frase, em milissegundos. Aumente para falantes lentos e cheios de pausas e a segmentação fica menos picada.vad_modelescolhe o modelo de atividade de voz usado na segmentação. Um modelo de campo próximo para reunião, comonear_meeting_16k, é mais estável do que um genérico em uma sala.
Mais alguns que vale conhecer: keep_dialect preserva o dialeto em vez de normalizar para o mandarim padrão, speech_noise_threshold ajusta o corte entre fala e ruído, vocabulary_id anexa uma lista de hotwords pré-compilada (um salto grande de precisão para nomes de produtos e jargão), e language_hints aceita até quatro dicas de idioma. Tudo o que não tiver chave de configuração dedicada pode ser passado inteiro por um dicionário parameters.
Defina o idioma explicitamente também. O padrão global do Hermes é en, por um bom motivo — a detecção automática do Whisper erra em clipes curtos. Para entrada em chinês:
hermes config set stt.language zhChaves não definidas em stt.dashscope caem nos padrões. O endpoint padrão é https://maas.qianwenaiapi.com/api/v1; dê um endereço HTTP e o plugin troca para o endpoint ao vivo por conta própria. Endereços compatíveis com OpenAI (com /compatible-mode/v1) também funcionam, já que o SDK só lê o hostname. workspace só é usado quando você o define.
Para onde o áudio vai
Seja claro quanto a isto: o áudio e a chave de API vão para o endpoint que você configurou — a Qwen AI Platform por padrão — e nada mais sai da máquina. Localmente há um wav temporário usado para transcodificar, apagado após a chamada. Esta é uma chamada na nuvem. Se as gravações são sensíveis, fique no Whisper local ou confirme que o caminho atende às suas regras de compliance antes de trocar.
Como voltar atrás
Dois comandos:
hermes config set stt.provider local
hermes plugins disable transcription-dashscope
Você vai querer isso em três casos: a conta está sem crédito ou o modelo não está habilitado (Arrearage: Access denied); o áudio é longo demais — este modelo mira clipes curtos e reconhecimento em nível de conversa, então uma entrevista de uma hora quer um modelo dedicado a transcrição de arquivos; ou você simplesmente não quer áudio saindo da máquina.
Mais uma coisa para saber de antemão: a interface de voz do SDK 2.0 está oficialmente marcada como preview. Depois de qualquer upgrade do SDK, envie uma mensagem de voz e confirme que ele ainda transcreve, em vez de descobrir a quebra durante uma reunião importante.
Vale a pena trocar
Se sua entrada de voz é majoritariamente chinês, com volume não muito alto, e você prefere não rodar o Whisper localmente, esta é uma boa troca: dois comandos de instalação, quatro linhas de configuração, e a plataforma cuida do resto. Isso não muda nada acima da camada de STT — as transcrições continuam caindo na sessão e continuam disparando as mesmas chamadas de ferramentas; só os ouvidos são diferentes.
Se seu áudio é majoritariamente inglês, ou a privacidade é a restrição, o Whisper local nativo continua sendo a opção mais tranquila, ao custo de um primeiro carregamento lento e CPU constante. Para cortar silêncio antes do upload e descarregar o modelo quando ocioso, o guia de corte de silêncio e descarregamento ocioso do STT vai mais fundo. A metade da saída — texto para fala — está no guia de escolha de voz.