Tres personajes, una garganta: elegir voz de ElevenLabs por llamada en Hermes
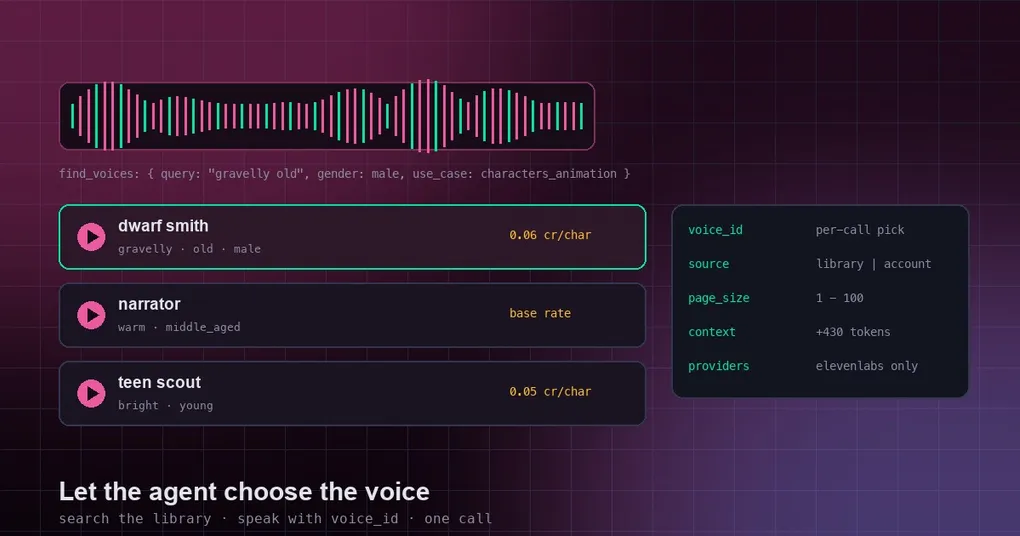
Estás doblando un corto de dos minutos. El guion tiene tres voces: un herrero con una voz como un cubo de carbón, un narrador que suena a cartela de museo y una niña con una sola frase que tiene que sonar a once años. Pegas todo en Hermes y pides audio. Vuelve en una sola voz, la misma para los tres, porque la herramienta de voz tenía exactamente una que darte: la que hubiera en tu config. Para cambiarla editabas tts.elevenlabs.voice_id, reiniciabas y probabas otra vez. Y para saber qué ID escribir, abrías la web de ElevenLabs y hacías scroll por unos cientos de tarjetas de voz, copiando cadenas a mano.
Dos campos nuevos cierran ese hueco. En el provider de ElevenLabs, text_to_speech acepta ahora un voice_id por llamada y un objeto find_voices que convierte la misma herramienta en un buscador de voces. Ni herramienta nueva ni provider nuevo: dos campos en un esquema que ya tienes.
La configuración que esto sustituye
Text-to-speech es la parte simple: le pasas una cadena a un modelo y te devuelve el audio de esa cadena leída. Hermes no tiene voces propias; llama a un provider alojado. ElevenLabs es uno de ellos, se selecciona con tts.provider: elevenlabs y se configura en el bloque tts.
La Voice Library es la parte desordenada: el catálogo público de voces compartidas de ElevenLabs, miles de entradas, cada una con un ID, un nombre, etiquetas descriptivas y un clip de muestra corto. Al lado está el catálogo de tu cuenta: los presets más todo lo que hayas guardado, clonado o diseñado. Antes de este cambio, ninguno de los dos era alcanzable desde dentro de una llamada a herramienta: el modelo podía hablar, pero no mirar.
Una voz como decisión de despliegue —fijada una vez en la config, como un modelo por defecto— encaja en un asistente que lee notificaciones. Se rompe en cuanto hay diálogo: un guion son muchos hablantes, y nadie reinicia un proceso entre dos frases.
Dos campos en la herramienta que ya tienes
El requisito es el interruptor del provider:
tts:
  provider: elevenlabs
  elevenlabs:
    voice_id: 'YOUR_DEFAULT_VOICE_ID'
voice_id en tiempo de llamada elige la voz solo para esa llamada. La regla es estricta en ambos sentidos: si lo omites, se usa la config; si lo pasas, el valor aplica a esa síntesis y a ninguna más. Un valor por llamada nunca reescribe tu config, así que la siguiente llamada vuelve al valor por defecto salvo que vuelvas a pasar una voz.
{
  "text": "Coal is hot. Speak your piece while it holds.",
  "voice_id": "YOURCHOSENVOICEID"
}
Eso es toda la función para una frase. La mitad difícil es encontrar el ID: una cadena alfanumérica de 20 caracteres no se adivina, y los nombres de la biblioteca no son lo bastante únicos como para fiarse.
Buscar en vez de hablar
find_voices es un objeto, y pasarlo da la vuelta a la herramienta: de hablar a buscar. Es la única configuración en la que text se vuelve opcional en esta variante, porque una búsqueda no tiene nada que decir. Hay dos catálogos detrás del interruptor:
source: library(por defecto) llama aGET /v1/shared-voices, la Voice Library pública. Esas voces funcionan directamente porvoice_idsin guardarlas antes en tu cuenta, pero la API de ElevenLabs solo permite usarlas en planes de pago.source: accountllama aGET /v2/voicesy cubre los presets más todas las voces que hayas guardado, clonado o diseñado.
{
  "find_voices": {
    "query": "gravelly old",
    "gender": "male",
    "age": "old",
    "language": "en",
    "use_case": "characters_animation",
    "page_size": 10
  }
}
Los filtros se reparten por catálogo:
| Campo | Dónde aplica | Notas |
|---|---|---|
query |
ambos | Coincidencia literal de palabras en nombre y descripción, no semántica |
gender |
ambos | Etiqueta de filtro |
age |
ambos | Etiqueta de filtro |
accent |
ambos | Etiqueta de filtro |
language |
ambos | Etiqueta de filtro |
use_case |
solo library | Por ejemplo characters_animation |
sort |
solo library | Por defecto usage_character_count_1y; también trending, cloned_by_count, created_date |
page_size |
ambos | De 1 a 100, 20 por defecto |
source |
ambos | library por defecto, o account |
use_case acota a voces grabadas para animación de personajes en vez de narración corporativa, que es otro registro vocal.
Los resultados van página a página. next_page devuelve un cursor opaco que el modelo reenvía tal cual como page; por debajo, el endpoint de cuenta usa un next_page_token y la biblioteca usa números de página, y por eso el cursor sigue siendo opaco para ti.
Cada fila lleva el id, un nombre, traits, una category, una descripción truncada a 240 caracteres y un preview_url. Las voces de la biblioteca que facturan por encima de la tarifa por defecto llevan además credit_rate. La página entera informa de configured_voice_id, la voz que hay ahora en tu config: un detalle pequeño con valor real, porque permite al modelo no recomendarte justo la voz que ya escuchas todos los días.
Un herrero enano, elegido de verdad
El pull request recoge una ejecución contra la API real: una key de ElevenLabs de verdad, eleven_v4, google/gemini-3.8-flash en la API de inferencia de Nous y un proceso hermes chat -Q auténtico del lado del agente. La tarea era un personaje: encontrar una voz para un herrero enano curtido y usarla para decir una frase. La primera consulta que escribió el modelo:
{
  "query": "dwarf blacksmith gravelly",
  "age": "old",
  "gender": "male",
  "use_case": "characters_animation"
}
No volvió nada utilizable. La biblioteca busca palabras literales en nombres y descripciones, así que un nombre de rol como dwarf es una apuesta sobre unos metadatos que en su mayoría no existen: los catálogos de voz describen timbre, no personajes.
Así que el modelo cambió de estrategia: de describir a la persona pasó a describir el sonido —gravelly, gruff y parecidos— manteniendo los filtros de edad y género. Eso sí produjo candidatos. Comparó traits y las descripciones truncadas con la escena, comprobó configured_voice_id para no devolver la voz que ya estaba en uso, y entonces llamó a text_to_speech con el voice_id elegido y la frase.
De esa ejecución salen dos hábitos. Describe el sonido, no el rol: si una búsqueda por personaje vuelve vacía, no añadas más palabras de personaje, cambia a adjetivos sobre la voz y acota con filtros. Y el modelo no oye: lee texto sobre audio, así que cuando la elección importa te pasa enlaces preview_url. Una voz elegida sin escucharla es un borrador, no una decisión.
Lo que deliberadamente no tocó
Los dos campos los inyecta el hook de esquema dinámico que ya existía, _tts_schema_overrides, que lee tu config cada vez que se listan las definiciones de herramientas. El hook no es nuevo; solo creció su rama de ElevenLabs.
Los límites son estrechos, y por eso esto es un cambio pequeño y no una bifurcación de comportamiento:
- Los esquemas de
text_to_speechpara Edge, OpenAI, xAI y el resto son idénticos byte a byte a los demain, y la instantánea del prompt por defecto del provider no cambia. - Mandar
voice_ida otro provider te da un aviso y el argumento se ignora; la llamada sigue produciendo audio. Eso importa en un escenario exacto: guardaste un esquema en caché y luego cambiaste de provider. - Mandar
find_voicesa otro provider falla limpiamente con un error que dice que necesitatts.provider: elevenlabs. Sin caída silenciosa a hablar. - Un ID mal formado se rechaza antes de que salga ninguna petición del proceso, contra
^[A-Za-z0-9]{8,64}$.
El coste en contexto es donde quienes no usan ElevenLabs pueden relajarse. Medido con get_tool_definitions, el esquema de text_to_speech en una sesión de ElevenLabs crece de unos 410 tokens a unos 840. En cualquier otra sesión el coste es de 0 tokens, porque las adiciones nunca entran en el esquema.
Dos arreglos vecinos llegaron en el mismo lote: find_voices={} dejó de caer a hablar y ahora significa navegar, y en el gateway de audio gestionado tts-1 y tts-1-hd ya no se degradan sin avisar.
Tres trampas
Las voces de la biblioteca son función de plan de pago. Sintetizar con un voice_id de biblioteca sin guardarlo en tu cuenta es realmente cómodo, pero la ruta de la API exige un plan de ElevenLabs de pago. Con una key gratuita, la búsqueda puede devolver filas que la llamada de síntesis no puede usar. El credit_rate en una fila es la señal de que esa voz factura por encima de la tarifa por defecto.
Un buen nombre no es una buena voz. Los nombres de la biblioteca los escribe el usuario: dos voces llamadas algo así como “Deep Narrator” pueden diferir muchísimo en ritmo, respiración y consonantes. Escucha el preview_url: una voz encantadora durante veinte segundos puede ser insoportable a lo largo de cuatro minutos de diálogo.
El cursor no lo montas tú. Pasa de página devolviendo next_page como page, literal. Reconstruir un offset, o reutilizar un cursor del catálogo de cuenta contra la biblioteca, te da duplicados o una página en blanco sin ninguna explicación.
Qué necesitas para probarlo
El cambio se fusionó el 2026-10-25, después de que v0.22.5 saliera el 2026-10-23. Está en main y no en una release etiquetada, así que una instalación normal de la última release no tendrá ninguno de los dos campos. Para probarlo ahora tienes que correr desde main; la guía de instalación cubre el camino desde el código fuente.
A partir de ahí el flujo es corto: busca por timbre, escucha dos o tres clips de preview_url, guarda los IDs que te gusten y pásalos por llamada. La config se queda donde estaba, así que una voz para notificaciones y tres para el corto conviven en la misma instalación, con el mismo principio que los overrides de modelo por llamada, donde una elección puntual nunca muta los valores por defecto en los que confías.
Si la latencia se convierte en el siguiente problema cuando el reparto esté resuelto, la mecánica para mantener un pipeline de síntesis caliente y en streaming en los límites de frase está en la guía de keep-warm y streaming por frases; elegir voz no cambia nada de esa fontanería. Y meter la voz en una conversación de ida y vuelta en lugar de una lectura puntual es otra decisión distinta: mira la guía de modelos de chat de voz.