Drei Figuren, eine Kehle: pro Aufruf eine ElevenLabs-Stimme in Hermes wählen
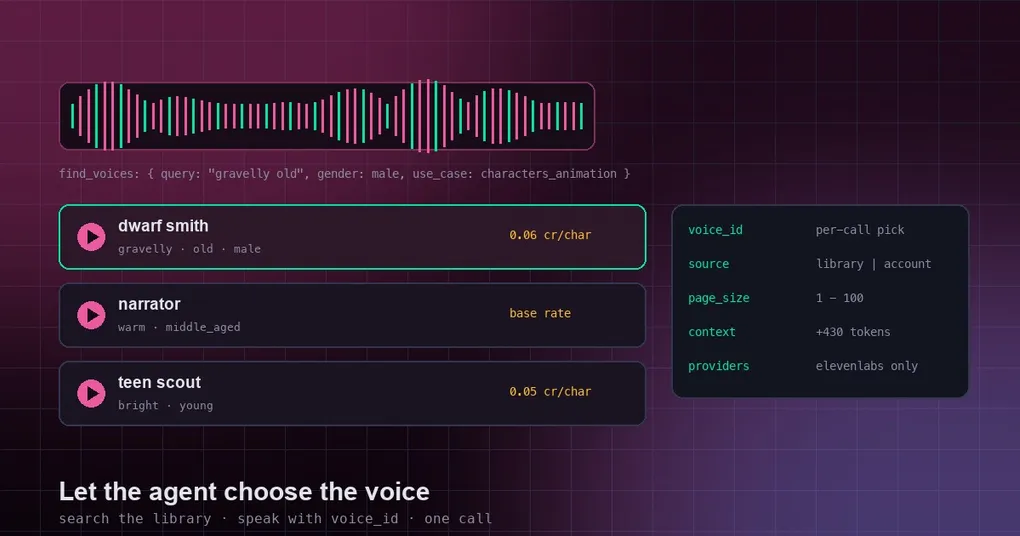
Du vertonst einen Kurzfilm von zwei Minuten. Das Skript hat drei Sprecher: einen Schmied mit einer Stimme wie ein Kohleeimer, einen Erzähler, der wie ein Museumsschild klingt, und ein Mädchen mit einer einzigen Zeile, das nach elf Jahren klingen muss. Du wirfst alles in Hermes und bittest um Audio. Es kommt in einer Stimme zurück — dieselbe für alle drei, weil das Sprachwerkzeug genau eine anzubieten hatte: die aus deiner Config. Um sie zu ändern, hast du tts.elevenlabs.voice_id bearbeitet, neu gestartet und es erneut versucht. Und um zu wissen, welche ID du eintippen musst, hast du die ElevenLabs-Seite geöffnet, ein paar hundert Stimmkarten durchgescrollt und Strings von Hand kopiert.
Zwei neue Felder schließen diese Lücke. Beim provider ElevenLabs akzeptiert text_to_speech jetzt eine voice_id pro Aufruf und ein find_voices-Objekt, das dasselbe Werkzeug in eine Stimmensuche verwandelt. Kein neues Werkzeug, kein neuer provider — zwei Felder in einem Schema, das du längst hast.
Das Setup, das hier abgelöst wird
Text-to-Speech ist der harmlose Teil: du gibst einem Modell einen String, es gibt dir Audio davon zurück. Hermes hat keine eigenen Stimmen; es ruft einen gehosteten provider auf. ElevenLabs ist einer davon, gewählt mit tts.provider: elevenlabs und konfiguriert im tts-Block.
Die Voice Library ist der unordentliche Teil: ElevenLabs’ öffentlicher Katalog geteilter Stimmen, Tausende Einträge, jede mit einer ID, einem Namen, beschreibenden Labels und einem kurzen Vorschau-Clip. Daneben liegt dein Konto-Katalog — die Presets plus alles, was du gespeichert, geklont oder entworfen hast. Vor dieser Änderung war beides aus einem Tool-Aufruf heraus nicht erreichbar: das Modell konnte sprechen, aber nicht schauen.
Eine Stimme als Deployment-Entscheidung — einmal in der Config gesetzt, wie ein Standardmodell — passt zu einem Assistenten, der Benachrichtigungen vorliest. Sobald es Dialog gibt, bricht das: ein Skript hat viele Sprecher, und niemand startet einen Prozess zwischen zwei Zeilen neu.
Zwei Felder am Werkzeug, das du schon hast
Voraussetzung ist der provider-Schalter:
tts:
  provider: elevenlabs
  elevenlabs:
    voice_id: 'YOUR_DEFAULT_VOICE_ID'
voice_id zur Aufrufzeit wählt die Stimme nur für diesen Aufruf. Die Regel ist in beide Richtungen streng: lässt du es weg, gilt die Config; gibst du es an, gilt der Wert für diese eine Synthese. Ein Wert pro Aufruf schreibt deine Config nie um, der nächste Aufruf landet also wieder beim Standard, solange du nicht erneut eine Stimme übergibst.
{
  "text": "Coal is hot. Speak your piece while it holds.",
  "voice_id": "YOURCHOSENVOICEID"
}
Das ist das ganze Feature für eine Zeile. Die schwierigere Hälfte ist, die ID zu finden: ein alphanumerischer String mit 20 Zeichen ist nicht zu erraten, und Bibliotheksnamen sind nicht eindeutig genug, um ihnen zu trauen.
Suchen statt Sprechen
find_voices ist ein Objekt, und wenn du es übergibst, kippt das Werkzeug von sprechen auf suchen — die einzige Konfiguration, in der text bei dieser Variante optional wird, denn eine Suche hat nichts zu sagen. Hinter dem Schalter liegen zwei Kataloge:
source: library(Standard) ruftGET /v1/shared-voicesauf, die öffentliche Voice Library. Diese Stimmen funktionieren direkt über dievoice_id, ohne sie vorher im Konto zu speichern, aber die ElevenLabs-API erlaubt ihre Nutzung nur in bezahlten Tarifen.source: accountruftGET /v2/voicesauf und deckt die Presets plus jede Stimme ab, die du gespeichert, geklont oder entworfen hast.
{
  "find_voices": {
    "query": "gravelly old",
    "gender": "male",
    "age": "old",
    "language": "en",
    "use_case": "characters_animation",
    "page_size": 10
  }
}
Die Filter teilen sich nach Katalog auf:
| Feld | Wo es greift | Hinweise |
|---|---|---|
query |
beide | Wörtlicher Worttreffer in Name und Beschreibung, nicht semantisch |
gender |
beide | Filter-Label |
age |
beide | Filter-Label |
accent |
beide | Filter-Label |
language |
beide | Filter-Label |
use_case |
nur library | Zum Beispiel characters_animation |
sort |
nur library | Standard usage_character_count_1y; auch trending, cloned_by_count, created_date |
page_size |
beide | 1 bis 100, Standard 20 |
source |
beide | standardmäßig library, oder account |
use_case grenzt auf Stimmen ein, die für Charakteranimation aufgenommen wurden statt für Unternehmenspräsentationen — ein anderes Stimmlagen-Register.
Ergebnisse kommen seitenweise. next_page liefert einen undurchsichtigen Cursor, den das Modell unverändert als page zurückgibt; darunter nutzt der Konto-Endpunkt ein next_page_token und die Library Seitennummern — deshalb bleibt der Cursor für dich undurchsichtig.
Jede Zeile trägt die id, einen Namen, traits, eine category, eine auf 240 Zeichen gekürzte Beschreibung und eine preview_url. Library-Stimmen, die über dem Standardsatz abgerechnet werden, tragen zusätzlich credit_rate. Die Seite als Ganzes meldet configured_voice_id, die aktuell in deiner Config stehende Stimme — ein kleines Detail mit echtem Wert, weil das Modell so vermeiden kann, dir die Stimme zu empfehlen, die du ohnehin jeden Tag hörst.
Ein Zwergenschmied, tatsächlich ausgewählt
Der Pull Request hält einen Lauf gegen die echte API fest: ein echter ElevenLabs-Key, eleven_v4, google/gemini-3.8-flash auf der Nous Inference API und ein tatsächlicher hermes chat -Q-Prozess auf der Agentenseite. Die Aufgabe war eine Figur — finde eine Stimme für einen wettergegerbten Zwergenschmied und lass sie dann eine Zeile sprechen. Die erste Abfrage, die das Modell schrieb:
{
  "query": "dwarf blacksmith gravelly",
  "age": "old",
  "gender": "male",
  "use_case": "characters_animation"
}
Nichts Brauchbares kam zurück. Die Library gleicht wörtliche Wörter in Namen und Beschreibungen ab, ein Rollenname wie dwarf ist also eine Vermutung über Metadaten, die meistens nicht existieren: Stimmkataloge beschreiben Timbre, nicht Figuren.
Also wechselte das Modell vom Beschreiben der Person zum Beschreiben des Klangs — gravelly, gruff und Ähnliches —, mit weiterhin gesetzten Alters- und Geschlechtsfiltern. Das brachte Kandidaten. Es verglich traits und die gekürzten Beschreibungen mit der Szene, prüfte configured_voice_id, damit es nicht die bereits genutzte Stimme zurückgab, und rief dann text_to_speech mit der gewählten voice_id und der Zeile auf.
Zwei Gewohnheiten folgen aus diesem Lauf. Beschreibe den Klang, nicht die Rolle — kommt eine Figurensuche leer zurück, hänge keine weiteren Figurenwörter an; wechsle zu Adjektiven über die Stimme und grenze mit Filtern ein. Und das Modell kann nicht hören: es liest Text über Audio, wenn die Wahl zählt, reicht es dir also preview_url-Links. Eine Stimme, die ohne Zuhören ausgewählt wurde, ist ein Entwurf, keine Entscheidung.
Was es bewusst nicht angefasst hat
Beide Felder werden vom bestehenden Hook für dynamische Schemata injiziert, _tts_schema_overrides, der deine Config jedes Mal liest, wenn Tool-Definitionen aufgelistet werden. Der Hook ist nicht neu; nur sein ElevenLabs-Zweig ist gewachsen.
Die Grenzen sind eng, und deshalb ist das eine kleine Änderung statt einer Verhaltensgabelung:
- Die
text_to_speech-Schemata für Edge, OpenAI, xAI und den Rest sind Byte für Byte identisch mitmain, und der Standard-Prompt-Snapshot des providers ist unverändert. - Schickst du
voice_idan einen anderen provider, bekommst du eine Warnung und das Argument wird ignoriert — der Aufruf erzeugt trotzdem Audio. Das zählt in genau einem Szenario: du hast ein Schema gecacht und dann den provider gewechselt. - Schickst du
find_voicesan einen anderen provider, scheitert es sauber mit einem Fehler, dertts.provider: elevenlabsverlangt. Kein stiller Rückfall aufs Sprechen. - Eine fehlerhafte ID wird abgelehnt, bevor irgendeine Anfrage den Prozess verlässt, geprüft gegen
^[A-Za-z0-9]{8,64}$.
Die Kontextkosten sind der Punkt, an dem alle außer ElevenLabs-Nutzern aufatmen können. Mit get_tool_definitions gemessen wächst das text_to_speech-Schema in einer ElevenLabs-Session von etwa 410 Tokens auf etwa 840. In jeder anderen Session sind die Kosten 0 Tokens, weil die Ergänzungen nie ins Schema gelangen.
Zwei benachbarte Fixes landeten im selben Batch: find_voices={} fällt nicht mehr aufs Sprechen durch und bedeutet jetzt durchstöbern, und auf dem verwalteten Audio-gateway werden tts-1 und tts-1-hd nicht mehr still herabgestuft.
Drei Fallen
Library-Stimmen sind ein Bezahltarif-Feature. Mit einer Library-voice_id zu synthetisieren, ohne sie im Konto zu speichern, ist wirklich bequem, aber der API-Pfad verlangt einen bezahlten ElevenLabs-Tarif. Mit einem kostenlosen Key kann die Suche weiterhin Zeilen liefern, die der Synthese-Aufruf nicht nutzen kann. Ein credit_rate in einer Zeile ist das Signal, dass die Stimme über dem Standardsatz abgerechnet wird.
Ein guter Name ist keine gute Stimme. Library-Namen sind von Nutzern geschrieben: zwei Stimmen namens irgendetwas wie „Deep Narrator“ können sich in Tempo, Atem und Konsonanten massiv unterscheiden. Hör dir die preview_url an — eine Stimme, die zwanzig Sekunden lang wunderschön ist, kann über vier Minuten Dialog unerträglich werden.
Der Cursor ist nicht zum Zusammensetzen gedacht. Blättere durch Ergebnisse, indem du next_page wörtlich als page zurückgibst. Ein Offset zu rekonstruieren oder einen Cursor aus dem Konto-Katalog gegen die Library zu verwenden, beschert dir Duplikate oder eine leere Seite ohne Erklärung.
Was du zum Ausprobieren brauchst
Die Änderung wurde am 25.10.2026 gemergt, nachdem v0.22.5 am 23.10.2026 erschienen ist. Sie liegt auf main und nicht in einem getaggten Release, eine Standardinstallation der neuesten Version hat also keines der beiden Felder. Um es jetzt zu testen, läufst du aus main; die Installationsanleitung deckt den Weg über den Quellcode ab.
Danach ist der Workflow kurz: nach Timbre suchen, zwei oder drei preview_url-Clips anhören, die IDs behalten, die dir gefallen, sie pro Aufruf übergeben. Die Config bleibt, wo sie war, eine Stimme für Benachrichtigungen und drei für den Kurzfilm koexistieren also im selben Setup — dasselbe Prinzip wie bei Modell-Overrides pro Aufruf, wo eine einmalige Auswahl die Standards, auf die du dich verlässt, nie verändert.
Wird Latenz das nächste Problem, sobald die Besetzung steht, findest du die Mechanik, eine Synthese-Pipeline warm zu halten und an Satzgrenzen zu streamen, in der Anleitung zu Keep-Warm und Sentence-Streaming; die Wahl einer Stimme ändert an dieser Mechanik nichts. Und Sprache in eine Zwei-Wege-Unterhaltung statt in ein einmaliges Rendering einzubinden, ist eine eigene Entscheidung — siehe die Anleitung zum Voice-Chat-Modell.