一次 tool_call 塞三个工具不再被拒:Hermes 学会了拆批次
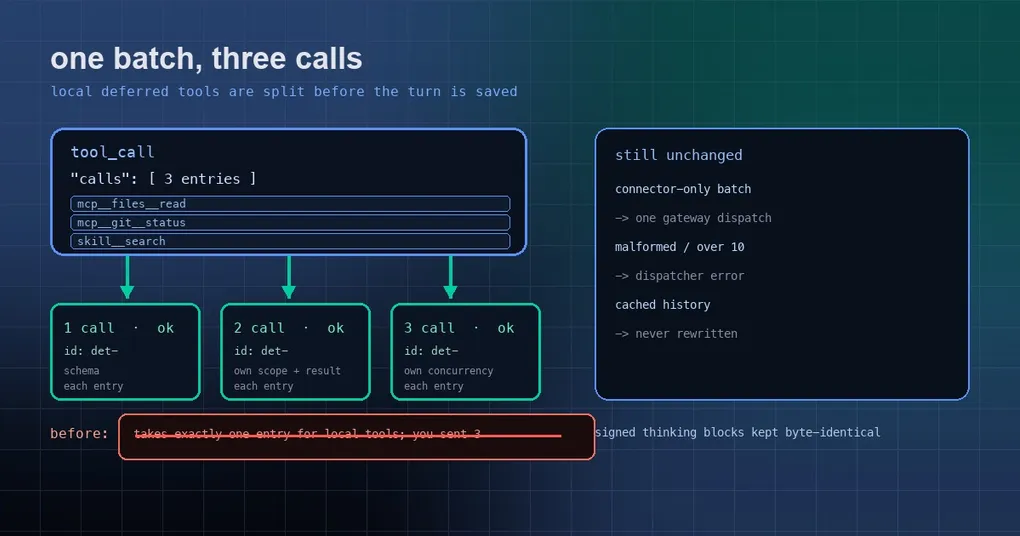
你给 Hermes 挂了三个 MCP 服务:一个读文件、一个查 git、还有一个连公司工单系统。这天你让它「把这几个文件看一遍,顺手报个工单」,它在一次 tool_call 里塞进了三条记录。你以为会看到三份结果,实际看到的是一行纠正提示,和一轮白等的对话——它不得不从头再来一遍,一条一条重新调用。
这个坑在 PR #131249 里被补上了:Agent 现在会在保存这一轮消息之前,先把批次拆成一条条独立调用。下面把机制、边界和你能感知到的变化讲清楚。
那条报错从哪来
要理解这条报错,先要知道 Hermes 的 MCP 和插件工具默认是「延迟加载」的。它们不进系统提示的常驻名单,需要时由模型先用 tool_search 找到准确名字,再用 tool_call 调用——这叫 bridge,好处是省 token,机制在工具搜索多查询指南里讲过。
而 tool_call 的 calls 参数是个数组,于是一个很自然的想法就出现了:既然是个数组,那我一次塞三条不行吗?
在修复之前,答案是不行。旧契约是「connectors 可以批量,本地工具一次一条」,模型要是把两个以上的本地工具塞进同一个批次,Hermes 会把它整条退回去,并附上一句纠正:
tool_call takes exactly one entry for local tools; you sent 2.
Retry with only: {"calls":[{"name":"mcp__files__read","arguments":{...}}]}...
这句话本身没错,代价却不小:模型得重新思考、重新发起一轮请求。PR 作者在真实会话里量过这个代价——同样是「两个条目的本地批次」,修复前是被拒后退化成单条重试,整轮花掉 9 条消息、33 秒;修复后拆开执行,7 条消息、16 秒。省下的基本都是模型重新推理的时间。
现在的做法:在写进历史之前先拆开
修复的思路很朴素:与其让派发层拒绝它,不如在更早的地方把它拆开。
具体实现是新文件 agent/tool_call_batches.py,入口函数 expand_local_tool_batches(),在 agent/turn_tool_round.py 里被调用一次——位置很关键:在这条助手消息被持久化之前。于是它只动「还没写进历史」的这一轮,缓存过的历史永远不会被改写。
拆开之后,每个条目走的是普通工具调用的完整路径,而不是套一层桥:
- 作用域检查(scope)、schema 校验、参数解析;
pre_tool_call钩子和安全护栏;- 审批按条目各自结算,一条被拒不会拖着另一条;
- 按底层工具自己的并发策略执行,该并行的照旧并行;
- 每条独立配对结果、独立增量写入。
还有两个容易被忽略但很关键的细节:
子调用的 id 是确定性的。 第一条沿用父调用,后面几条用 deterministic_call_id() 根据父 id、参数和序号生成。这样同一批请求重放时 id 稳定,不会每次重试都让会话记录看起来像换了一批调用。
原生 provider 的有序块就地重写。 Anthropic 和 Bedrock 不是从 tool_calls 重建历史,而是回放有序的 content block。这里对 block 列表做的是原地替换:签名过的 thinking block 保持逐字节不变,顺序也不动。这对开了加密推理的模型很重要,改了签名就等于让服务端拒绝整段历史。
什么仍然会被拦下来
拆分只针对「能拆、该拆」的批次,剩下几种情况保持原样:
| 情况 | 行为 |
|---|---|
全是 connectors__ 的批次 |
仍然作为一次网关派发,形状不变 |
| 畸形批次(解析失败、条目不是对象) | 留给派发器报错 |
| 条目数超过 10 | 留给派发器报错(上限常量 MAX_CALLS_PER_DISPATCH = 10) |
| 单条目调用 | 契约不变,和以前一样 |
所以那句老报错字符串并没有从代码里消失——在 tools/tool_search_validation.py 里它还在,只是现在服务的是绕过拆分路径的调用方,正常对话轮不会再撞上它。这种「旧路径保留、新路径分流」的做法,比一刀切删掉容错更稳妥。
你能感知到的四个变化
模型侧的说明书变了。 tool_call 的工具描述里,原来写的是「本地延迟工具每次只能一个」,现在写的是「本地条目会由 agent 拆成独立调用、各自遵循并发策略」。官网的 tool-search 文档同步改了口径。模型不会主动违反一条它已经不知道存在的规则。
钩子按条目触发。 如果你写过拦截写操作的 pre_tool_call 插件,以前一个批次要么整体被拒、要么整体放行;现在钩子对每个条目单独触发一次,拿到的是底层工具名和这条自己的 call id。写操作可以被精确拦下,同批次里的读操作照常执行。
结果按输入顺序回来。 三条调用的结果拼回原始顺序,条数也重新计算,不会因为内部拆分开销让顺序错乱。
中途停止更干净。 批次执行到一半你按了 /stop,还没有开始发送的条目不发送,不会留下悬空的调用。
什么时候能用上
这条修复 2026 年 10 月 2 日合入主分支。当前最新正式版是 v0.21.5(tag v2026.9.24),所以这个改动目前只在 main 上,还没进任何正式发布的版本;跟踪 main 的安装下一次 hermes update 就会带上它,正式用户会在下一个 tag 里拿到。
对你来说不需要任何配置——它不是一个开关,而是把默认行为改对了。你真正需要做的只有一件事:重新检查一遍你的 pre_tool_call 钩子。如果你以前为了「反正批次总会被拒」而写得比较宽松,现在钩子会按条目逐个触发,正是收紧写操作拦截的好时机。延迟工具的配置方式见命令参考里的 MCP 一节,MCP 配置与上下文变量的细节可以看这篇配置说明。
小结
一句话总结这次修复:模型可以放心地一次提出多个工具请求了,因为拆分的责任从「模型必须记住的规则」搬到了「agent 一定会执行的路径」上。
这类改动看起来不性感,但它省下的是每一次真实对话里的往返时间——尤其是挂了多个 MCP 服务、模型又偏小的情况下,一次被拒就可能让整轮跑偏。如果你还在用单条调用的写法,也可以借这个机会翻一翻自己的技能和系统提示:那些「一次只能调一个工具」的提醒,已经可以删了。