Drei Tools in einem tool_call sind kein Fehler mehr: Hermes teilt den Batch auf
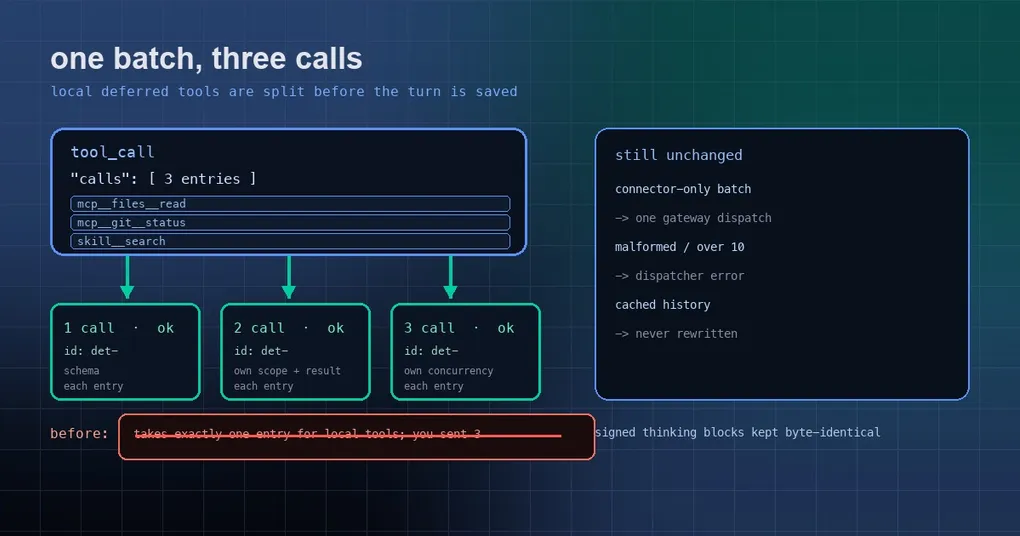
Du hast drei MCP-Server mit Hermes verbunden: einer liest Dateien, einer fragt git ab, einer legt Tickets in deinem Firmen-Tracker an. Also bittest du Hermes, „diese Dateien zu überfliegen und ein Ticket anzulegen“, und er tut, was jeder vernünftige Aufrufer tun würde – er packt drei Einträge in einen einzigen tool_call. Du erwartest drei Ergebnisse. Was du bekommst, ist eine Korrekturmeldung und ein verschwendeter Roundtrip, weil der Agent alles noch einmal durchdenken und die Aufrufe einzeln erneut abschicken muss.
PR #131249 schließt diese Lücke. Der Agent teilt den Batch jetzt in einzelne Aufrufe auf, bevor der Turn persistiert wird. Hier kommen der Mechanismus, die Grenzen und das, was sich für dich tatsächlich ändert.
Woher die Ablehnung kam
Um den Fehler zu verstehen, musst du zuerst wissen, dass Hermes MCP- und Plugin-Tools deferred lädt. Sie stehen nicht in der immer präsenten Tool-Liste – das Modell findet den exakten Namen mit tool_search und ruft es dann über tool_call auf. Das ist ein token-sparendes Design, beschrieben in unserem Tool-Search-Leitfaden.
Das calls-Argument von tool_call ist ein Array, und daraus folgt eine naheliegende Frage: Wenn es ein Array ist, warum dann nicht drei Einträge hineinlegen?
Vor diesem Fix lautete die Antwort: nein. Der alte Vertrag war „Connectors dürfen bündeln, lokale Tools gibt es eines pro Aufruf.“ Ein Modell, das zwei oder mehr lokale Tools in einen Batch packte, bekam alles mit einer Korrektur zurück:
tool_call takes exactly one entry for local tools; you sent 2.
Retry with only: {"calls":[{"name":"mcp__files__read","arguments":{...}}]}...
Die Meldung war korrekt, aber sie war nicht kostenlos. Das Modell musste neu planen und erneut abschicken. Der Autor des PRs hat es an echten Sessions gemessen: Derselbe lokale Batch mit zwei Einträgen kostete vor dem Fix 9 Nachrichten und 33 Sekunden (abgelehnt, als Einzelaufrufe wiederholt) und danach 7 Nachrichten und 16 Sekunden (aufgeteilt und ausgeführt). Fast die gesamte Einsparung entfällt auf die Nachdenkzeit des Modells.
Der Fix: aufteilen vor dem Persistieren
Die Idee ist unspektakulär. Statt den Dispatcher einen Batch ablehnen zu lassen, wird er früher aufgeteilt.
Die Implementierung ist eine neue Datei, agent/tool_call_batches.py, mit dem Einstiegspunkt expand_local_tool_batches(), der einmal aus agent/turn_tool_round.py aufgerufen wird. Die Platzierung ist der wichtige Teil: bevor die Assistant-Nachricht persistiert wird. Es wird nur der noch nicht persistierte Turn angefasst, sodass der gecachte Verlauf niemals umgeschrieben wird.
Nach dem Aufteilen geht jeder Eintrag den normalen Tool-Pfad statt über die Bridge:
- Scope-Prüfung, Schema-Validierung, Argument-Parsing;
pre_tool_call-Hooks und Guardrails;- Approvals werden pro Eintrag abgewickelt – eine Ablehnung reißt die anderen nicht mit;
- die eigene Concurrency-Policy des zugrunde liegenden Tools gilt, sodass parallelfähige Server weiterhin parallel laufen;
- jeder Eintrag bekommt sein eigenes zugehöriges Ergebnis und seinen eigenen inkrementellen Write.
Zwei Details sind wichtiger, als sie aussehen:
Child-Call-IDs sind deterministisch. Der erste Eintrag verwendet den Parent-Call wieder; der Rest bekommt IDs von deterministic_call_id(), abgeleitet aus der Parent-ID, den Argumenten und dem Index. Replays erzeugen dadurch stabile IDs, statt einer Session, die bei jedem Retry ein anderes Set an Tools aufgerufen zu haben scheint.
Native Provider-Blocklisten werden an Ort und Stelle umgeschrieben. Anthropic und Bedrock spielen geordnete Content-Blöcke erneut ab, statt den Verlauf aus tool_calls neu aufzubauen, daher wird die Blockliste an ihrer Position bearbeitet: signierte Thinking-Blöcke bleiben byte-identisch und behalten ihre Reihenfolge. Das ist wichtig für jedes Modell mit verschlüsseltem Reasoning – änderst du die Signatur, weist der Provider den gesamten erneut abgespielten Verlauf zurück.
Was weiterhin abgelehnt wird
Das Aufteilen gilt nur für Batches, die aufgeteilt werden können und sollten. Der Rest bleibt unverändert:
| Fall | Verhalten |
|---|---|
Ein Batch nur aus connectors__-Namen |
Weiterhin ein Gateway-Dispatch, gleiche Form wie zuvor |
| Fehlerhafte Batches (nicht parsebar, Einträge, die keine Objekte sind) | Bleiben dem Fehler des Dispatchers überlassen |
| Mehr als 10 Einträge | Bleiben dem Fehler des Dispatchers überlassen (MAX_CALLS_PER_DISPATCH = 10) |
| Ein einzelner Eintrag | Vertrag unverändert |
Der alte Fehler-String verschwand also nicht aus der Codebasis – er lebt weiter in tools/tool_search_validation.py. Er dient jetzt Aufrufern, die den Split-Pfad umgehen; ein normaler Konversations-Turn trifft ihn nicht mehr. Den alten Pfad zu behalten und den häufigen Fall daran vorbeizuleiten, ist die sicherere Form: Nichts, was früher funktionierte, hört auf zu funktionieren.
Vier Dinge, die dir auffallen werden
Der Vertragstext hat sich geändert. Die Tool-Beschreibung von tool_call sagte früher, lokale deferred Tools seien eines pro tool_call; jetzt heißt es, lokale Einträge werden vom Agenten in einzelne Aufrufe aufgeteilt, jeder mit seiner eigenen Concurrency-Policy. Die offiziellen Tool-Search-Dokumente wurden entsprechend aktualisiert. Ein Modell kann keine Regel verletzen, die es nicht mehr kennt.
Hooks feuern pro Eintrag. Wenn du ein pre_tool_call-Plugin geschrieben hast, das Writes blockiert, war das alte Verhalten für einen Batch alles-oder-nichts. Jetzt feuert der Hook einmal pro Eintrag mit dem Namen des zugrunde liegenden Tools und der eigenen Call-ID des Eintrags, sodass ein Write blockiert werden kann, während ein Read im selben Batch weiterhin läuft.
Ergebnisse kommen in Eingabereihenfolge zurück. Die drei Ergebnisse werden in der ursprünglichen Reihenfolge wieder eingefügt, mit neu berechneten Zählern, sodass ein Split nicht neu mischt, was das Modell sieht.
Unterbrechen ist sauberer. Drückst du /stop mitten im Batch, werden die Einträge, die noch nicht gestartet sind, nie gesendet, sodass nichts in der Luft hängt.
Wie du es bekommst
Der Fix wurde am 2. Oktober 2026 in den main-Branch gemergt. Das neueste getaggte Release ist v0.21.5 (Tag v2026.9.24), diese Änderung ist also vorerst nur auf main – eine main-tracking-Installation nimmt sie beim nächsten hermes update mit, und Release-Nutzer bekommen sie im nächsten Tag.
Es gibt nichts zu konfigurieren; es ist eine Korrektur des Standardverhaltens, kein Schalter. Das Einzige, was sich lohnt, ist, deine pre_tool_call-Hooks noch einmal zu lesen. Wenn du sie locker geschrieben hast in der Annahme, ein Batch würde ohnehin einfach abgelehnt, dann ist das Feuern pro Eintrag der Moment, das Blockieren von Writes zu verschärfen. Die Konfiguration für deferred Tools steht in der MCP-Befehlsreferenz, und die Konfigurationsfläche rund um MCP-Server und Kontextvariablen behandelt dieser Leitfaden.
Das Fazit
Ein Satz fasst es zusammen: Ein Modell kann jetzt mehrere Tools auf einmal anfordern, weil die Verantwortung fürs Aufteilen von „einer Regel, die das Modell sich merken muss“ zu „einem Pfad, den der Agent immer nimmt“ gewandert ist.
Es ist keine schillernde Änderung, aber sie spart in echten Gesprächen einen Roundtrip ein – besonders in Setups mit mehreren MCP-Servern und einem kleineren Modell, wo eine einzige Ablehnung einen ganzen Turn entgleisen lassen kann. Und wo du schon hier bist: Es lohnt sich, deine Skills und System-Prompts zu durchsuchen – jede Anweisung, die dem Modell sagt, jeweils nur ein Tool aufzurufen, ist jetzt obsolet.