Trois outils dans un seul tool_call : ce n'est plus une erreur, Hermes découpe le lot
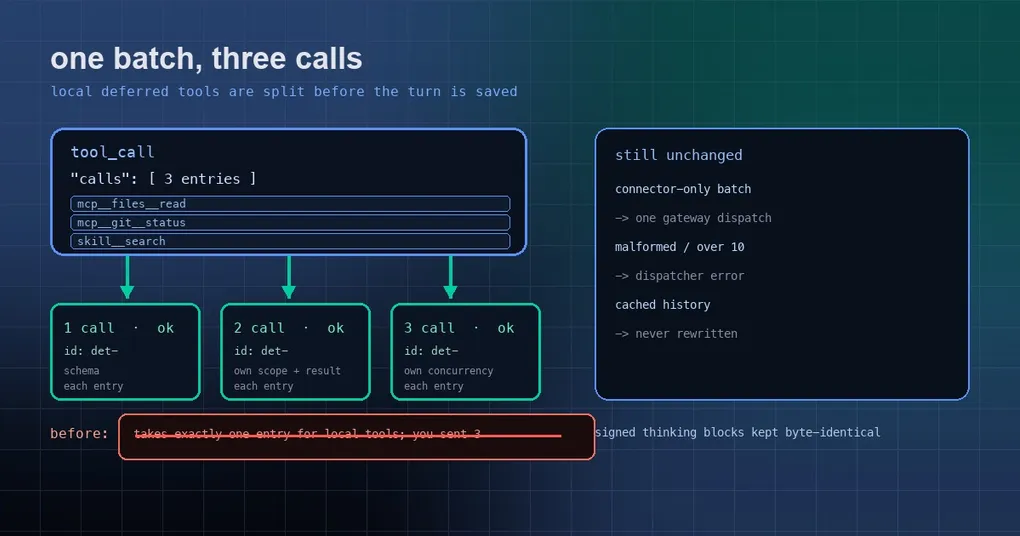
Vous avez trois serveurs MCP branchés sur Hermes : l’un lit des fichiers, l’autre interroge git, le troisième crée des tickets dans le tracker de votre entreprise. Vous lui demandez donc de “parcourir ces fichiers et d’ouvrir un ticket”, et il fait ce que ferait n’importe quel appelant raisonnable : il place trois entrées dans un seul tool_call. Vous attendez trois résultats. Ce que vous obtenez, c’est un message de correction et un aller-retour perdu, parce que l’agent doit tout repenser avant de réémettre les appels un par un.
La PR #131249 comble cette lacune. L’agent découpe désormais le lot en appels individuels avant que le tour ne soit persisté. Voici le mécanisme, les limites, et ce qui change réellement pour vous.
D’où venait le rejet
Pour comprendre l’erreur, il faut d’abord savoir qu’Hermes charge les outils MCP et plugin de manière différée. Ils ne figurent pas dans la liste d’outils toujours présente — le modèle trouve le nom exact avec tool_search, puis l’invoque via tool_call. C’est un choix qui économise des tokens, décrit dans notre guide de recherche d’outils.
L’argument calls de tool_call est un tableau, d’où une question naturelle : puisqu’il s’agit d’un tableau, pourquoi ne pas y mettre trois entrées ?
Avant ce correctif, la réponse était non. L’ancien contrat était “les connectors peuvent regrouper, les outils locaux c’est un par appel”. Un modèle qui plaçait deux outils locaux ou plus dans un même lot voyait le tout renvoyé avec une correction :
tool_call takes exactly one entry for local tools; you sent 2.
Retry with only: {"calls":[{"name":"mcp__files__read","arguments":{...}}]}...
Le message était exact, mais il avait un coût. Le modèle devait replanifier et réémettre. L’auteur de la PR l’a mesuré sur de vraies sessions : le même lot local à deux entrées coûtait 9 messages et 33 secondes avant le correctif (rejeté, repris en singletons) et 7 messages et 16 secondes après (découpé et exécuté). L’essentiel du gain, c’est le temps de raisonnement du modèle.
Le correctif : découper avant la persistance
L’idée est sans éclat. Plutôt que de laisser le dispatcher rejeter un lot, on le découpe plus tôt.
L’implémentation est un nouveau fichier, agent/tool_call_batches.py, avec un point d’entrée expand_local_tool_batches(), appelé une seule fois depuis agent/turn_tool_round.py. L’emplacement est le point important : avant que le message de l’assistant ne soit persisté. Seul le tour non persisté est touché, l’historique en cache n’est donc jamais réécrit.
Après le découpage, chaque entrée suit le chemin d’outil ordinaire au lieu de passer par le bridge :
- vérification de portée, validation du schéma, analyse des arguments ;
- hooks
pre_tool_callet guardrails ; - les approbations se règlent entrée par entrée — un refus n’entraîne pas les autres ;
- la politique de concurrence propre à l’outil sous-jacent s’applique, les serveurs capables de parallélisme s’exécutent donc toujours en parallèle ;
- chaque entrée obtient son propre résultat apparié et sa propre écriture incrémentale.
Deux détails comptent plus qu’ils n’en ont l’air :
Les ids des appels enfants sont déterministes. La première entrée réutilise l’appel parent ; les autres reçoivent des ids de deterministic_call_id(), dérivés de l’id parent, des arguments et de l’index. Les rejeux produisent donc des ids stables, au lieu d’une session qui semble avoir appelé un ensemble d’outils différent à chaque tentative.
Les listes de blocs des providers natifs sont réécrites sur place. Anthropic et Bedrock rejouent des blocs de contenu ordonnés au lieu de reconstruire l’historique depuis les tool_calls, la liste de blocs est donc éditée en position : les blocs de réflexion signés restent identiques au byte près et conservent leur ordre. C’est important pour tout modèle à raisonnement chiffré — modifiez la signature et le provider rejette tout l’historique rejoué.
Ce qui est toujours rejeté
Le découpage ne s’applique qu’aux lots qui peuvent et doivent l’être. Le reste est inchangé :
| Cas | Comportement |
|---|---|
Un lot de noms uniquement connectors__ |
Toujours un seul dispatch de gateway, même forme qu’avant |
| Lots malformés (illisibles, entrées qui ne sont pas des objets) | Laissés à l’erreur du dispatcher |
| Plus de 10 entrées | Laissés à l’erreur du dispatcher (MAX_CALLS_PER_DISPATCH = 10) |
| Une seule entrée | Contrat inchangé |
L’ancienne chaîne d’erreur n’a donc pas disparu du code — elle vit toujours dans tools/tool_search_validation.py. Elle sert désormais aux appelants qui contournent le chemin de découpage ; un tour conversationnel normal ne la rencontrera pas. Garder l’ancien chemin tout en routant le cas courant autour de lui est la forme la plus sûre : rien de ce qui fonctionnait ne cesse de fonctionner.
Quatre choses que vous remarquerez
Le texte du contrat a changé. La description de l’outil tool_call disait auparavant que les outils locaux différés étaient un par tool_call ; elle dit maintenant que les entrées locales sont découpées en appels individuels par l’agent, chacun suivant sa propre politique de concurrence. La documentation officielle de la recherche d’outils a été mise à jour en conséquence. Un modèle ne peut pas enfreindre une règle qu’il ne connaît plus.
Les hooks se déclenchent par entrée. Si vous avez écrit un plugin pre_tool_call qui bloque les écritures, l’ancien comportement était tout-ou-rien pour un lot. Désormais le hook se déclenche une fois par entrée avec le nom de l’outil sous-jacent et l’id d’appel propre à cette entrée, une écriture peut donc être bloquée pendant qu’une lecture du même lot s’exécute toujours.
Les résultats reviennent dans l’ordre d’entrée. Les trois résultats se recollent dans l’ordre d’origine avec des comptes recalculés, un découpage ne remanie donc pas ce que le modèle voit.
L’interruption est plus propre. Appuyez sur /stop au milieu d’un lot et les entrées qui n’ont pas démarré ne sont jamais envoyées, rien ne reste donc en suspens.
Comment l’obtenir
Le correctif a été fusionné dans la branche main le 2 octobre 2026. La dernière version taguée est la v0.21.5 (tag v2026.9.24), ce changement est donc sur main uniquement pour l’instant — une installation qui suit main le récupère à son prochain hermes update, et les utilisateurs d’une version stable l’obtiendront au prochain tag.
Il n’y a rien à configurer ; c’est une correction du comportement par défaut, pas un interrupteur. La seule chose qui vaut la peine, c’est de relire vos hooks pre_tool_call. Si vous les avez écrits à la légère en partant du principe qu’un lot serait simplement rejeté, le déclenchement par entrée est le moment de resserrer le blocage des écritures. La configuration des outils différés se trouve dans la référence des commandes MCP, et la surface de configuration autour des serveurs MCP et des variables de contexte est couverte dans ce guide.
À retenir
En une phrase : un modèle peut désormais demander plusieurs outils à la fois, parce que la responsabilité du découpage est passée de “une règle que le modèle doit mémoriser” à “un chemin que l’agent emprunte toujours”.
Ce n’est pas un changement spectaculaire, mais il récupère un aller-retour dans les vraies conversations — surtout sur les configurations à plusieurs serveurs MCP et petit modèle, où un seul rejet peut faire dérailler tout un tour. Pendant que vous êtes là, cela vaut aussi la peine de parcourir vos skills et vos prompts système : toute instruction demandant au modèle d’appeler un outil à la fois est désormais obsolète.