Tres herramientas en un solo tool_call ya no dan error: Hermes divide el batch
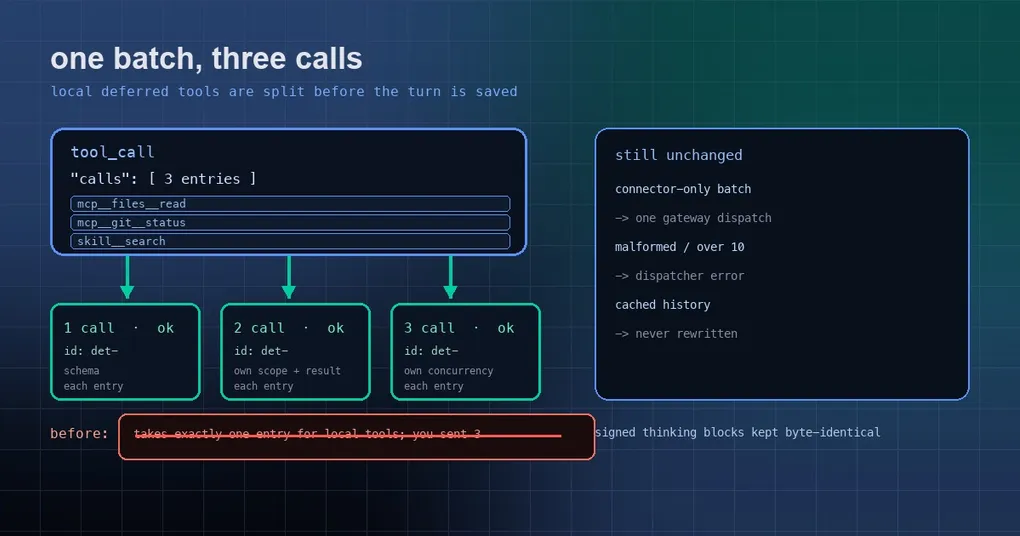
Tienes tres servidores MCP conectados a Hermes: uno lee archivos, otro consulta git y otro abre tickets en el tracker de tu empresa. Así que le pides «hojea estos archivos y abre un ticket», y hace lo que haría cualquier interlocutor razonable: mete tres entradas en un solo tool_call. Esperas tres resultados. Lo que recibes es un mensaje de corrección y una ida y vuelta desperdiciada, porque el agente tiene que pensarlo todo de nuevo y volver a emitir las llamadas de a una.
El PR #131249 cierra esa brecha. Ahora el agente divide el batch en llamadas individuales antes de que el turno se persista. Aquí van el mecanismo, los límites y lo que cambia realmente para ti.
De dónde venía el rechazo
Para entender el error, primero hay que saber que Hermes carga las herramientas de MCP y de plugins de forma diferida (deferred). No están en la lista de herramientas siempre presentes: el modelo encuentra el nombre exacto con tool_search y luego la invoca con tool_call. Es un diseño que ahorra tokens, descrito en nuestra guía de búsqueda de herramientas.
El argumento calls de tool_call es un array, así que surge una pregunta natural: si es un array, ¿por qué no meter tres entradas?
Antes de este fix, la respuesta era no. El contrato antiguo era «los connectors pueden ir en batch, las herramientas locales van de a una por llamada». Un modelo que metía dos o más herramientas locales en un batch recibía todo de vuelta con una corrección:
tool_call takes exactly one entry for local tools; you sent 2.
Retry with only: {"calls":[{"name":"mcp__files__read","arguments":{...}}]}...
El mensaje era exacto, pero no era gratis. El modelo tenía que replanificar y reemitir. El autor del PR lo midió en sesiones reales: el mismo batch local de dos entradas costaba 9 mensajes y 33 segundos antes del fix (rechazado, reintentado como singletons) y 7 mensajes y 16 segundos después (dividido y ejecutado). Casi todo el ahorro es tiempo de re-razonamiento del modelo.
El fix: dividir antes de persistir
La idea no tiene nada de glamurosa. En lugar de que el dispatcher rechace un batch, se divide antes.
La implementación es un archivo nuevo, agent/tool_call_batches.py, con el punto de entrada expand_local_tool_batches(), llamado una vez desde agent/turn_tool_round.py. La ubicación es lo importante: antes de que el mensaje del asistente se persista. Solo se toca el turno no persistido, así que el historial en caché nunca se reescribe.
Tras la división, cada entrada sigue el camino normal de herramientas en lugar de pasar por el bridge:
- comprobación de scope, validación de schema, parseo de argumentos;
- hooks
pre_tool_cally guardrails; - las aprobaciones se resuelven por entrada —una denegación no arrastra a las demás—;
- se aplica la política de concurrencia de la propia herramienta subyacente, así que los servidores capaces de paralelizar siguen corriendo en paralelo;
- cada entrada recibe su propio resultado emparejado y su propia escritura incremental.
Dos detalles importan más de lo que parece:
Los ids de las llamadas hijas son deterministas. La primera entrada reutiliza la llamada padre; el resto recibe ids de deterministic_call_id(), derivados del id padre, los argumentos y el índice. Así los replays producen ids estables en lugar de una sesión que parece haber llamado a un conjunto distinto de herramientas en cada reintento.
Las listas de bloques nativas del provider se reescriben en su sitio. Anthropic y Bedrock reproducen bloques de contenido ordenados en lugar de reconstruir el historial desde tool_calls, así que la lista de bloques se edita en su posición: los bloques de thinking firmados siguen siendo idénticos byte a byte y conservan su orden. Eso importa para cualquier modelo con razonamiento cifrado: si alteras la firma, el provider rechaza todo el historial reproducido.
Qué sigue rechazándose
La división solo se aplica a los batches que pueden y deben dividirse. El resto no cambia:
| Caso | Comportamiento |
|---|---|
Un batch solo con nombres connectors__ |
Sigue siendo un único dispatch del gateway, con la misma forma que antes |
| Batches malformados (no parseables, entradas que no son objetos) | Se dejan al error del dispatcher |
| Más de 10 entradas | Se dejan al error del dispatcher (MAX_CALLS_PER_DISPATCH = 10) |
| Una sola entrada | Contrato sin cambios |
Así que la vieja cadena de error no desapareció del código: sigue viviendo en tools/tool_search_validation.py. Ahora sirve a los llamadores que se saltan la ruta de división; un turno conversacional normal no la tocará. Mantener la ruta antigua mientras se desvía el caso común a su alrededor es la forma más segura: nada que antes funcionaba deja de funcionar.
Cuatro cosas que vas a notar
El texto del contrato cambió. La descripción de la herramienta tool_call decía que las herramientas locales diferidas eran una por tool_call; ahora dice que el agente divide las entradas locales en llamadas individuales, y que cada una sigue su propia política de concurrencia. La documentación oficial de tool-search se actualizó para reflejarlo. Un modelo no puede violar una regla que ya no conoce.
Los hooks se disparan por entrada. Si escribiste un plugin pre_tool_call que bloquea escrituras, el comportamiento antiguo era todo o nada para un batch. Ahora el hook se dispara una vez por entrada, con el nombre de la herramienta subyacente y el call id propio de esa entrada, de modo que una escritura puede bloquearse mientras una lectura del mismo batch sigue corriendo.
Los resultados vuelven en el orden de entrada. Los tres resultados se reinsertan en el orden original con los conteos recalculados, así que una división no reordena lo que ve el modelo.
Interrumpir es más limpio. Pulsa /stop a mitad de un batch y las entradas que no han empezado nunca se envían, así que no queda nada colgando.
Cómo conseguirlo
El fix se fusionó a la rama main el 2 de octubre de 2026. La última release etiquetada es v0.21.5 (tag v2026.9.24), así que este cambio es solo en main por ahora: una instalación que sigue main lo recoge en su siguiente hermes update, y los usuarios de release lo tendrán en el próximo tag.
No hay nada que configurar; es una corrección del comportamiento por defecto, no un interruptor. Lo único que vale la pena hacer es releer tus hooks pre_tool_call. Si los escribiste de forma laxa asumiendo que un batch simplemente se rechazaría, el disparo por entrada es el momento de endurecer el bloqueo de escrituras. La configuración de herramientas diferidas está en la referencia del comando MCP, y la superficie de configuración en torno a servidores MCP y variables de contexto se cubre en esta guía.
La conclusión
Una línea lo resume: un modelo ya puede pedir varias herramientas a la vez, porque la responsabilidad de dividir pasó de «una regla que el modelo debe recordar» a «una ruta que el agente siempre toma».
No es un cambio llamativo, pero recupera una ida y vuelta en conversaciones reales —sobre todo en configuraciones con varios servidores MCP y un modelo más pequeño, donde un solo rechazo puede descarrilar un turno entero—. Ya que estás aquí, también vale la pena hacer un grep en tus skills y system prompts: cualquier instrucción que le diga al modelo que llame a una herramienta a la vez está obsoleta.