一次更新把三个月的会话回滚到七月:锁着的数据库被当成了损坏
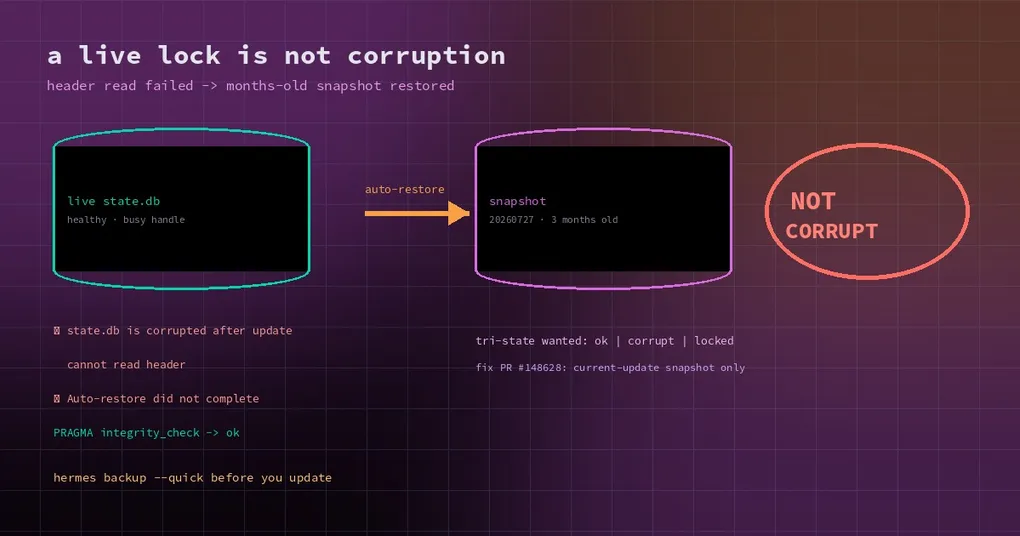
周三早上你打开 Hermes,想接着昨天的活干。侧边栏里最近的会话不见了,列表停在七月——你三个月的对话、定时任务记录、消息历史全都不在。更新日志里躺着三行字:state.db is corrupted after update、cannot read header、Auto-restore did not complete。
你第一反应是数据库坏了,第二反应是那三个月的记录还能不能救。实际情况比这两句都要荒诞一点:数据库从来没坏,是更新流程把“文件正被占用”读成了“文件已损坏”,然后用一份三个月前的快照把它覆盖了,又在成功覆盖之后报了个失败。
时间线:一次“没有代码变更”的更新
事故报告里的日志摘得很清楚,一次常规更新(Windows 11、v0.22.5 → v0.22.6、默认 profile、state.db 约 1.19 GB):
22094  build ends — code no-op: apply/snapshot SKIPPED (so NO fresh snapshot was taken)
22098  ⚠ state.db is corrupted after update (default home): cannot read header
22100 ✗ Auto-restore did not complete三行的顺序就是全部故事。这次更新没有真正改动代码,所以快照阶段被跳过了——没有生成新的恢复点。接着完整性检查在“暂停 gateway”的窗口里去读 state.db 的头部,读失败,被判定为损坏。然后还原逻辑在磁盘上找到的唯一快照是 state-snapshots/20260718-132211-pre-update,三个半月前的。它校验通过,于是被用来覆盖当前库。覆盖本身成功了(还原后的 runtime_epoch 是 (44, 'offline-restore'),正是这条路径会写的戳),但还原之后的复查又走了同一次头部读,再次失败,于是最终结论是“自动还原未完成”。
一位 24 小时后遇到同样问题的用户数据更夸张:531 个会话、约 81,500 条消息,被替换成 7 月 27 日的状态。
三个缺陷叠在一起
单看任何一个都不至于丢数据,叠起来才致命。
1. 把“被占用”和“损坏”当成同一件事
hermes_cli/sqlite_safe_read.py 里的 read_header_bytes_preopen() 在两种情况下都返回 None:当前进程里有这个库的活跃连接,或者原始头部读取出任何 OSError。在 Windows 上,另一个进程持有句柄导致的共享冲突就是一个 OSError。
backup.py 的 verify_sqlite_integrity() 把 None 直接映射成 cannot read header 的失败结论,调用方拿不到“为什么读不到”。而这个函数自己的注释写着“校验对象本来就是离线快照/备份产物”——更新守卫偏偏把它指向了正在使用的主目录,还在 gateway 只是被暂停、尚未退出的时间窗里。
用 PRAGMA quick_check 或只读连接的路径去看同一个文件,它一直是好的:事后同一台机器、同一个文件跑 PRAGMA integrity_check 得到 ok,verify_sqlite_integrity 也返回 valid。这不是巧合,是分类错位。
2. 没有代码变更的更新不拍快照
还原逻辑的假设是“总有一个刚拍好的快照可用”。但当更新是 no-op 时,快照阶段整体跳过,唯一的还原目标就是磁盘上最老的那个。于是“自动还原”本身变成了数据丢失事件,而没有任何一步去检查:这份快照比它要覆盖的数据老了多少?
3. 成功的还原被报成“未完成”
还原执行了,数据库也确实被换成了旧快照,然后复查用同一个会失败的方法读头部,于是输出 Auto-restore did not complete。你第二天查看数据库,看到的是一个健康但被回滚的库,加一句彻底误导的日志。两个信息都不对:既不是“损坏”,也不是“没还原”。
你的数据大概率还在快照里,但别急着写
三个可操作的判断:
- 先停手。 不要在回滚后的库上继续工作,新写入会让“哪些是旧数据”更难分辨。
- 看快照目录。
state-snapshots/下每个快照都带时间戳,被还原的是哪一个一眼能看出来。三个月前的库还躺在那里,它不是垃圾。 - 验一遍被指控的库。 如果旧库文件还在(比如更新前的备份),用只读连接跑
PRAGMA integrity_check,多半会得到ok——这决定了它是“被误判的好库”还是“真的坏了”。
如果确认是误判,把旧库换回来通常比在当前库上做增量修复更可靠;导出会话也是保底手段:
hermes backup --quick                  # 更新前先留一份关键状态
hermes sessions export backup.jsonl
修复进展
针对这个事故已经有两个方向的动作:
- #148628(PR,开放中):自动还原只使用“本次更新为该 profile 记录的”那个快照。如果这个快照不存在、里面没有数据库、或校验不过,就保持现有库不动。它同时修掉了“成功还原被报成未完成”的问题,因为不再有意外的旧快照可选。
- #128350(单独追踪):SQLite 的锁状态分类,也就是把“ok / 损坏 / 暂时读不到”做成三态,读不到时不还原。
两个都还没进 v0.22.7 的 tag。也就是说,你现在装的最新稳定版仍然是旧行为,风险窗口还在。
更新流程该怎么改(给运维的建议)
这是一个典型的“校验代码被用在了它不适用的对象上”的案例。落到日常操作上,有四件事值得固定下来:
- 更新前跑一次
hermes backup --quick,尤其是 Windows 机器和大库(GB 级)。它只需几十秒,是这类事故里唯一真正能救命的动作。 - 看一眼
state-snapshots/的日期。如果最新快照比你的数据老一个月,那你等于没有恢复点。 - 别把“还原成功”当成“数据安全”。还原是回落,不是修复;回落后第一件事是确认丢了什么,而不是继续用。
- 遇到
cannot read header先怀疑占用。Windows 上文件被另一个进程持有是常态,不是异常。
一句话总结
数据库没坏,坏的是判断“它坏了”的那一步。锁、损坏、暂时读不到是三种状态,需要三种不同的反应;把它们合并成一种,代价就是三个月的会话记录。修复已经在路上,但今天能保护你的仍然是那句老话:更新之前先备份。