Uma atualização devolveu três meses de sessões a julho — porque um arquivo bloqueado foi chamado de corrompido
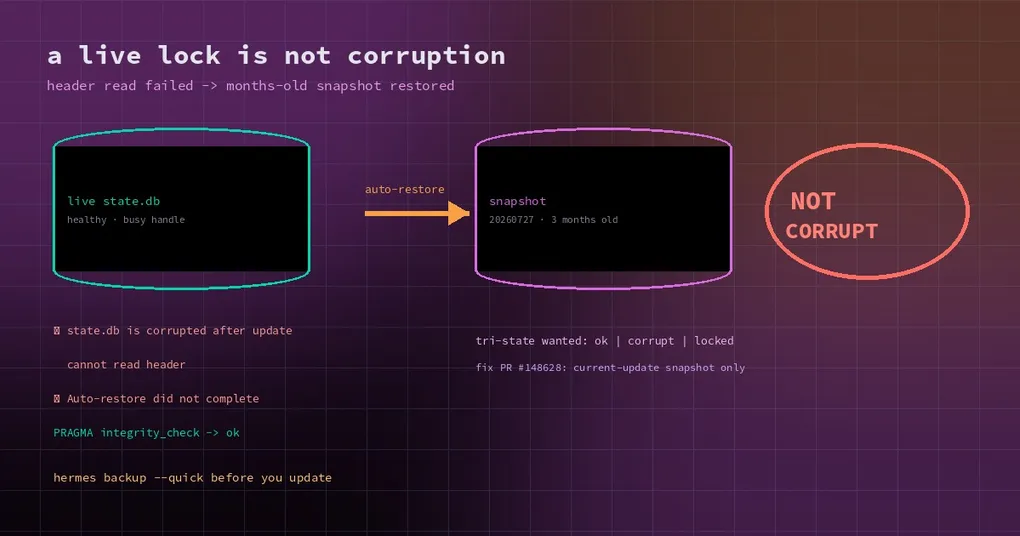
Na manhã de quarta-feira você abre o Hermes para continuar o trabalho de ontem. As sessões recentes sumiram; a lista para em julho. Três meses de conversas, histórico de cron e mensagens não estão lá. O log da atualização tem três linhas: state.db is corrupted after update, cannot read header, Auto-restore did not complete.
Seu primeiro pensamento é que o banco quebrou. O segundo é se esses três meses são recuperáveis. A verdade é mais estranha que qualquer um dos dois: o banco nunca esteve corrompido. O pipeline de atualização leu “este arquivo está em uso” como “este arquivo está danificado”, sobrescreveu-o com um snapshot de três meses antes e depois reportou falha numa sobrescrita que já tinha dado certo.
A linha do tempo de uma atualização que não faz nada
O relatório do incidente cita o log na íntegra — uma atualização rotineira do Windows 11 de v0.22.5 para v0.22.6, profile padrão, state.db de cerca de 1,19 GB:
22094  build ends — code no-op: apply/snapshot SKIPPED (so NO fresh snapshot was taken)
22098  ⚠ state.db is corrupted after update (default home): cannot read header
22100  ✗ Auto-restore did not complete
Essas três linhas são a história inteira. A atualização não trazia mudança real de código, então a etapa de snapshot foi pulada — nenhum ponto de recuperação novo foi criado. A checagem de integridade leu então o cabeçalho do state.db durante a janela de pausa, falhou e declarou corrupção. A lógica de restauração encontrou exatamente um snapshot no disco, state-snapshots/20260718-132211-pre-update, de três meses e meio atrás. Ele passou na validação, então foi usado para sobrescrever o banco em produção. A sobrescrita funcionou (o runtime_epoch pós-restauração era (44, 'offline-restore'), a marca que esse caminho grava), mas a verificação posterior repetiu a mesma leitura de cabeçalho, falhou de novo e a execução terminou com “a restauração automática não foi concluída”.
Um segundo relator passou por isso 24 horas depois, com uma instalação maior: 531 sessões e cerca de 81.500 mensagens substituídas pelo estado de 27 de julho.
Três defeitos, empilhados
Qualquer um deles sozinho seria sobrevivível. Juntos, destroem dados.
1. “Em uso” e “corrompido” eram a mesma resposta
Em hermes_cli/sqlite_safe_read.py, read_header_bytes_preopen() retorna None em dois casos: existe uma conexão rastreada e ativa com aquele banco no processo leitor, ou a leitura crua do cabeçalho levanta qualquer OSError. No Windows, uma violação de compartilhamento causada por outro processo segurando o arquivo é exatamente esse OSError.
backup.py::verify_sqlite_integrity() mapeia None direto para uma falha cannot read header, e quem chama não tem como saber o motivo. O próprio comentário da função diz que a verificação mira snapshots offline e artefatos de backup — mas o guarda da atualização aponta ela para o home do profile em uso, dentro de uma janela em que o gateway está apenas pausado, não encerrado.
Leia o mesmo arquivo por uma conexão somente leitura ou com PRAGMA quick_check e está tudo bem. Depois do fato, na mesma máquina e no mesmo arquivo, PRAGMA integrity_check retornou ok e verify_sqlite_integrity retornou válido. Isso não é sorte; é classificação errada.
2. Nenhum snapshot numa atualização sem mudanças
A lógica de restauração assume que sempre existe um snapshot recém-tirado. Quando a atualização não aplica mudanças de código, a etapa de snapshot é pulada por completo, então o único alvo de restauração é a coisa mais antiga do disco. A “restauração automática” passa a ser o próprio evento de perda de dados, e nada checa quanto mais antigo esse snapshot é do que os dados que ele vai substituir.
3. Uma restauração bem-sucedida reportada como falha
A restauração rodou, e o banco realmente foi trocado pelo snapshot antigo. A checagem posterior usou a mesma leitura que falha, então a execução imprimiu Auto-restore did not complete. Abra o banco no dia seguinte e você vê um arquivo saudável, porém revertido, mais uma linha de log errada nas duas direções: não estava corrompido, e a restauração aconteceu.
Seus dados provavelmente ainda estão no snapshot — pare de escrever primeiro
Três checagens práticas:
- Pare de usar esse profile. Cada escrita nova no banco revertido torna mais difícil separar o dado antigo do novo.
- Olhe o diretório de snapshots. Cada entrada em
state-snapshots/tem carimbo de tempo, então a que foi restaurada salta aos olhos. O banco de três meses continua lá, e não é lixo. - Verifique de novo o arquivo acusado. Se o banco de antes da atualização ainda existe em algum lugar, abra em modo somente leitura e rode
PRAGMA integrity_check. Muito provavelmente vai retornarok— o que indica se você tem em mãos um arquivo saudável mal julgado ou um realmente danificado.
Se foi julgamento errado, devolver o banco antigo costuma ser mais confiável do que remendar o atual, e exportar as sessões é a rede de segurança nos dois casos:
hermes backup --quick                  # a critical-state snapshot before updating
hermes sessions export backup.jsonl
Onde está a correção
Duas frentes estão em andamento:
- #148628 (PR, aberta): a recuperação automática só poderá usar o snapshot que a atualização atual registrou para aquele profile. Se ele estiver ausente, sem o banco ou falhar na validação, o guarda deixa o banco em uso intacto. Isso também elimina o rótulo falso de “não concluída”, porque não há snapshot obsoleto para o qual voltar.
- #128350 (acompanhada à parte): classificar o estado de lock do SQLite — tornar o veredito do cabeçalho triestado (
ok/ corrompido / temporariamente ilegível) e nunca restaurar em “ilegível”.
Nenhuma das duas está na tag v0.22.7, então o build estável que você instala hoje ainda se comporta do jeito antigo. A janela de risco está aberta.
Como rodar atualizações daqui pra frente
Este é um caso de manual de código de verificação apontado para um alvo para o qual nunca foi projetado. Quatro hábitos cobrem isso:
- Rode
hermes backup --quickantes de atualizar, especialmente no Windows e em stores de vários gigabytes. Leva segundos e é o único passo que de fato te salva aqui. - Confira as datas em
state-snapshots/. Se o snapshot mais novo é um mês mais velho que seus dados, você não tem ponto de recuperação. - Não leia “restauração concluída” como “dados a salvo”. Restauração é rollback, não reparo; o primeiro trabalho depois é descobrir o que se perdeu, não seguir trabalhando.
- Trate
cannot read headercomo lock primeiro. No Windows, outro processo segurando o arquivo é normal, não exceção.
A versão curta
O banco estava bem. O julgamento de que ele estava quebrado, não. Bloqueado, corrompido e temporariamente ilegível são três estados que pedem três respostas diferentes; juntar tudo em uma custa três meses de sessões. A correção está a caminho, mas a proteção disponível hoje é a antiga: faça backup antes de atualizar.
Para continuar lendo: curar sozinho um state.db danificado, exportar e fazer backup das sessões, uma rotina de atualização cuidadosa, o que mais está na janela da v0.22.7.