Una actualización devolvió tres meses de sesiones a julio porque un archivo bloqueado fue declarado corrupto
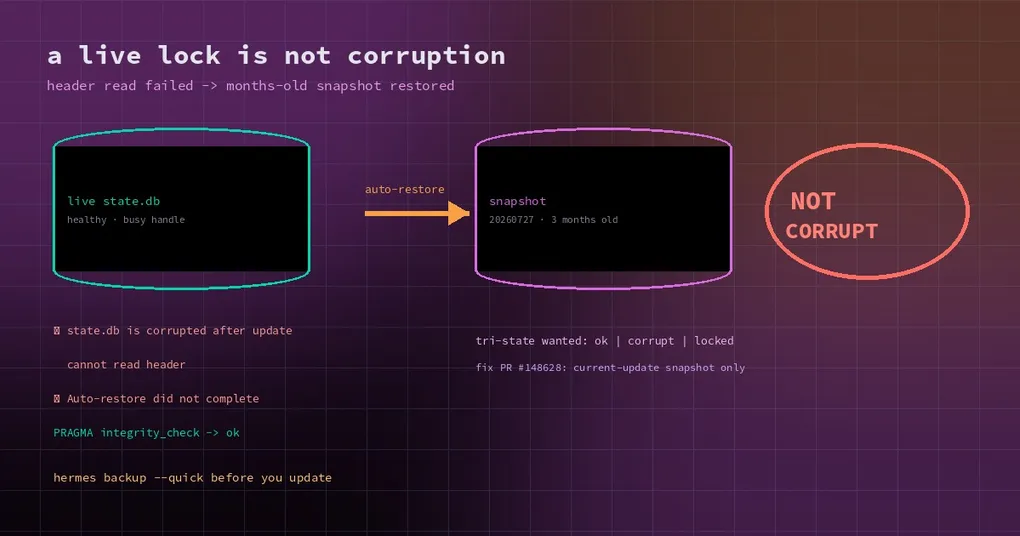
Miércoles por la mañana abres Hermes para continuar el trabajo de ayer. Las sesiones recientes ya no están; la lista se detiene en julio. Tres meses de conversaciones, historial de cron y mensajes no aparecen. El registro de la actualización tiene tres líneas: state.db is corrupted after update, cannot read header, Auto-restore did not complete.
Tu primer pensamiento es que la base de datos se rompió. El segundo, si esos tres meses se pueden recuperar. La verdad es más extraña que ambas: la base de datos nunca estuvo corrupta. El pipeline de actualización leyó «este archivo está en uso» como «este archivo está dañado», la sobrescribió con un snapshot de tres meses antes y luego informó de un fallo por una sobrescritura que ya había funcionado.
La cronología de una actualización que no hizo nada
El informe del incidente cita el registro tal cual: una actualización rutinaria de Windows 11 de v0.22.5 a v0.22.6, profile por defecto, state.db de unos 1,19 GB:
22094  build ends — code no-op: apply/snapshot SKIPPED (so NO fresh snapshot was taken)
22098  ⚠ state.db is corrupted after update (default home): cannot read header
22100  ✗ Auto-restore did not complete
Esas tres líneas son toda la historia. La actualización no traía cambios reales de código, así que la etapa de snapshot se omitió: no se creó un punto de recuperación nuevo. La comprobación de integridad leyó entonces la cabecera de state.db durante la ventana de pausa, falló y declaró corrupción. La lógica de restauración encontró exactamente un snapshot en disco, state-snapshots/20260718-132211-pre-update, de tres meses y medio antes. Se validó, así que se usó para sobrescribir la base de datos en vivo. La sobrescritura funcionó (el runtime_epoch posterior era (44, 'offline-restore'), la marca que escribe esa ruta), pero la verificación posterior repitió la misma lectura de cabecera, volvió a fallar y la ejecución terminó con «la restauración automática no se completó».
Un segundo usuario lo sufrió 24 horas después con una instalación mayor: 531 sesiones y unas 81.500 mensajes sustituidos por el estado del 27 de julio.
Tres defectos, apilados
Cualquiera de ellos por separado sería sobrevivible. Juntos destruyen datos.
1. «En uso» y «corrupto» eran la misma respuesta
En hermes_cli/sqlite_safe_read.py, read_header_bytes_preopen() devuelve None en dos casos: existe una conexión viva registrada a esa base de datos en el proceso lector, o la lectura directa de la cabecera lanza cualquier OSError. En Windows, una violación de compartición provocada por otro proceso que tiene el archivo abierto es exactamente ese OSError.
backup.py::verify_sqlite_integrity() traduce None directamente a un fallo de cannot read header, y quien llama no puede saber por qué. El propio comentario de la función dice que la verificación está pensada para snapshots offline y artefactos de backup, pero el guardia de actualización la apunta al home del profile en vivo, dentro de una ventana en la que el gateway solo está en pausa, no cerrado.
Lee el mismo archivo con una conexión de solo lectura o con PRAGMA quick_check y está bien. A posteriori, en la misma máquina y con el mismo archivo, PRAGMA integrity_check devolvió ok y verify_sqlite_integrity devolvió válido. No es suerte; es una clasificación errónea.
2. Ningún snapshot en una actualización sin cambios
La lógica de restauración da por hecho que siempre existe un snapshot recién tomado. Cuando la actualización no aplica cambios de código, la etapa de snapshot se omite por completo, así que el único objetivo de restauración es lo más antiguo del disco. La «restauración automática» se convierte entonces en el evento de pérdida de datos, y nada comprueba cuánto más antiguo es ese snapshot que los datos que está a punto de reemplazar.
3. Una restauración exitosa informada como fallo
La restauración se ejecutó y la base de datos sí se cambió por el snapshot antiguo. La comprobación posterior usó la misma lectura que falla, así que la ejecución imprimió Auto-restore did not complete. Abre la base de datos al día siguiente y verás un archivo sano pero retrocedido, más una línea de registro equivocada en ambos sentidos: no estaba corrupta y la restauración sí ocurrió.
Tus datos probablemente siguen en el snapshot: deja de escribir primero
Tres comprobaciones prácticas:
- Deja de usar ese profile. Cada escritura nueva en la base de datos retrocedida hace más difícil distinguir lo viejo de lo nuevo.
- Mira el directorio de snapshots. Cada entrada bajo
state-snapshots/lleva marca de tiempo, así que la que se restauró salta a la vista. La base de datos de tres meses sigue ahí, y no es basura. - Vuelve a verificar el archivo acusado. Si la base de datos previa a la actualización todavía existe en algún sitio, ábrela en solo lectura y ejecuta
PRAGMA integrity_check. Lo más probable es que devuelvaok, lo que te dice si tienes delante un archivo sano mal juzgado o uno realmente dañado.
Si fue un error de juicio, devolver la base de datos antigua suele ser más fiable que parchear la actual, y exportar las sesiones es la red de seguridad en cualquier caso:
hermes backup --quick                  # a critical-state snapshot before updating
hermes sessions export backup.jsonl
En qué punto está la corrección
Hay dos vías en marcha:
- #148628 (PR, abierto): la recuperación automática solo podrá usar el snapshot que la actualización actual registró para ese profile. Si no está, le falta la base de datos o no pasa la validación, el guardia deja intacta la base de datos en vivo. Eso también elimina la etiqueta falsa de «no completado», porque no hay ningún snapshot obsoleto al que recurrir.
- #128350 (seguido aparte): clasificar el estado de bloqueo de SQLite, haciendo el veredicto de cabecera triestado (
ok/ corrupto / ilegible temporalmente) y sin restaurar nunca con «ilegible».
Ninguna está en la etiqueta v0.22.7, así que la build estable que instales hoy sigue comportándose como antes. La ventana de riesgo sigue abierta.
Cómo actualizar de ahora en adelante
Este es un caso de manual de código de verificación apuntado a un objetivo para el que nunca se diseñó. Cuatro hábitos lo cubren:
- Ejecuta
hermes backup --quickantes de actualizar, sobre todo en Windows y con almacenes de varios gigabytes. Tarda segundos y es el único paso que de verdad te salva aquí. - Revisa las fechas bajo
state-snapshots/. Si el snapshot más reciente es un mes anterior a tus datos, no tienes punto de recuperación. - No leas «restauración correcta» como «datos a salvo». Una restauración es un rollback, no una reparación; la primera tarea después es averiguar qué se perdió, no seguir trabajando.
- Trata
cannot read headercomo un bloqueo primero. En Windows, que otro proceso tenga el archivo es normal, no excepcional.
La versión corta
La base de datos estaba bien. El juicio de que estaba rota, no. Bloqueado, corrupto e ilegible temporalmente son tres estados que necesitan tres respuestas distintas; colapsarlos en uno cuesta tres meses de sesiones. La corrección va por buen camino, pero la protección disponible hoy es la de siempre: haz backup antes de actualizar.
Para seguir leyendo: la autocuración de un state.db dañado, exportar y respaldar sesiones, una rutina de actualización cuidadosa, qué más hay en la ventana de v0.22.7.