Docker 里的 Hermes 突然说 aiohttp 没装:镜像少登记了一行基线
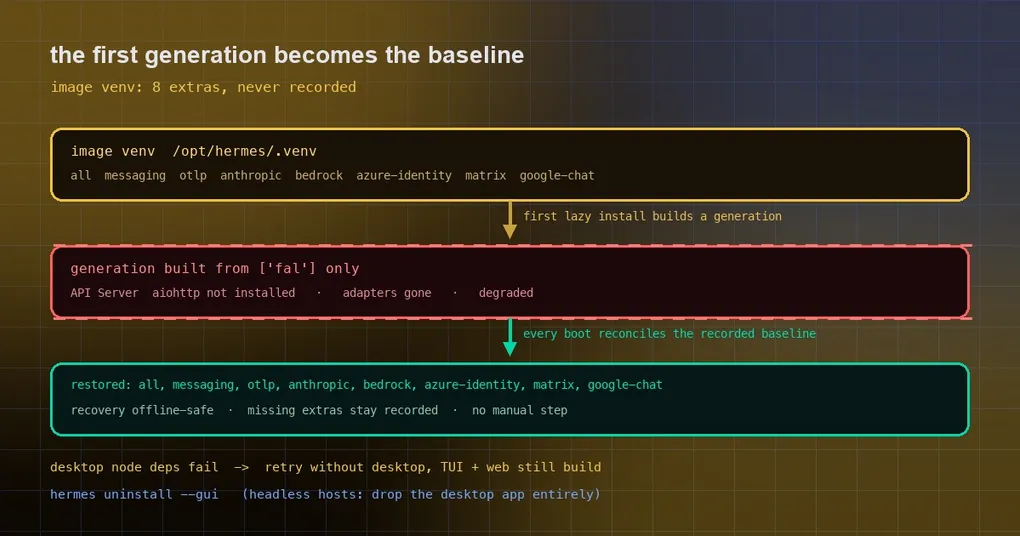
早上你打开 Docker 里跑的那个 Hermes,它告诉你 API Server 起不来——aiohttp not installed。消息平台的适配器不见了,MCP 服务器也不见了,托管代理显示成降级状态。你昨天没动过配置,镜像也没换,唯一的变化是它自己在前一天装了一个可选的依赖。
这不是“镜像坏了”,而是一个更隐蔽的机制问题:在这个体系里,容器自己构建的第一代依赖,会变成以后每次启动的基线。如果镜像烤进去的那批依赖没有被登记,那它们就会在第一次自建依赖时被悄悄丢掉。
先说清“依赖代”是怎么工作的
Hermes 的依赖不是“装了就一直在”。它由一套依赖管理(PM)维护,每次安装或更新都会生成一代环境:记录一份选择(哪些 extra 要装)加一个指纹,然后这一代就是后续启动的依据。
这套设计的核心假设是:基线有登记,增量才有意义。你后来随手装一个可选依赖,它应该是在已登记的基线上做并集;如果基线是空的,那个“随手装的”就会变成新的基线,把原来的东西挤掉。
security.allow_lazy_installs 默认是开着的(true),意思是缺什么可以按需懒装。看起来很方便,但它恰恰放大了上面这个问题:任何一次懒装都可能触发一次“构建新一代”。
为什么容器里特别容易中招
Docker 镜像里干了一件在别处很合理、但漏登记就会致命的事:它把八个 extra 直接烤进 /opt/hermes/.venv:
all messaging otlp anthropic bedrock azure-identity matrix google-chat拆开看就是:网关、OTLP 遥测、Anthropic / Bedrock / Azure 的身份与 SDK、Matrix 适配器、Google Chat 适配器——日常跑得起来全靠它们。
问题在于,镜像构建时没有把这批 extra 登记成 PM 的依赖选择。于是:
- 容器第一次因为某个懒装(比如一个插件带了自己的依赖,或者你装了 fal、parallel-web、exa 这类按需通道)去构建一代环境;
- 这一代只按“这次请求的 extra”来构建;
- 从下一次启动开始,这个不完整的选择就成了基线。
结果就是开头那一幕:API Server、消息适配器、MCP 服务器一起消失。从 v0.21.6 起,用官方镜像的容器只要经历过一次自建依赖,就会掉进这个坑。
顺带说明一下,这不是“没人发现”的问题——同一时间有另一位贡献者独立给出了同样的诊断(镜像里没有登记基线),并且对新安装提出了修复方案。这次落地的方案除了预防,还多做了两件事:修复已经损坏的卷,以及登记“请求的 extra 列表”而不是“实际装出来的清单”。
为什么是请求列表而不是清单?因为在真实镜像里试过之后会发现,清单会漏掉 all、cron、sms 这类没有自己包的元 extra——它们没法被“清点”出来,但必须留在基线里。
修复一:镜像构建时登记基线
现在镜像构建会把这批 extra 写进 store 的依赖事实里,用的正是打包版构建时已经在用的那条记录路径。于是以后所有安装都是在这份基线之上做并集,而不是从零重来。
修复二:每次启动自动把丢掉的 extra 补回来
预防只对新镜像生效,但已经被破坏的卷怎么办?答案是启动时自愈。
现在每次启动都会比较“镜像登记了哪些 extra”和“这个卷实际选了什么”,把缺的通过正常的显式同步路径补回去。已经坏成 ["fal"] 或者干脆空列表的卷,在换上新镜像后的第一次启动就会恢复,不需要手动操作。
几个边界处理得挺细:
- 如果补装失败(比如离线),镜像自带的 venv 仍然能启动,而且缺失的 extra 会保持被记录的状态,这样在下次启动之前的一次懒装不会又把它们挤掉;
- 登记的 extra 如果已经不在源码里声明了,会被忽略(用 PEP 685 的名称匹配);
- 记录本身损坏(extra 列表坏了、指纹丢了或不是字符串)会明确报
invalid recorded dependency state,而不是静默当成“没登记”; enabled-features.json故意不写,所以allow_lazy_installs的行为和修复前一模一样——这次改动只碰基线,不顺手改语义。
同一类问题的第二个坑:桌面版拖垮 TUI 和 Web UI
同一批修复里还有一个“一处失败,全体买单”的例子,只不过这次买单的是无头服务器。
源码安装的更新在准备依赖时,是把 ui-tui、web 和 apps/desktop 合在一次 npm ci 里装的。而这三者里只有桌面版会拉需要编译的原生模块:node-pty、electron。于是一台从没跑过桌面版、编译器只有 g++ 9 的 Ubuntu 服务器(g++ 9 不认 -std=gnu++20)会让整个装依赖步骤失败——TUI 和 Web UI 明明跟桌面版无关,却一起没构建出来,每次启动都报 a source update could not be finished automatically (6 attempts)。
现在这种情况会自动重试一次,跳过桌面版只装 ui-tui 和 web,TUI 和 Web UI 照常构建,桌面版被记成一笔待办:
Desktop app build owed: desktop dependencies failed同时它会打印一句很实在的提示:
ⓘ If this host never runs the desktop app, hermes uninstall --gui removes it and
  future updates stop building it.
也就是说,无头机器上最干净的解法是根本不带桌面版:
hermes uninstall --gui这条提示在两种情况下都会出现:上面那种重试成功之后,以及任何无头 Linux 更新(没有 DISPLAY / WAYLAND_DISPLAY)却选中了桌面版的时候。
你该怎么检查和处理
跑在 Docker 里:
- 先看你的容器是不是“某个版本之后突然少了一堆能力”——症状是 API Server、消息适配器、MCP 一起消失,代理显示降级;
- 换上新镜像重启即可,损坏的卷会在第一次启动时自动补回缺的 extra,不用重建卷;
- 如果暂时不能换镜像,也可以显式装上缺的 extra——但那只是补一次,基线问题还在,下一次懒装仍可能再丢。
跑在无头服务器上:
- 更新一直失败并报
could not be finished automatically,先看是不是桌面版的原生依赖装不上; - 确认这台机器不跑桌面版,就
hermes uninstall --gui把它从 checkout 里摘掉; - 这样以后的更新不会再为它装
node-pty/electron。
通用的两个观察点:
- 依赖问题很少是“某一个包坏了”,更常见是某一代基线被写错了;遇到“突然什么都缺”,先怀疑基线而不是逐个补包;
- 懒装在提供便利的同时会把“缺失”变成“新的默认”,所以当你想长期稳定,登记好的基线比临时补装更可靠。
小结
这次的两个修复其实在讲同一件事:依赖状态必须有一份可信的基线记录。Docker 镜像烤了八个 extra 却没登记,于是容器第一次自建依赖就把它们抹了;桌面版的原生模块装不上,却让跟它无关的 TUI 和 Web UI 一起交不了差。前者靠“构建时登记 + 启动时补齐”解决,后者靠“失败时降级到真正需要的那部分”解决。
想看相关的部署与运维内容,可以读在共享容器里跑 Hermes、state.db 的 WAL 问题和更新把磁盘撑爆了怎么救。命令细节见 hermes uninstall 与 hermes update 参考页,上手安装从安装指南开始。