点了一次更新,硬盘被写满 434GB
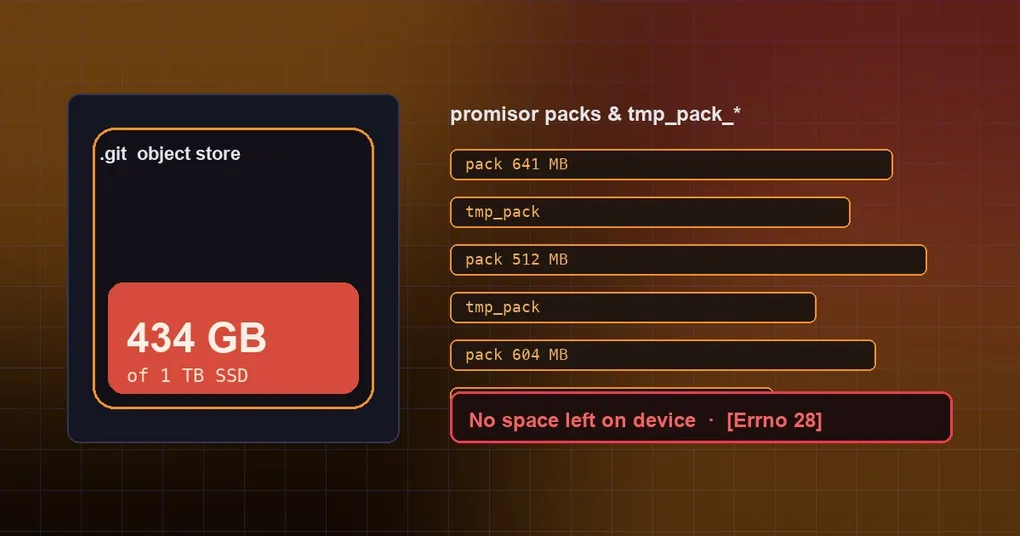
你在笔记本上点了「更新」,去泡了杯咖啡。回来的时候浏览器打不开、编辑器报磁盘写满,Hermes 自己也起不来了。你查了一圈,发现凶手是 ~/.hermes/hermes-agent/.git——它从 1GB 左右长到了 434 GB,把一块 1TB 的 SSD 吃干净了。
这不是「更新包太大」,而是一次后台版本检查在特定安装方式上触发了按需下载,然后滚成了雪球。这篇把机制、数字和清理步骤都讲清楚。
一次「只查某个路径」的 git 调用
Hermes 桌面版启动时会做一次版本一致性检查(内部叫 bundle-skew):判断「打包进应用的代码」和「磁盘上的代码」是不是对不上,对不上就提示重启。它跑两条 git 命令:
git merge-base --is-ancestor <stamp> HEAD
git rev-list --count <stamp>..HEAD -- apps/desktop/...
这两条本身都很便宜。问题出在安装方式上:部分安装是 treeless partial clone(--filter=tree:0,只按需取目录树,本地不保留历史里每个提交的树)。
而第二条命令带了路径过滤(-- apps/desktop/...)。git 想数出「这个范围内有几个提交动过 apps/desktop」,就必须读这段范围内每个提交的树。本地没有这些树,于是 git 走 promisor 机制联网按需取——每取一次,就在本地留下一个自己的 promisor pack。历史越长,要取的树越多,包也越多。
在报告这次事故的 issue 里,这段范围是 1784 个提交。
从 1GB 到 434GB:数字长什么样
以下数字都来自 issue #129514 的报告(macOS,1TB SSD):
| 项目 | 数值 |
|---|---|
.git 目录增长 |
完整克隆约 1.1 GB → 434 GB |
| promisor pack 数量 | 2,659 个(约 398 GiB) |
遗留的 tmp_pack_* 文件 |
1,309 个(约 29 GiB) |
| 单个 pack 最大 | 641 MB |
| 同时运行的后台维护进程 | 峰值 179 个(git maintenance run --auto → git commit-graph write --split --reachable),每个约 2GB 内存 |
| 系统负载 | load average 220 |
| 检查触发频率 | 重启后每约 2 分钟一次 rev-list,每个跑 9–15 分钟不完 |
| 最终结果 | 更新以 [Errno 28] No space left on device 失败,Mac 重启,之后 CLI/TUI 起不来 |
更早的迹象也在同一份报告里:9-25 生成了 138 个 promisor pack,9-27 有 11 个,9-28 有 339 个,中间还出现过一次意外重启。也就是说这不是某一次「运气不好」,而是一个会积累的模式。
为什么「已经修了」也救不了正在更新的人
修复在 9-28 就落地了。现在 main 上的检查代码是这样的:
const options = {
  cwd: repoRoot,
  env: { ...process.env, GIT_NO_LAZY_FETCH: '1', GIT_TERMINAL_PROMPT: '0', GCM_INTERACTIVE: 'Never' },
  timeoutMs: 5000
}
GIT_NO_LAZY_FETCH=1 的意思是:不许按需联网取对象,查不到就直接失败——这正是这套检查需要的语义(它本来就不该依赖网络)。加上 5 秒超时和进程树回收,理论上它再也不能把机器拖垮。
但是这里有个致命的时序问题,也是这份报告最有价值的部分:
跑这次检查的,是「已经安装在机器上的那个桌面版应用」,而它要等更新结束时才会被替换。
报告者的桌面版是 9-27 用 96cce68 构建的,比修复早一天。更新一开始拉进来 1,292 个提交,于是旧应用的检查开始走 96cce68..HEAD 这段——走的是旧代码,没有 GIT_NO_LAZY_FETCH。磁盘先被写满,更新在「替换桌面应用」这一步之前就失败了,于是旧应用留在原地;重启之后它接着循环。它不会自愈。
先确认自己有没有中招
四条只读命令,几秒钟就能看完:
du -sh ~/.hermes/hermes-agent/.git                          # 对象库大小,正常是 1GB 量级
ls ~/.hermes/hermes-agent/.git/objects/pack/*.pack | wc -l  # pack 数量,正常个位到两位数
ls ~/.hermes/hermes-agent/.git/objects/pack/tmp_pack_* | wc -l  # 未激活的下载残片,正常是 0
df -h ~                                                     # 剩余空间
再看一眼有没有一堆 git 在跑、负载是否异常:
uptime
ps aux | grep -E '[r]ev-list|[g]it maintenance' | wc -l
pack 数量上了三位数、tmp_pack_* 一大堆、负载几十以上——那基本就是同一个模式。
怎么收拾
下面是通用 git 清理顺序,不是官方命令,请先确认你理解每一步再执行:
- 先止损。 退出桌面应用(否则它会继续每两分钟触发一次),并把还在跑的
git rev-list、git maintenance进程停掉。此时不要急着开新会话做别的工作。 - 删掉未激活的残片。
.git/objects/pack/下的tmp_pack_*是没完成、也永远不会被 git 引用的下载残片,可以安全删除——在报告的场景里这一项就释放了约 29 GiB。 - 合并对象库。 用
git gc(必要时先git repack -ad)把散落的 pack 收拢。注意:2,659 个 pack 的仓库做 gc 会很慢、也很吃 CPU,最好在机器空闲时做,并盯着df -h。 - 把代码更新到修复后的版本。 关键是从命令行更新,而不是从那个旧的桌面应用里点更新——旧应用正是问题的来源。命令行更新的命令与参数见 hermes update 命令参考。如果你的安装是浅克隆/treeless 克隆且卡在这里,直接从官方渠道重新获取一份完整安装往往更快。
- 确认修复生效。 更新完成后,
~/.hermes/hermes-agent/apps/desktop/electron/bundle-skew.ts里应该能看到GIT_NO_LAZY_FETCH。看不到就说明你还在旧代码上。 - 给
.git设一个心理上限。 1GB 量级是正常的;几十 GB 说明有东西在偷偷拉历史,别等到磁盘满了才发现。
现状(如实说明)
截至 2026-10-01,issue #129514 仍然开着,被标为 P1;它是 #125932(同一机制、表现为「卡住几十个 git 进程」)的后续报告。修复本身在 main 上——bundle-skew.ts 现在带 GIT_NO_LAZY_FETCH=1 与 5 秒超时,hermes_cli/_subprocess_compat.py 里也有对应的 NO_LAZY_FETCH_ENV——但**「从修复前的构建升级」这条路本身没有保护**,这正是报告指出的核心问题。是否需要为旧版构建再加一层保护,还没有定论。
如果你正在用部分克隆(partial clone)安装,或者从桌面应用里点更新,建议今天就按上面的第一条和第二条检查一遍磁盘。
小结
这次事故里没有一行代码「写错了」。错误在于两个正确的决定撞在一起:为了省磁盘用 treeless 克隆,为了稳妥做版本一致性检查——而那个检查里有一条带路径过滤的历史遍历,在 treeless 仓库上等于「把这条历史全下载下来」。雪球滚起来之后,git 自己的后台维护又叠上来,把 CPU、内存、磁盘一起吃掉。
值得记住的信号有三个:.git 目录的大小、pack 文件的数量、以及 tmp_pack_* 残片的数量。它们都是几秒钟能看完的东西,却能在磁盘被写满之前很早就告诉你出事了。顺带一提,更新本身也不是只有这一种坑——更新卡住却报成功和优雅升级的做法都值得一读。