一次提交修掉三个“静默失败”:备份删错、JSON 写坏、引号被压平
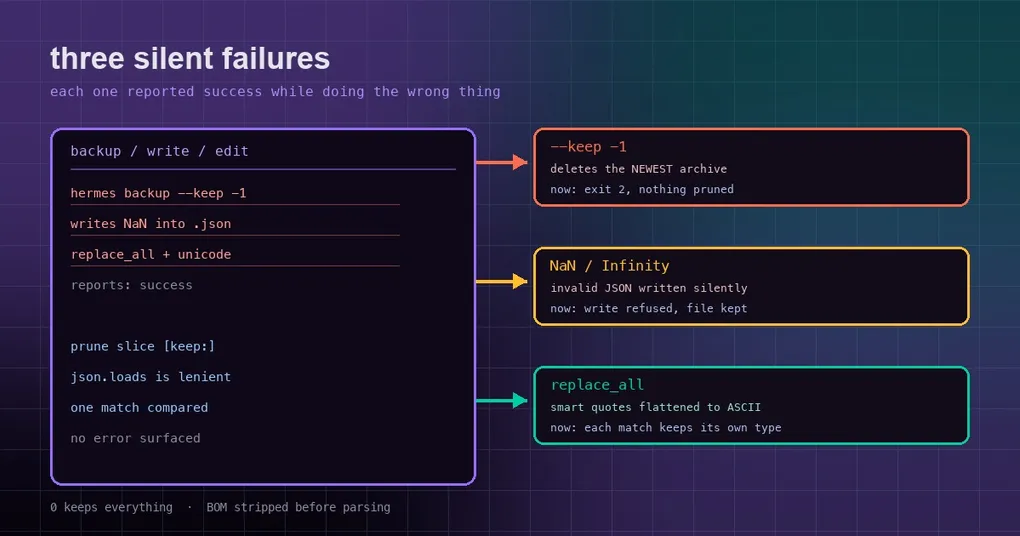
你的备份脚本跑完了,终端最后一行是 “Backup complete”,退出码 0。你安心去睡觉。第二天要恢复一份数据,你打开备份目录去找最新那个 hermes-backup-*.zip——它不见了,剩下的全是更早的。命令从头到尾没报错,可它删掉的偏偏是你最需要的那一份。
或者另一种场景:某个工具往你的 config.json 里写了一个值,本机加载一切正常;同事换另一种语言解析同一个文件,却直接抛异常——文件里多了个标准 JSON 根本不允许的东西。
这两件怪事,加上一个更隐蔽的排版问题,其实来自同一种失败模式:命令返回了成功,却做错了事。2026-10-01 合并的 PR #130619(P1 级)一次修掉了三个这样的坑,对应 issue #128886、#128888、#128894。下面逐个说清楚。
坑一:--keep -1 删掉的是最新的备份
先讲明白 --keep 是干嘛的。hermes backup --keep N 的意思是:完整备份跑完之后,把输出目录里超出最新 N 个的旧 hermes-backup-*.zip 删掉。默认 3,写 0 表示全部保留。(这些可以用 hermes backup --help 亲自核实。)
问题出在它是怎么解析这个数字的。修复前,--keep 用 type=int 解析,/snapshot prune N 用裸的 int()。这意味着 -1、+5 这类带符号的值都能通过,一路走到真正干活的那一行:
newest_first[keep:]这是个按「从新到旧」排好序的列表切片。keep 是 0 或正数时,它从尾巴上切掉旧归档,正是想要的效果;可 keep 是负数时,newest_first[-1:] 切出来的是最后一个元素——也就是最新的那个归档——然后把它删了。命令照样打印成功。
修复后,负数在入口就被拦下:
hermes_cli/subcommands/backup.py新增了_non_negative_keep作为 argparse 的类型函数,内部用isdecimal()判断,只放行不含符号的非负整数。负数、带符号、非整数现在都会以退出码 2 报错,信息是must be a non-negative integer (0 keeps everything)。- 交互式命令
/snapshot prune <N>用同一套isdecimal()规则:-1或x只会打印一行用法提示(Usage: /snapshot prune [keep-count]),什么都不删。
默认值仍是 3,0 仍然表示全部保留。
坑二:写 JSON 时混进了 NaN
第二个坑更隐蔽,因为它不在写入的那一刻暴露。
Hermes 写文件之前有一道「JSON 语法门」,用来拦住语法错误的内容。这道门用的是 Python 的 json.loads。麻烦在于,json.loads 默认接受 NaN、Infinity、-Infinity 这三个常量——它们是 JavaScript 的扩展,标准 JSON 里并不存在。于是「引入了这些常量」的写入顺利通过了语法门。你在本机用 Python 读它一切正常,但换个语言(Rust、Go、Node 的严格解析器)来读,这个文件就再也打不开了。
修复后(在 tools/file_operations.py),判断规则变得精确:只有当这次写入引入了该常量、而写入前文件里本来不含它时,才拒绝。具体边界是这样的:
- 一个本来就含
NaN的旧文件,仍然可以接受与这个常量无关的编辑——不会被锁死,不会编辑不进去。 - 新建文件如果含常量,拒绝,而且文件根本不会被创建。
- 解析前会先剥掉 BOM,避免 UTF-8 BOM 干扰判断。
- 带引号的
"NaN"(字符串)、1e308(合法的大数)、null都不受影响。
被拒绝时的错误信息是(英文原文):
Refusing to write '<path>': candidate content uses NaN, which is not valid JSON. The file was NOT created or modified. Use null or a string instead and retry.关键在最后那句 “The file was NOT created or modified”:拒绝发生在写入之前,磁盘上的文件一个字节都没动。
坑三:批量替换把你的引号和破折号压平了
第三个坑和排版有关,而且只有开了批量替换才会中招。
Hermes 的模糊匹配里有一条 unicode_normalized 策略:把弯引号、长破折号这类 Unicode 变体先归一化,再拿来比较。这样你在搜索里敲的是 "(直引号),文件里是 “…”(智能引号)时,也能匹配上。匹配到之后,还有一步负责「保留文件原本的 Unicode 排版」——用文件里本来的智能引号,而不是把新的直引号硬塞进去;否则你只改了一处文字,整段的引号风格却被换成了 ASCII。
问题出在开了 replace_all(一次替换多处)的时候。那一步「保留排版」的实现,是拿所有命中区域拼在一起去和归一化后的 old_string 比较的。只有一处命中时这个比较成立,多处时永远不成立——拼起来的内容和单个 old_string 根本不等长。比较失败后,代码退化成用 ASCII 版本替换每一处。结果就是:文件里所有的智能引号和长破折号,全被压成了 " 和 --。
修复后(在 tools/fuzzy_match.py):
_unicode_edit_plan()只计算一次「旧→新」的编辑操作表,而且这份表与具体落在文件的哪个区域无关,所以replace_all可以复用它。_apply_replacements对每一处命中区域,各自套用_preserve_unicode_in_replacement,再重新缩进。于是每一处都保留它自己原来的排版——同一份文件里一处用智能引号、另一处用直引号,替换后各自不变。
三个坑的共同点:都返回成功
把这三个 bug 摆在一起看,会发现它们是同一件事的三种面孔。
--keep -1:命令打印成功、退出码 0,却删了最新的备份。- 写入 NaN:语法门放行,写入「成功」,换个解析器才炸。
- 压平排版:替换报告成功、命中数也正确,但文件被改得比预期更狠。
它们都不是崩溃。崩溃反而好办——你会立刻发现、立刻回滚。真正伤人的是返回成功:没有报错、没有异常、没有非零退出码,你只能在下一次用到它的时候(恢复备份、换个语言读 JSON、diff 出一片引号)才发现损失,而那时往往已经过去很久。
根子也类似:校验站在了错误的位置。--keep 该在入口拒绝负数,却让负数一路走到了切片;JSON 该检查「这次写入有没有引入标准不允许的东西」,却只检查了「Python 能不能读懂」;排版保留该按每处命中单独处理,却用了整段拼接。每个修复做的都是同一件事——把检查挪到真正做决策的那个点上。
你现在该怎么做
这部分不用改任何配置,几分钟就能自查:
- 定期看一眼备份目录。
ls ~/hermes-backup-*.zip,确认最新那份还在、时间戳对得上。如果你之前用过负数 keep,尤其值得确认。 - 把重要的
.json交给严格解析器验一次。 比如在 Python 里json.loads(..., parse_constant=...)会主动拒绝 NaN/Infinity,或者用任何一门语言的严格 JSON 库读一遍。本机读得开,不代表别处读得开。 - 检查批量替换过的文件。 如果你用过
replace_all,用grep -n找一下直引号"或连续两个短横线--——本该是智能引号或长破折号的地方,可能就是被压平的痕迹。
关于版本,这里要说实话:最新正式版是 v0.21.5(tag v2026.9.24,2026-09-24 发布),而这个改动 2026-10-01 才合入,所以它目前只在 main 分支上,还没进任何正式版本。跟着 main 分支安装的话,下次 hermes update 就会带上;正式用户会在下一个 tag 拿到。
小结
- 三个 P1 issue(#128886 / #128888 / #128894)由 PR #130619 一次修复,它们都属于「返回成功却做错事」的静默失败。
hermes backup --keep -1和/snapshot prune -1过去会删掉最新的归档;现在负数在入口被拒绝(退出码 2,或只打印用法行),默认 3、0全留的语义不变。- 写 JSON 时引入的
NaN/Infinity/-Infinity现在会被拒绝且不落盘;本来就含常量的旧文件仍可接受无关编辑。 unicode_normalized配上replace_all过去把全文的智能引号/长破折号压平,现在每一处命中各自保留自己的排版。- 这些改动只在 main 分支,尚未进入任何正式版本,下一个 tag 才会到达正式用户。
想更细地了解相关机制,可以看 hermes backup 命令参考、hermes config 命令参考,以及 凭据脱敏 与 Keychain 密钥加密 这两篇——它们讲的都是同一类信任问题:本机看着没事,隔一层就出事。