Ein Commit, drei stille Fehlschläge: Backup löschte die falsche Datei, JSON falsch geschrieben, Anführungszeichen plattgemacht
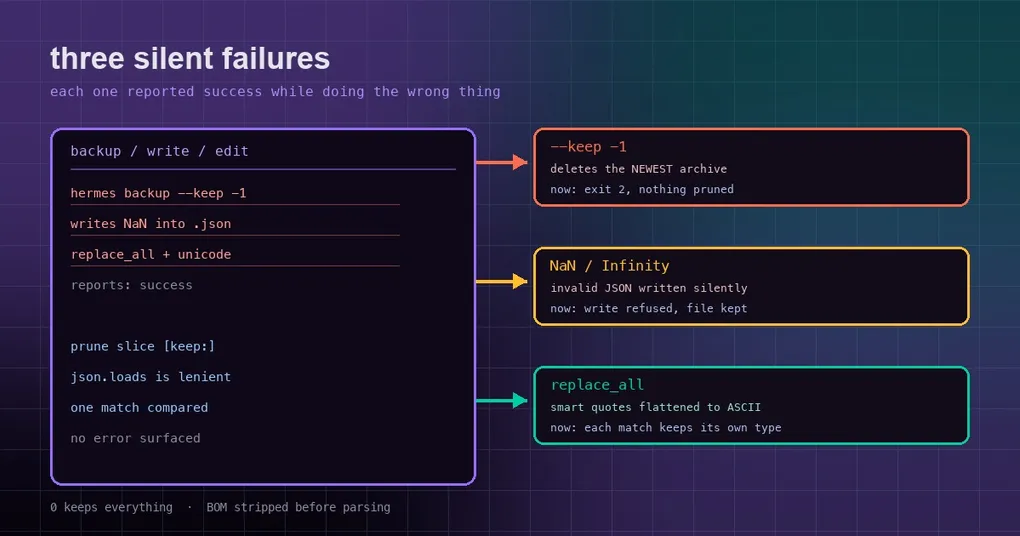
Dein Backup-Skript läuft durch und druckt eine letzte Zeile: „Backup complete“, Exit-Code 0. Du gehst ins Bett. Am nächsten Tag greifst du nach der neuesten hermes-backup-*.zip, um etwas wiederherzustellen – und sie ist weg. Jedes noch vorhandene Archiv ist älter als das, das du brauchtest. Der Befehl warf nie einen Fehler; er löschte nur genau die Datei, auf die du dich verlassen hast.
Oder das: Ein Tool schreibt einen Wert in deine config.json. Auf deiner Maschine lädt sie einwandfrei. Ein Kollege parst dieselbe Datei mit einer anderen Sprache und bekommt eine Exception – die Datei enthält etwas, das Standard-JSON nicht zulässt.
Diese beiden plus ein leiseres Formatierungsproblem teilen einen Fehlermodus: Der Befehl meldete Erfolg, während er das Falsche tat. PR #130619 (P1, gemergt am 2026-10-01) schließt drei Bugs genau dieser Form und behebt die Issues #128886, #128888 und #128894. Hier kommt jeder einzelne.
Fallstrick 1: --keep -1 löscht dein neuestes Backup
Zuerst, was --keep eigentlich tun soll. hermes backup --keep N bedeutet: Nach einem vollständigen Backup werden ältere hermes-backup-*.zip-Dateien im Ausgabeverzeichnis gelöscht, die über die neuesten N hinausgehen. Der Standard ist 3, und 0 behält alles. (Du kannst das selbst mit hermes backup --help bestätigen.)
Der Bug lag darin, wie diese Zahl geparst wurde. Vor dem Fix nutzte --keep type=int und /snapshot prune N ein blankes int(). Das ließ vorzeichenbehaftete Werte wie -1 oder +5 durch, bis hinunter zu der Zeile, die die Arbeit macht:
newest_first[keep:]Das ist ein Slice über eine Liste, die nach Neuheit sortiert ist (neueste zuerst). Wenn keep 0 oder positiv ist, schneidet es die alten Archive am Ende ab, was richtig ist. Wenn keep negativ ist, schneidet newest_first[-1:] das letzte Element heraus – das neueste Archiv – und löscht es. Der Befehl druckt trotzdem Erfolg.
Nach dem Fix wird der negative Wert an der Tür abgewiesen:
hermes_cli/subcommands/backup.pyfügt_non_negative_keepals argparse-Typ hinzu und nutzt internisdecimal(), sodass nur eine vorzeichenlose, nicht negative ganze Zahl durchkommt. Negative, vorzeichenbehaftete oder nicht ganzzahlige Eingaben schlagen jetzt mit Exit-Code 2 und der Meldungmust be a non-negative integer (0 keeps everything)fehl.- Das interaktive
/snapshot prune <N>nutzt dieselbeisdecimal()-Regel:-1oderxdruckt die Usage-Zeile (Usage: /snapshot prune [keep-count]) und löscht nichts.
Der Standard ist weiterhin 3, und 0 bedeutet weiterhin, alles zu behalten.
Fallstrick 2: Ein JSON-Write schmuggelt NaN ein
Der zweite ist heimtückischer, weil er im Moment des Schreibens nicht auffällt.
Bevor Hermes eine Datei schreibt, läuft ein JSON-Syntax-Gate, um fehlerhaften Inhalt abzufangen. Dieses Gate nutzte Pythons json.loads. Das Problem: json.loads akzeptiert NaN, Infinity und -Infinity standardmäßig – JavaScript-Erweiterungen, die Standard-JSON nicht hat. Ein Write, der diese Konstanten einführte, kam also durch das Gate. Auf deiner Maschine liest Python es einwandfrei zurück, aber in dem Moment, in dem eine andere Sprache (ein strikter Rust-, Go- oder Node-Parser) es liest, öffnet sich die Datei nie wieder.
Nach dem Fix (tools/file_operations.py) ist die Regel präzise: nur abweisen, wenn dieser Write eine Konstante einführt, die die Datei noch nicht enthielt. Die Randfälle:
- Eine alte Datei, die bereits
NaNenthält, akzeptiert weiterhin unabhängige Änderungen – sie ist nicht eingefroren. - Eine neue Datei, die eine Konstante enthält, wird abgewiesen und überhaupt nie erstellt.
- Ein BOM wird vor dem Parsen entfernt, sodass ein UTF-8-BOM die Prüfung nicht verwirren kann.
- Ein in Anführungszeichen gesetzter
"NaN"-String,1e308(eine legale große Zahl) undnullsind alle nicht betroffen.
Die Ablehnungsmeldung lautet:
Refusing to write '<path>': candidate content uses NaN, which is not valid JSON. The file was NOT created or modified. Use null or a string instead and retry.Beachte den letzten Satz – „The file was NOT created or modified“: Die Ablehnung geschieht vor dem Write, sodass sich kein Byte auf der Platte ändert.
Fallstrick 3: replace_all machte deine Anführungszeichen und Gedankenstriche platt
Der dritte dreht sich um Typografie und beißt nur zu, wenn du Batch-Ersetzung nutzt.
Hermes’ Fuzzy-Matching enthält eine unicode_normalized-Strategie: Sie normalisiert Unicode-Varianten wie typografische Anführungszeichen und Em-Dashes vor dem Vergleich. So trifft ein " (gerades Anführungszeichen) in deiner Suche trotzdem „…“ (typografische Anführungszeichen) in der Datei. Nach einem Treffer soll ein separater Schritt das ursprüngliche Unicode der Datei bewahren – die eigenen typografischen Anführungszeichen der Datei behalten, statt die neuen geraden einzusetzen, damit das Bearbeiten einer Phrase nicht einen ganzen Absatz auf ASCII umstylt.
Der Bug trat auf, wenn replace_all (jedes Vorkommen ersetzen) aktiv war. Dieser Bewahrungsschritt verglich alle getroffenen Regionen zusammenhängend mit dem normalisierten old_string. Bei einem einzelnen Treffer hielt das; bei mehreren konnte es nie halten – die Verkettung ist schlicht nicht derselbe Text wie ein old_string. Der Vergleich schlug fehl, der Code fiel darauf zurück, die ASCII-Version an jede Stelle einzusetzen, und jedes typografische Anführungszeichen und jeder Em-Dash in der Datei wurde zu " und -- plattgemacht.
Nach dem Fix (tools/fuzzy_match.py):
_unicode_edit_plan()berechnet die Alt-zu-Neu-Edit-Tabelle einmal, unabhängig von einer bestimmten Datei-Region, sodassreplace_allsie wiederverwenden kann._apply_replacementswendet_preserve_unicode_in_replacementauf jede getroffene Region separat an und rückt dann neu ein. Jeder Treffer behält seine eigene ursprüngliche Typografie – ein Vorkommen kann typografische Anführungszeichen nutzen, während ein anderes gerade nutzt, und jedes bleibt, wie es war.
Was die drei gemeinsam haben: Sie melden alle Erfolg
Reiht man die drei auf, sind sie drei Gesichter einer Sache:
--keep -1: druckt Erfolg, beendet mit 0, löscht das neueste Backup.- Der NaN-Write: kommt durch das Syntax-Gate, „gelingt“, fliegt nur in einem anderen Parser auf.
- Das Plattmachen: meldet Erfolg mit korrekter Trefferzahl, aber die Datei ist stärker beschädigt, als du verlangt hast.
Keiner von ihnen stürzt ab. Ein Absturz wäre einfach – du würdest ihn sehen, zurückrollen, weitermachen. Der gefährliche Teil ist das Erfolg-Zurückmelden: kein Fehler, keine Exception, kein Nicht-Null-Exit. Den Schaden findest du erst bei der nächsten Nutzung (das Backup wiederherstellen, das JSON woanders lesen, in einem Diff gegen eine Wand aus geraden Anführungszeichen laufen), oft lange danach.
Die Grundursache ist ebenfalls geteilt: Die Validierung saß an der falschen Stelle. --keep hätte Negative an der Tür abweisen sollen, ließ sie aber bis zum Slice durch. Das JSON-Gate hätte prüfen sollen, ob „dies etwas einführt, was der Standard verbietet“, prüfte aber nur, ob „Python es lesen kann“. Die Typografie-Bewahrung hätte pro Vorkommen laufen sollen, nutzte aber ein verkettetes Ganzes. Jeder Fix tut dasselbe: Die Prüfung an die Stelle verschieben, an der die Entscheidung tatsächlich fällt.
Was jetzt zu tun ist
Nichts zu konfigurieren; das sind ein paar Minuten Selbstprüfung:
- Wirf einen Blick in dein Backup-Verzeichnis.
ls ~/hermes-backup-*.zipund bestätige, dass die neueste Datei mit einem plausiblen Zeitstempel vorhanden ist. Wenn du je ein negatives Keep genutzt hast, prüfe das genau. - Validiere wichtige
.json-Dateien mit einem strikten Parser. In Python wirdjson.loads(..., parse_constant=...)NaN/Infinity aktiv zurückweisen, oder lies die Datei einfach mit einer beliebigen strikten JSON-Bibliothek in einer anderen Sprache. „Auf meiner Maschine öffnet sie sich“ heißt nicht, dass sie sich woanders öffnet. - Prüfe Dateien, die du mit
replace_allgebatcht hast.grep -nnach einem geraden Anführungszeichen"oder einem doppelten Bindestrich--– wo ein typografisches Anführungszeichen oder Em-Dash stehen sollte, ist die Signatur des Plattmachens.
Zum Versionsstatus, Ehrlichkeit zuerst: Das neueste stabile Release ist v0.21.5 (Tag v2026.9.24, veröffentlicht 2026-09-24), und diese Änderung landete erst am 2026-10-01 – sie ist also nur auf dem main-Branch und noch in keinem Release ausgeliefert. Wenn du main trackst, bringt dein nächstes hermes update sie mit; stabile Nutzer bekommen sie beim nächsten Tag.
Die Kurzfassung
- Drei P1-Issues (#128886 / #128888 / #128894) werden gemeinsam von PR #130619 behoben – allesamt stille Fehlschläge, die „Erfolg zurückmeldeten, während sie das Falsche taten“.
hermes backup --keep -1und/snapshot prune -1löschten früher das neueste Archiv; Negative werden jetzt an der Tür abgewiesen (Exit-Code 2 oder eine Usage-Zeile), während der Standard 3 und „0 behält alles“ unverändert sind.- Ein JSON-Write, der
NaN/Infinity/-Infinityeinführt, wird jetzt abgewiesen und landet nie; eine Datei, die die Konstante bereits hatte, nimmt weiterhin unabhängige Änderungen an. unicode_normalizedplusreplace_allmachten früher jedes typografische Anführungszeichen und jeden Em-Dash platt; jedes Vorkommen behält jetzt seine eigene Typografie.- Die Änderung ist nur auf main, in keinem Release, und erreicht stabile Nutzer beim nächsten Tag.
Für die Mechanik im Detail siehe die hermes backup Befehlsreferenz, die hermes config Befehlsreferenz, und die Artikel zur Credential-Redaktion und zur Keychain-Secret-Verschlüsselung – sie alle behandeln dieselbe Familie von Vertrauensproblem: lokal sieht es gut aus und bricht eine Schicht weiter weg.