Un seul commit, trois échecs silencieux : la sauvegarde supprimait le mauvais fichier, le JSON était mal écrit, les guillemets aplatis
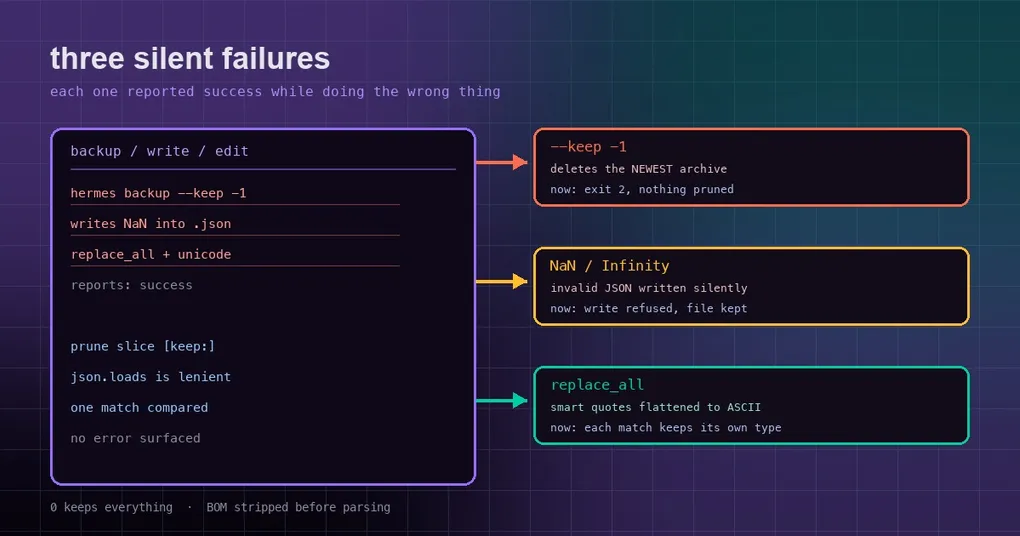
Votre script de sauvegarde se termine et affiche une dernière ligne : “Backup complete”, code de sortie 0. Vous allez vous coucher. Le lendemain, vous tendez la main vers le plus récent hermes-backup-*.zip pour restaurer quelque chose — et il a disparu. Chaque archive encore présente est plus ancienne que celle dont vous aviez besoin. La commande n’a jamais renvoyé d’erreur ; elle a juste supprimé exactement le fichier sur lequel vous comptiez.
Ou encore : un outil écrit une valeur dans votre config.json. Il se charge sans problème sur votre machine. Un collègue analyse le même fichier avec un autre langage et obtient une exception — le fichier contient quelque chose que le JSON standard n’autorise pas.
Ces deux cas, plus un problème de formatage plus discret, partagent un même mode de défaillance : la commande a renvoyé un succès tout en faisant la mauvaise chose. La PR #130619 (P1, fusionnée le 2026-10-01) corrige trois bugs exactement de cette forme, réglant les issues #128886, #128888 et #128894. Voici chacun d’eux.
Piège 1 : --keep -1 supprime votre sauvegarde la plus récente
D’abord, à quoi sert --keep. hermes backup --keep N signifie : après une sauvegarde complète, supprimer les fichiers hermes-backup-*.zip plus anciens dans le répertoire de sortie au-delà des N plus récents. La valeur par défaut est 3, et 0 conserve tout. (Vous pouvez le vérifier vous-même avec hermes backup --help.)
Le bug était dans la façon dont ce nombre était analysé. Avant le correctif, --keep utilisait type=int et /snapshot prune N un simple int(). Cela laissait passer des valeurs signées comme -1 ou +5, jusqu’à la ligne qui fait le travail :
newest_first[keep:]C’est un slice sur une liste triée du plus récent au plus ancien. Quand keep vaut 0 ou est positif, il rogne les vieilles archives par la fin, ce qui est correct. Quand keep est négatif, newest_first[-1:] découpe le dernier élément — l’archive la plus récente — et la supprime. La commande affiche toujours un succès.
Après le correctif, la valeur négative est rejetée à l’entrée :
hermes_cli/subcommands/backup.pyajoute_non_negative_keepcomme type argparse, utilisantisdecimal()en interne pour que seul un entier non signé et non négatif passe. Une entrée négative, signée ou non entière échoue désormais avec le code de sortie 2 et le messagemust be a non-negative integer (0 keeps everything).- Le
<N>de/snapshot pruneen interactif utilise la même règleisdecimal():-1ouxaffiche la ligne d’usage (Usage: /snapshot prune [keep-count]) et ne supprime rien.
La valeur par défaut reste 3, et 0 signifie toujours tout conserver.
Piège 2 : une écriture JSON laisse passer un NaN
Le deuxième est plus sournois, parce qu’il ne se manifeste pas au moment de l’écriture.
Avant d’écrire un fichier, Hermes exécute un contrôle de syntaxe JSON pour détecter un contenu malformé. Ce contrôle utilisait le json.loads de Python. Le problème : json.loads accepte NaN, Infinity et -Infinity par défaut — des extensions JavaScript que le JSON standard n’a pas. Ainsi, une écriture qui introduisait ces constantes passait le contrôle. Elle se relit sans problème en Python sur votre machine, mais dès qu’un autre langage (un parseur strict Rust, Go ou Node) la lit, le fichier ne s’ouvre plus jamais.
Après le correctif (tools/file_operations.py), la règle est précise : refuser uniquement quand cette écriture introduit une constante que le fichier ne contenait pas déjà. Les cas limites :
- Un ancien fichier qui contient déjà
NaNaccepte toujours des modifications sans rapport — il n’est pas gelé. - Un nouveau fichier contenant une constante est refusé, et jamais créé du tout.
- Un BOM est retiré avant l’analyse, un BOM UTF-8 ne peut donc pas tromper le contrôle.
- Une chaîne entre guillemets
"NaN",1e308(un grand nombre légal) etnullne sont pas affectés.
Le message de rejet se lit :
Refusing to write '<path>': candidate content uses NaN, which is not valid JSON. The file was NOT created or modified. Use null or a string instead and retry.Notez la dernière phrase — “The file was NOT created or modified” : le refus intervient avant l’écriture, donc pas un byte sur le disque ne change.
Piège 3 : replace_all a aplati vos guillemets et vos tirets
Le troisième concerne la typographie, et ne mord que lorsque vous utilisez le remplacement par lot.
Le matching flou de Hermes inclut une stratégie unicode_normalized : il normalise des variantes Unicode comme les guillemets courbes et les tirets cadratins avant de comparer. Ainsi, un " (guillemet droit) dans votre recherche correspond toujours à “…” (guillemets typographiques) dans le fichier. Après une correspondance, une étape distincte est censée préserver l’Unicode d’origine du fichier — garder les guillemets typographiques propres au fichier plutôt que d’y déposer les nouveaux guillemets droits, pour que l’édition d’une phrase ne restyle pas tout un paragraphe en ASCII.
Le bug apparaissait quand replace_all (remplacer toutes les occurrences) était activé. Cette étape de préservation comparait toutes les régions correspondantes concaténées au old_string normalisé. Avec une seule correspondance, elle tenait ; avec plusieurs, elle ne le pouvait jamais — la concaténation n’est tout simplement pas le même texte qu’un seul old_string. La comparaison échouait, le code retombait sur l’insertion de la version ASCII à chaque endroit, et chaque guillemet typographique et tiret cadratin du fichier était aplati en " et --.
Après le correctif (tools/fuzzy_match.py) :
_unicode_edit_plan()calcule la table d’édition ancien-vers-nouveau une fois, indépendamment de toute région particulière du fichier, doncreplace_allpeut la réutiliser._apply_replacementsapplique_preserve_unicode_in_replacementà chaque région correspondante séparément, puis réindente. Chaque occurrence conserve sa propre typographie d’origine — une occurrence peut utiliser des guillemets typographiques tandis qu’une autre utilise des guillemets droits, et chacune reste telle quelle.
Ce que les trois ont en commun : elles renvoient toutes un succès
Alignez les trois et ce sont trois visages d’une même chose :
--keep -1: affiche un succès, sort en 0, supprime la sauvegarde la plus récente.- L’écriture NaN : passe le contrôle de syntaxe, “réussit”, n’explose que dans un autre parseur.
- L’aplatissement : signale un succès avec un nombre de correspondances correct, mais le fichier est plus abîmé que demandé.
Aucune ne plante. Un plantage serait facile — vous le verriez, vous reviendriez en arrière, vous passeriez à autre chose. La partie dangereuse, c’est de renvoyer un succès : pas d’erreur, pas d’exception, pas de code de sortie non nul. Vous ne découvrez les dégâts qu’à l’usage suivant (restaurer la sauvegarde, lire le JSON ailleurs, faire un diff dans un mur de guillemets droits), souvent bien plus tard.
La cause racine est partagée elle aussi : la validation se trouvait au mauvais endroit. --keep aurait dû rejeter les négatifs à l’entrée, mais les laissait atteindre le slice. Le contrôle JSON aurait dû vérifier “est-ce que cela introduit quelque chose que le standard interdit”, mais ne vérifiait que “Python peut-il le lire”. La préservation de la typographie aurait dû s’exécuter par occurrence, mais utilisait un ensemble concaténé. Chaque correctif fait la même chose : déplacer le contrôle à l’endroit où la décision se prend réellement.
Que faire maintenant
Rien à configurer ; c’est quelques minutes d’auto-vérification :
- Jetez un œil à votre répertoire de sauvegarde.
ls ~/hermes-backup-*.zipet confirmez que le plus récent est présent avec un horodatage sensé. Si vous avez déjà utilisé un keep négatif, vérifiez cela de près. - Validez les fichiers
.jsonimportants avec un parseur strict. En Python,json.loads(..., parse_constant=...)rejettera activement NaN/Infinity, ou lisez simplement le fichier avec n’importe quelle bibliothèque JSON stricte d’un autre langage. “Ça s’ouvre sur ma machine” ne veut pas dire que ça s’ouvre ailleurs. - Vérifiez les fichiers que vous avez traités par lot avec
replace_all.grep -npour un guillemet droit"ou un double tiret--— là où devraient se trouver un guillemet typographique ou un tiret cadratin, c’est la signature de l’aplatissement.
Sur l’état des versions, l’honnêteté d’abord : la dernière version stable est la v0.21.5 (tag v2026.9.24, publiée le 2026-09-24), et ce changement n’est arrivé que le 2026-10-01 — il est donc sur la branche main uniquement et n’a été livré dans aucune version. Si vous suivez main, votre prochain hermes update l’intègre ; les utilisateurs de stable l’obtiendront au prochain tag.
La version courte
- Les trois issues P1 (#128886 / #128888 / #128894) sont corrigées ensemble par la PR #130619 — toutes des défaillances silencieuses qui “renvoyaient un succès tout en faisant la mauvaise chose”.
hermes backup --keep -1et/snapshot prune -1supprimaient auparavant l’archive la plus récente ; les négatifs sont désormais rejetés à l’entrée (code de sortie 2, ou une ligne d’usage), tandis que la valeur par défaut 3 et le “0 conserve tout” restent inchangés.- Une écriture JSON qui introduit
NaN/Infinity/-Infinityest désormais refusée et n’atterrit jamais ; un fichier qui contenait déjà la constante continue d’accepter des modifications sans rapport. unicode_normalizedcombiné àreplace_allaplatissait chaque guillemet typographique et tiret cadratin ; chaque occurrence conserve désormais sa propre typographie.- Le changement est sur main uniquement, dans aucune version, et atteint les utilisateurs de stable au prochain tag.
Pour les mécanismes plus en profondeur, consultez la référence de la commande hermes backup, la référence de la commande hermes config, et les articles sur la rédaction des identifiants et le chiffrement des secrets du Keychain — ils couvrent tous la même famille de problème de confiance : ça a l’air correct en local et ça casse à une couche de distance.