Quando uma skill fica grande demais, o Hermes só vê os primeiros 1.500 caracteres
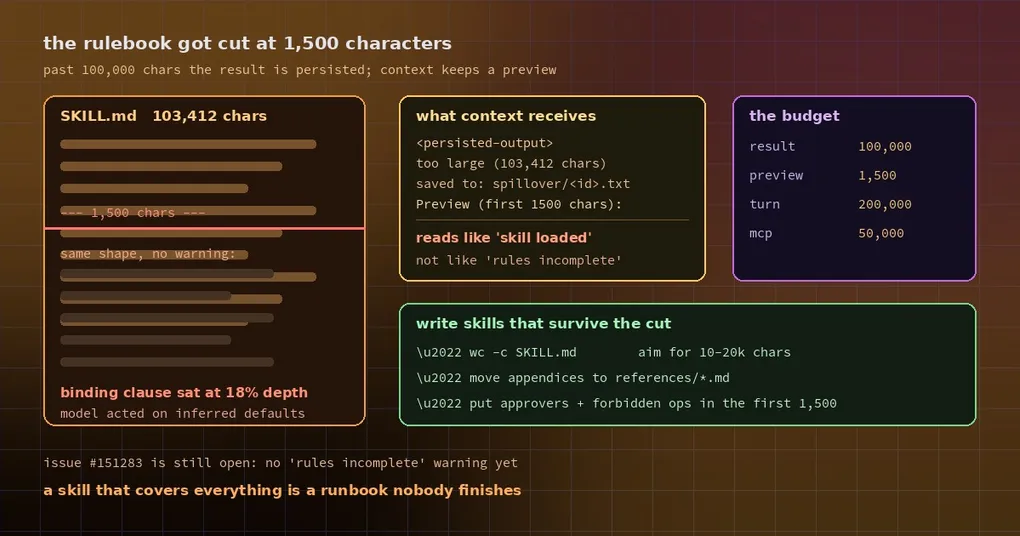
Você passou seis meses fazendo um SKILL.md crescer em torno de um procedimento de deploy: fazer backup primeiro, depois liberar para 10%, voltar para esta tag se a taxa de erro subir, e sempre entregar a mudança para a pessoa X aprovar. Trinta páginas, editadas dezenas de vezes, um parágrafo acrescentado a cada vez. Um dia o agente executa a skill, acerta a primeira metade exatamente, e entrega a mudança para o aprovador errado — porque a cláusula “sempre X” simplesmente não estava no que ele leu.
O modelo não desobedeceu. Ele nunca viu aquela seção.
O orçamento rígido: 100.000 caracteres por resultado de ferramenta
O Hermes aplica um orçamento geral aos resultados de ferramentas. Acima de 100.000 caracteres, um resultado deixa de ser colocado inteiro no contexto: ele é gravado em um arquivo de spillover no disco, e o modelo recebe um preview mais um caminho.
Esse design faz sentido. Um fetch de página, um find, um tail de log podem chegar a centenas de milhares de caracteres; carregar tudo isso é caro e ocupa o espaço do que realmente importa. Então os limites se acumulam:
| Limite | Padrão | Efeito |
|---|---|---|
| Limiar por resultado | 100.000 caracteres | Acima disso, persiste em disco e mantém um preview |
| Tamanho do preview | 1.500 caracteres | O texto que realmente fica visível no contexto |
| Orçamento por turno | 200.000 caracteres | Total somado de todos os resultados de ferramenta em um turno |
| Resultados de ferramentas MCP | 50.000 caracteres | Payloads MCP costumam ser maiores e menos paginados |
O problema é que o orçamento não distingue dados de regras.
Para uma skill, truncar não economiza espaço — descarta regras
skill_view retorna um objeto JSON: o corpo, linked_files, metadados. Quando o corpo cresce o suficiente para que o JSON inteiro passe de 100.000 caracteres, ele é persistido como qualquer outro resultado, e o contexto recebe isto no lugar:
<persisted-output>
This tool result was too large (103,412 characters, 101.0 KB).
Full output saved to: ~/.hermes/cache/spillover/<id>.txt
Use the read_file tool with offset and limit to access specific sections of this output.
...
Preview (first 1500 chars):
...
</persisted-output>
Para uma página raspada da web, esse aviso cumpre o papel: o modelo sabe que o conteúdo está em disco e vai lê-lo. Para uma skill, o modelo tende a interpretar como “skill carregada”. O preview tem um título, os primeiros passos, a formatação — parece completo. Nada informa ao modelo que a cláusula a 18% de profundidade, justamente a que nomeia o aprovador correto, foi descartada.
É exatamente o cenário da issue #151283. A skill de quem reportou trazia um parâmetro fixo de produção que não podia ser inferido; depois do truncamento, o agente seguiu com defaults inferidos e executou uma escrita que mudou estado em um sistema corporativo em produção. A conclusão deles é a parte importante: a falha é silenciosa e assimétrica — inofensiva para um payload de dados, danosa para um payload de política.
O que realmente cabe em 1.500 caracteres
Há um detalhe cuidadoso na implementação. Resultados de skill são JSON, e persistir isso literalmente colocaria o documento inteiro em uma única linha com quebras de linha escapadas, o que torna a paginação offset/limit do read_file inútil. Então, antes de persistir, a string multilinha mais longa é desenrolada em texto puro paginável, e campos estruturados como linked_files e metadata são movidos para depois do texto, para que não consumam o preview.
O resultado prático: o preview mostra os campos escalares (status, caminhos) e depois os primeiros 1.500 caracteres do corpo.
Para uma skill de dois mil palavras, isso é bastante. Para uma skill de cem mil caracteres, é um sumário.
Como escrever skills que evitam isso
Você não precisa esperar por uma correção. Os hábitos são baratos:
1. Meça o tamanho primeiro. No diretório da skill:
wc -c ~/.hermes/skills/<category>/<skill>/SKILL.mdDe dez a vinte mil caracteres é saudável. Passando de cinquenta mil, comece a planejar uma divisão — não porque o truncamento seja certo, mas porque você está a um “só vou acrescentar isto aqui” da linha.
2. Mova apêndices longos para references/. Skills podem incluir arquivos de apoio; o skill_view os reporta como linked_files. Deixe o SKILL.md para o procedimento e as regras inegociáveis, e coloque inventários de comandos, diferenças entre plataformas e históricos de casos em references/algo.md, lidos apenas quando necessário. O documento principal encolhe e cada carregamento continua focado.
3. Coloque as regras vinculantes no topo. O preview são os primeiros 1.500 caracteres. Aprovadores, operações proibidas, parâmetros obrigatórios — qualquer coisa em que uma palavra errada vire incidente — pertence às primeiras centenas de caracteres, não a uma seção de ressalvas três capítulos abaixo.
4. Se aparecer persisted-output, vá ler o arquivo. Quando esse aviso surgir e o resultado for uma skill, não presuma que você tem o conteúdo inteiro. Abra o caminho com read_file e percorra a parte que falta com offset/limit.
5. Uma skill não fica melhor por ser exaustiva. Uma skill que cobre tudo é um runbook que ninguém termina. Separar “deve ser seguido sempre” de “consultar de vez em quando” é a correção de raiz.
Onde as coisas estão
Na data em que este texto é escrito, a issue #151283 continua aberta: o skill_view ainda não avisa que regras foram descartadas. A proteção hoje é disciplina de quem escreve a skill, não ferramenta.
Skills crescem como documentos sempre crescem — um parágrafo por vez, ao longo de meses, muito além do tamanho que alguém planejou. Medir de vez em quando e tirar os apêndices de dentro é o seguro mais barato que existe.
Relacionado: comandos de gerenciamento de skills, skills locais do projeto dentro de um repositório e as três novas skills opcionais.