Cuando una skill crece demasiado, Hermes solo ve los primeros 1.500 caracteres
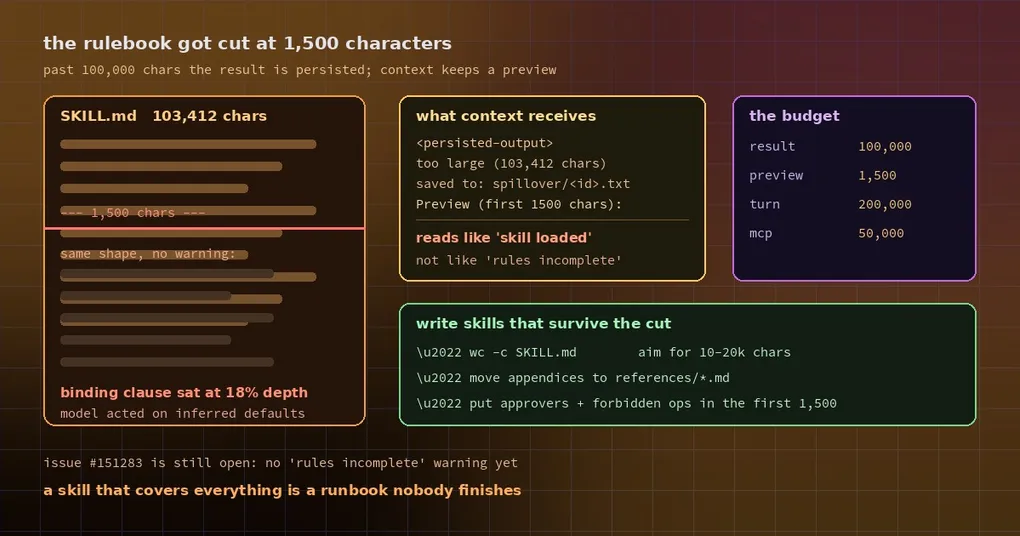
Llevas seis meses haciendo crecer un SKILL.md en torno a un procedimiento de despliegue: primero la copia de seguridad, luego un rollout al 10%, rollback a esta etiqueta si se mueven las tasas de error, y pasar siempre el cambio a la persona X para que lo apruebe. Treinta páginas, editadas docenas de veces, un párrafo añadido en cada una. Y un día el agente ejecuta la skill, acierta la primera mitad exactamente, y entrega el cambio al aprobador equivocado — porque la cláusula «siempre X» simplemente no estaba en lo que leyó.
El modelo no desobedeció. Nunca vio esa sección.
El presupuesto duro: 100.000 caracteres por resultado de herramienta
Hermes aplica un presupuesto general a los resultados de herramientas. Pasados los 100.000 caracteres, un resultado ya no se coloca entero en el contexto: se escribe en un archivo de spillover en disco, y el modelo recibe una vista previa más una ruta.
Ese diseño tiene sentido. Un fetch de página, un find, un tail de log pueden llegar a cientos de miles de caracteres; cargarlo todo es caro y desplaza lo que de verdad importa. Así que los límites se apilan:
| Límite | Por defecto | Efecto |
|---|---|---|
| Umbral por resultado | 100.000 caracteres | Por encima, se persiste en disco y se guarda una vista previa |
| Longitud de la vista previa | 1.500 caracteres | El texto realmente visible en el contexto |
| Presupuesto por turno | 200.000 caracteres | Total entre todos los resultados de herramientas de un turno |
| Resultados de herramientas MCP | 50.000 caracteres | Los payloads MCP suelen ser más grandes y estar menos paginados |
El problema es que el presupuesto no distingue datos de reglas.
Para una skill, truncar no ahorra espacio: se pierden reglas
skill_view devuelve un objeto JSON: el cuerpo, linked_files, metadatos. Cuando el cuerpo crece lo bastante como para que todo el JSON pase de 100.000 caracteres, se persiste como cualquier otro resultado y el contexto recibe esto en su lugar:
<persisted-output>
This tool result was too large (103,412 characters, 101.0 KB).
Full output saved to: ~/.hermes/cache/spillover/<id>.txt
Use the read_file tool with offset and limit to access specific sections of this output.
...
Preview (first 1500 chars):
...
</persisted-output>
Para una página scrapeada, ese aviso cumple su función: el modelo sabe que el contenido está en disco y va a leerlo. Para una skill, el modelo tiende a leerlo como «skill cargada». La vista previa tiene un título, los primeros pasos, el formato — parece completa. Nada le dice al modelo que la cláusula al 18% de profundidad, la que nombra al aprobador correcto, se quedó fuera.
Ese es exactamente el escenario del issue #151283. La skill del reportero llevaba un parámetro de producción fijo que no se podía inferir; tras el truncado, el agente siguió adelante con valores por defecto inferidos y ejecutó una escritura que cambiaba estado contra un sistema empresarial en producción. Su resumen es la parte importante: el fallo es silencioso y asimétrico — inofensivo para un payload de datos, dañino para un payload de políticas.
Qué cabe de verdad en 1.500 caracteres
Hay un detalle cuidado en la implementación. Los resultados de skills son JSON, y persistirlo tal cual pondría todo el documento en una sola línea con saltos de línea escapados, lo que haría inútil la paginación offset/limit de read_file. Así que antes de persistir, la cadena multilínea más larga se desenvuelve en texto plano paginable, y los campos estructurados como linked_files y metadata se mueven detrás del texto para que no se coman la vista previa.
El resultado práctico: la vista previa muestra los campos escalares (estado, rutas) y luego los primeros 1.500 caracteres del cuerpo.
Para una skill de dos mil palabras eso es de sobra. Para una skill de cien mil caracteres, es un índice.
Cómo escribir skills que eviten esto
No tienes que esperar a un arreglo. Los hábitos son baratos:
1. Mide el tamaño primero. En el directorio de la skill:
wc -c ~/.hermes/skills/<category>/<skill>/SKILL.mdDe diez a veinte mil caracteres es sano. Pasados los cincuenta mil, empieza a planear una división — no porque el truncado sea seguro, sino porque estás a un «déjame añadir esto» más de la línea.
2. Mueve los apéndices largos a references/. Las skills pueden incluir archivos de apoyo; skill_view los reporta como linked_files. Deja SKILL.md para el procedimiento y las reglas no negociables, y pon los inventarios de comandos, las diferencias entre plataformas y los historiales de casos en references/algo.md, que se leen solo cuando hace falta. El documento principal encoge y cada carga se mantiene enfocada.
3. Pon las reglas vinculantes arriba. La vista previa son los primeros 1.500 caracteres. Aprobadores, operaciones prohibidas, parámetros obligatorios — cualquier cosa donde una palabra mal puesta sea un incidente — va en los primeros cientos de caracteres, no en una sección de advertencias tres capítulos más abajo.
4. Si ves persisted-output, ve a leer el archivo. Cuando aparezca ese aviso y el resultado fuera una skill, no asumas que lo tienes todo. Abre la ruta con read_file y recorre la parte que falta con offset/limit.
5. Una skill no es mejor por ser exhaustiva. Una skill que lo cubre todo es un runbook que nadie termina. Separar «hay que seguirlo siempre» de «consúltalo de vez en cuando» es el arreglo de raíz.
En qué punto está
Al escribir esto, el issue #151283 sigue abierto: skill_view todavía no avisa de que se han perdido reglas. La salvaguarda hoy es la disciplina al escribir, no la herramienta.
Las skills crecen como crecen siempre los documentos — un párrafo a la vez, durante meses, más allá del tamaño que nadie planeó. Medir de vez en cuando y sacar los apéndices es el seguro más barato que hay.
Relacionado: comandos de gestión de skills, skills locales del proyecto dentro de un repo y las tres nuevas skills opcionales.