Wenn ein Skill zu groß wird, sieht Hermes nur die ersten 1.500 Zeichen
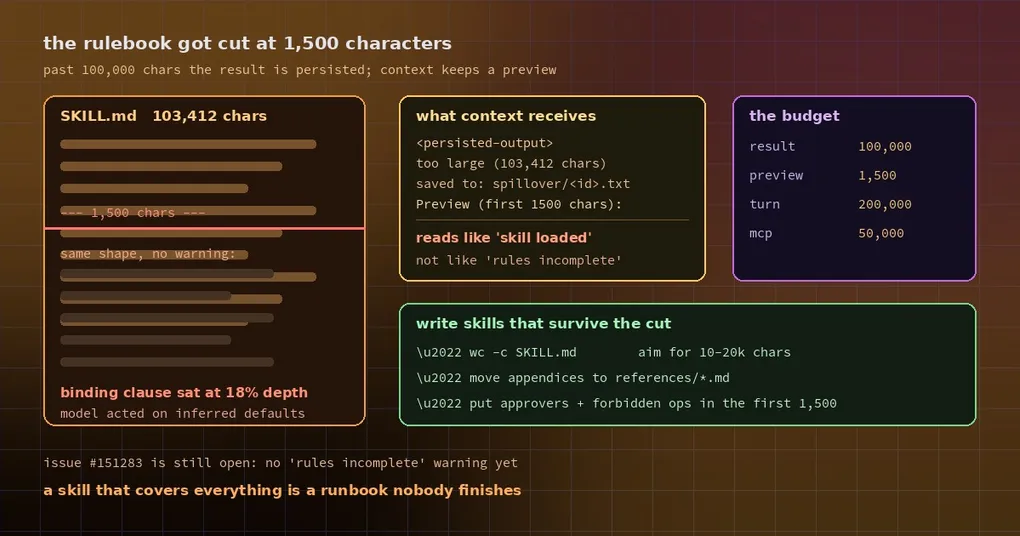
Du hast sechs Monate in eine SKILL.md rund um ein Deployment-Verfahren investiert: erst Backup, dann Rollout auf 10 %, bei steigenden Fehlerraten Rollback auf diesen Tag, und die Änderung geht immer an Person X zur Freigabe. Dreißig Seiten, dutzendfach überarbeitet, jedes Mal ein Absatz dazu. Und dann führt der Agent den Skill aus, trifft die erste Hälfte exakt richtig und gibt die Änderung an den falschen Approver – weil die Klausel „immer X“ schlicht nicht in dem war, was er gelesen hat.
Das Modell hat sich nicht widersetzt. Es hat diesen Abschnitt nie gesehen.
Das harte Budget: 100.000 Zeichen pro Tool-Ergebnis
Hermes wendet ein allgemeines Budget auf Tool-Ergebnisse an. Über 100.000 Zeichen wird ein Ergebnis nicht mehr vollständig in den Kontext gelegt: Es wird in eine spillover-Datei auf der Platte geschrieben, und das Modell bekommt eine Vorschau plus einen Pfad.
Das Design ist vernünftig. Ein Seitenabruf, ein find, ein Log-Tail können Hunderttausende Zeichen lang werden; alles mitzuschleppen ist teuer und verdrängt, worauf es wirklich ankommt. Die Limits stapeln sich also:
| Limit | Standard | Wirkung |
|---|---|---|
| Schwellwert pro Ergebnis | 100.000 Zeichen | Darüber wird auf die Platte persistiert und eine Vorschau behalten |
| Vorschau-Länge | 1.500 Zeichen | Der Text, der im Kontext tatsächlich sichtbar ist |
| Budget pro Turn | 200.000 Zeichen | Summe über alle Tool-Ergebnisse eines Turns |
| MCP-Tool-Ergebnisse | 50.000 Zeichen | MCP-Payloads sind tendenziell größer und weniger paginiert |
Das Problem ist, dass das Budget nicht zwischen Daten und Regeln unterscheidet.
Bei einem Skill spart Truncation keinen Platz – sie verliert Regeln
skill_view gibt ein JSON-Objekt zurück: den Body, linked_files, Metadaten. Wächst der Body so weit, dass das gesamte JSON 100.000 Zeichen überschreitet, wird es wie jedes andere Ergebnis persistiert, und der Kontext erhält stattdessen das hier:
<persisted-output>
This tool result was too large (103,412 characters, 101.0 KB).
Full output saved to: ~/.hermes/cache/spillover/<id>.txt
Use the read_file tool with offset and limit to access specific sections of this output.
...
Preview (first 1500 chars):
...
</persisted-output>
Bei einer gescrapten Seite erfüllt dieser Hinweis seinen Zweck: Das Modell weiß, dass der Inhalt auf der Platte liegt, und geht ihn lesen. Bei einem Skill liest das Modell ihn tendenziell als „Skill geladen“. Die Vorschau hat einen Titel, die ersten Schritte, die Formatierung – sie sieht vollständig aus. Nichts sagt dem Modell, dass die Klausel bei 18 % Tiefe, die den richtigen Approver nennt, weggefallen ist.
Genau das ist das Szenario aus Issue #151283. Der Skill des Reporters enthielt einen festen Produktionsparameter, der sich nicht ableiten ließ; nach der Truncation arbeitete der Agent mit abgeleiteten Defaults weiter und führte einen zustandsändernden Write gegen ein produktives Enterprise-System aus. Der Kern der Zusammenfassung: Der Fehler ist still und asymmetrisch – harmlos bei einer Daten-Payload, schädlich bei einer Policy-Payload.
Was tatsächlich in 1.500 Zeichen passt
Ein durchdachtes Detail steckt in der Implementierung. Skill-Ergebnisse sind JSON, und dieses wörtlich zu persistieren würde das ganze Dokument auf eine Zeile mit escapten Newlines legen, was die Offset/Limit-Paginierung von read_file unbrauchbar macht. Deshalb wird vor dem Persistieren der längste mehrzeilige String in paginierbaren Klartext entpackt, und strukturierte Felder wie linked_files und metadata wandern hinter den Text, damit sie die Vorschau nicht auffressen.
Das praktische Ergebnis: Die Vorschau zeigt skalare Felder (Status, Pfade) und dann die ersten 1.500 Zeichen des Bodys.
Bei einem Skill mit zweitausend Wörtern ist das reichlich. Bei einem Skill mit hunderttausend Zeichen ist es ein Inhaltsverzeichnis.
Wie du Skills schreibst, die das vermeiden
Du musst nicht auf einen Fix warten. Die Gewohnheiten sind billig:
1. Miss zuerst die Größe. Im Skill-Verzeichnis:
wc -c ~/.hermes/skills/<category>/<skill>/SKILL.mdZehn- bis zwanzigtausend Zeichen sind gesund. Ab fünfzigtausend fang an, eine Aufteilung zu planen – nicht weil Truncation sicher ist, sondern weil du nur ein weiteres „lass mich das kurz anhängen“ von der Grenze entfernt bist.
2. Verschieb lange Anhänge nach references/. Skills können Begleitdateien mitliefern; skill_view meldet sie als linked_files. Behalte die SKILL.md für das Verfahren und die nicht verhandelbaren Regeln und pack Befehlslisten, Plattformunterschiede und Fallhistorien in references/something.md, die nur bei Bedarf gelesen werden. Das Hauptdokument schrumpft und jeder Load bleibt fokussiert.
3. Bindende Regeln gehören nach oben. Die Vorschau sind die ersten 1.500 Zeichen. Approver, verbotene Operationen, Pflichtparameter – alles, wo ein falsches Wort ein Vorfall ist – gehört in die ersten paar hundert Zeichen, nicht in einen Caveats-Abschnitt drei Kapitel weiter unten.
4. Wenn du persisted-output siehst, lies die Datei. Erscheint dieser Hinweis und war das Ergebnis ein Skill, nimm nicht an, du hast alles. Öffne den Pfad mit read_file und blättere den fehlenden Teil mit Offset/Limit durch.
5. Ein Skill ist nicht besser, weil er erschöpfend ist. Ein Skill, der alles abdeckt, ist ein Runbook, das niemand zu Ende liest. „Muss jedes Mal befolgt werden“ von „gelegentlich nachschlagen“ zu trennen, ist der eigentliche Fix.
Stand der Dinge
Zum Zeitpunkt des Schreibens ist Issue #151283 noch offen: skill_view warnt noch nicht davor, dass Regeln weggefallen sind. Die Absicherung ist heute Autoren-Disziplin, nicht Tooling.
Skills wachsen, wie Dokumente immer wachsen – Absatz für Absatz, über Monate, über jede geplante Größe hinaus. Ab und zu messen und Anhänge auslagern ist die billigste Versicherung, die du bekommst.
Verwandt: Skill-Management-Befehle, projektlokale Skills im Repo und die drei neuen optionalen Skills.