Quand un skill devient trop gros, Hermes n'en voit que les 1 500 premiers caractères
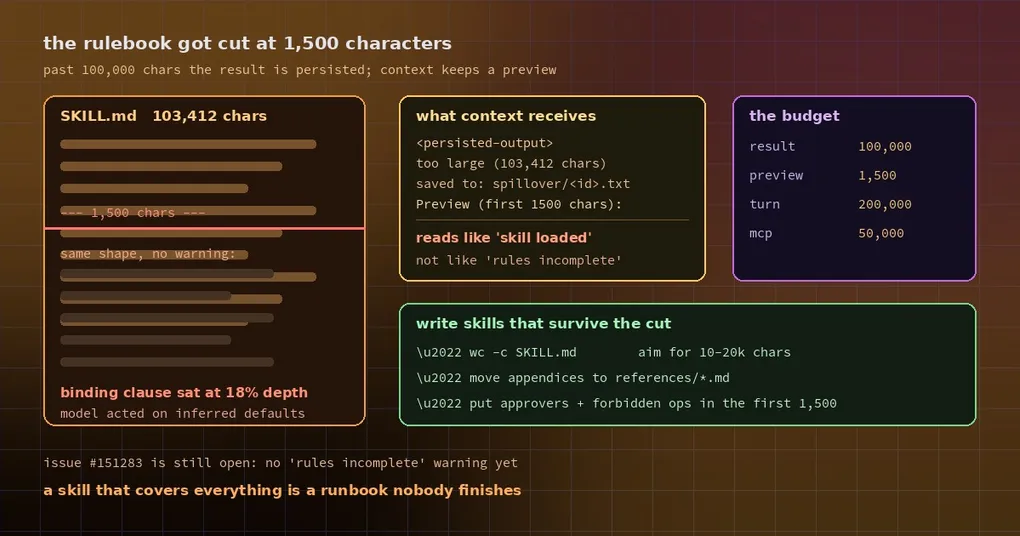
Vous avez passé six mois à faire grossir un SKILL.md autour d’une procédure de déploiement : sauvegarder d’abord, déployer ensuite sur 10 %, revenir à ce tag si les taux d’erreur bougent, et toujours confier le changement à la personne X pour validation. Trente pages, retouchées des dizaines de fois, un paragraphe ajouté à chaque passage. Puis un jour l’agent exécute le skill, réussit exactement la première moitié, et remet le changement au mauvais approbateur — parce que la clause « toujours X » ne figurait tout simplement pas dans ce qu’il a lu.
Le modèle n’a pas désobéi. Il n’a jamais vu cette section.
Le budget dur : 100 000 caractères par résultat d’outil
Hermes applique un budget général aux résultats d’outils. Au-delà de 100 000 caractères, un résultat n’est plus placé entier en contexte : il est écrit dans un fichier de spillover sur disque, et le modèle reçoit un aperçu plus un chemin.
Cette conception est sensée. Un fetch de page, un find, une fin de log peuvent atteindre des centaines de milliers de caractères ; tout transporter coûte cher et évince ce qui compte vraiment. Les limites s’empilent donc :
| Limite | Défaut | Effet |
|---|---|---|
| Seuil par résultat | 100 000 caractères | Au-delà, persistance sur disque et aperçu |
| Longueur de l’aperçu | 1 500 caractères | Le texte réellement visible en contexte |
| Budget par tour | 200 000 caractères | Total de tous les résultats d’outils d’un même tour |
| Résultats d’outils MCP | 50 000 caractères | Les payloads MCP sont plus gros et moins paginés |
Le problème, c’est que ce budget ne distingue pas les données des règles.
Pour un skill, la troncature n’économise pas de la place — elle supprime des règles
skill_view renvoie un objet JSON : le corps, linked_files, les métadonnées. Quand le corps grossit assez pour que l’ensemble du JSON dépasse 100 000 caractères, il est persisté comme n’importe quel autre résultat, et le contexte reçoit ceci à la place :
<persisted-output>
This tool result was too large (103,412 characters, 101.0 KB).
Full output saved to: ~/.hermes/cache/spillover/<id>.txt
Use the read_file tool with offset and limit to access specific sections of this output.
...
Preview (first 1500 chars):
...
</persisted-output>
Pour une page aspirée, cet avis fait son travail : le modèle sait que le contenu est sur disque et va le lire. Pour un skill, le modèle a tendance à le lire comme « skill chargé ». L’aperçu contient un titre, les premières étapes, le formatage — il a l’air complet. Rien ne signale au modèle que la clause située à 18 % de profondeur, celle qui nomme le bon approbateur, a été abandonnée.
C’est exactement le scénario de l’issue #151283. Le skill du rapporteur portait un paramètre de production fixe qui ne pouvait pas être déduit ; après troncature, l’agent a continué sur des valeurs par défaut inférées et effectué une écriture modifiant l’état d’un système d’entreprise en production. Leur conclusion est le point important : l’échec est silencieux et asymétrique — inoffensif pour un payload de données, dommageable pour un payload de règles.
Ce qui tient vraiment dans 1 500 caractères
Il y a un détail soigné dans l’implémentation. Les résultats de skill sont du JSON, et persister cela verbatim mettrait tout le document sur une seule ligne avec des retours à la ligne échappés, ce qui rendrait la pagination offset/limit de read_file inutilisable. Avant de persister, la plus longue chaîne multi-lignes est donc dépliée en texte brut paginable, et les champs structurés comme linked_files et metadata sont déplacés après le texte pour qu’ils ne puissent pas manger l’aperçu.
Le résultat pratique : l’aperçu montre les champs scalaires (statut, chemins), puis les 1 500 premiers caractères du corps.
Pour un skill de deux mille mots, c’est largement suffisant. Pour un skill de cent mille caractères, c’est une table des matières.
Comment écrire des skills qui évitent cela
Vous n’êtes pas obligé d’attendre un correctif. Les habitudes coûtent peu :
1. Mesurez la taille d’abord. Dans le répertoire du skill :
wc -c ~/.hermes/skills/<category>/<skill>/SKILL.mdDix à vingt mille caractères, c’est sain. Au-delà de cinquante mille, commencez à planifier une découpe — non pas parce que la troncature est certaine, mais parce que vous êtes à un « je rajoute juste ça » de la ligne.
2. Déplacez les longues annexes dans references/. Les skills peuvent embarquer des fichiers de support ; skill_view les remonte comme linked_files. Gardez SKILL.md pour la procédure et les règles non négociables, et mettez les inventaires de commandes, les différences entre plateformes et les historiques de cas dans references/something.md, lus seulement au besoin. Le document principal maigrit et chaque chargement reste ciblé.
3. Placez les règles contraignantes en haut. L’aperçu, ce sont les 1 500 premiers caractères. Approbateurs, opérations interdites, paramètres obligatoires — tout ce où un mot de travers provoque un incident — doit figurer dans les quelques centaines de premiers caractères, pas dans une section de mises en garde trois chapitres plus bas.
4. Si vous voyez persisted-output, allez lire le fichier. Quand cet avis apparaît et que le résultat était un skill, ne supposez pas avoir la totalité. Ouvrez le chemin avec read_file et parcourez la partie manquante avec offset/limit.
5. Un skill n’est pas meilleur parce qu’il est exhaustif. Un skill qui couvre tout est un runbook que personne ne termine. Séparer « à suivre à chaque fois » de « à consulter occasionnellement » est le correctif de fond.
Où en sont les choses
Au moment d’écrire ces lignes, l’issue #151283 est toujours ouverte : skill_view n’avertit pas encore que des règles ont été perdues. Le garde-fou, aujourd’hui, c’est la discipline de rédaction, pas l’outillage.
Les skills grossissent comme tous les documents — un paragraphe à la fois, sur des mois, au-delà de la taille que quiconque avait prévue. Mesurer de temps en temps et sortir les annexes est l’assurance la moins chère qui soit.
Pour aller plus loin : les commandes de gestion des skills, les skills locaux à un projet dans un dépôt, et les trois nouveaux skills optionnels.