A compaction engoliu o resultado de tool que seu modelo estava esperando
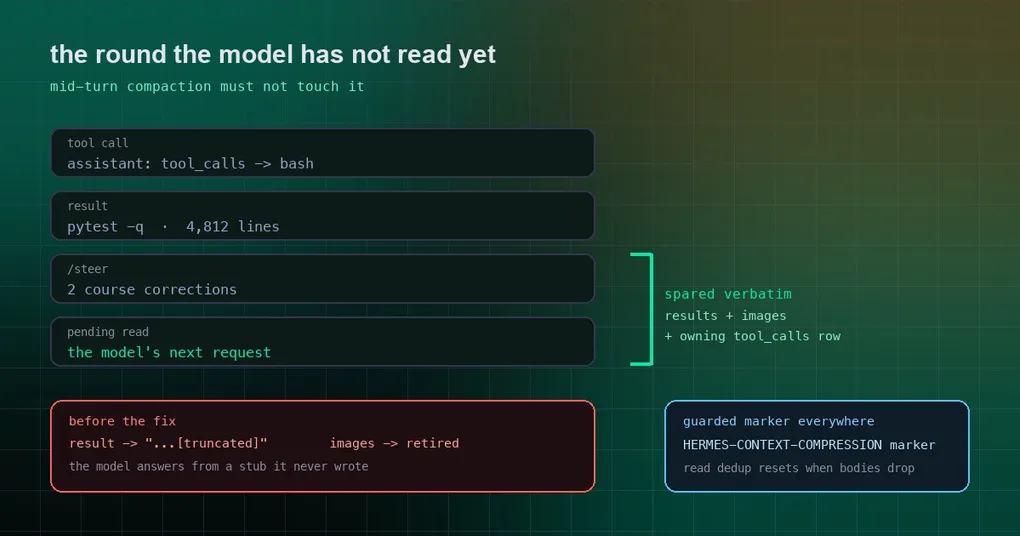
Você pede ao agente para rodar a suíte de integração. Ele roda — milhares de linhas de saída passam pela tela. Depois você pergunta quais testes falharam, e ele responde que só viu um placeholder de uma linha, e as capturas de tela que fez no caminho também sumiram. Nada falhou de forma ruidosa. O comando realmente rodou; o resultado realmente chegou à conversa. Ele só não sobreviveu ao trajeto entre “a tool terminou” e “o modelo leu”. Três correções mescladas em 2026-09-26 (PRs #124208, #124207, #124231) fecham essa lacuna — e é isso que elas protegem, e o que deliberadamente ainda não protegem.
O que é, de fato, a “compaction em meio ao turno”
Uma sessão longa acaba enchendo o context window. O Hermes lida com isso por meio da compaction: o histórico mais antigo é substituído por um resumo para que a conversa possa continuar. Na maior parte das vezes a compaction acontece entre turnos, e você nem percebe.
O momento perigoso é outro — a etapa de preparação antes de a requisição sair (o código chama isso de preflight). Justamente ali o contexto carrega um resultado de tool que acabou de chegar e ainda não foi lido. O comando já executou, a saída está no transcript, e a próxima requisição do modelo ainda não foi enviada.
A implementação antiga tratava essa rodada como qualquer outro trecho do histórico: a passagem de pressão rebaixava “tudo menos o mais novo”, a lógica de aposentadoria de imagens ignorava completamente a rodada pendente, e o corte de cauda descia até um piso de zero. Uma compaction disparada nessa janela podia reduzir o resultado a um stub de uma linha, ou aposentar suas imagens. O modelo acordava sem nada para ler.
Correção 1: a rodada que você está esperando é poupada palavra por palavra (PR #124208)
A correção gira em torno de um novo helper, _pending_tool_round, que encontra a sequência final de resultados de tool — e pula as linhas contíguas de /steer que podem ficar entre um resultado e a leitura do modelo quando você envia uma correção de rumo no meio da execução. Ache essa rodada e ela passa a ser isenta em quatro lugares:
| Etapa | O que acontecia antes | O que acontece agora |
|---|---|---|
| Passo 2 (passagem de pressão) | A rodada era rebaixada a um stub ou resumo | Mantida palavra por palavra |
| Aposentadoria de imagens (as duas varreduras) | Só a imagem mais nova sobrevivia | Todas as imagens de uma rodada com várias imagens sobrevivem |
| Corte de cauda | Piso de percurso 0, então podia ser cortada fora | A rodada fica fora de alcance |
| Passo 3 (truncamento de argumentos) | A linha do assistente que emitiu a chamada podia ser cortada | A linha tool_calls dona também é poupada |
Vale conhecer uma condição de contorno: uma rodada maior que 20% da janela de entrada efetiva não é poupada. Isso é proposital — um resultado grande demais continua pegando a saída de emergência original para overflow, porque do contrário a compaction falharia exatamente quando é mais necessária.
Correção 2: toda elisão visível ao modelo passa pelo marker protegido (PR #124207)
O truncamento antes era anunciado de forma direta: ...[truncated]. O problema é que o Hermes mantém uma guarda na fronteira de despacho de tools (_COMPRESSION_MARKER_RE em agent/tool_dispatch_helpers.py) cujo trabalho é justamente pegar um modelo que copia um marker de elisão para uma escrita de arquivo. Ela só reconhece o marker especial. Não consegue ver ...[truncated].
A consequência não é uma linha de log cosmética; é a classe de perda de dados. Um modelo que copia para write_file ou patch um texto que nunca viu por inteiro, marker e tudo, passa batido — e o arquivo é gravado errado.
Agora todo truncamento visível ao modelo passa pelo marker não imitável ⟪HERMES-CONTEXT-COMPRESSION: …⟫: o próprio compressor, a saída de shell inline das skills, o reporter do LSP, a parada de verificação, o contexto de memória, e ainda o serializador do Slack e o compressor de trajetória voltados ao agente. Alguns pontos sob tools/* continuam abertos — o PR diz isso em vez de fingir o contrário.
Correção 3: o “unchanged” que não era (PR #124231)
read_file e skill_view mantêm um dedup cache: leia o mesmo arquivo uma segunda vez e você recebe um “unchanged” barato em vez do corpo. É uma boa troca — até o cache e o transcript discordarem.
Três caminhos de reescrita descartam corpos de resultados de tool sem resetar esse cache:
- micro-compaction pós-turno;
- um checkpoint nativo de Responses reexecutável;
- compaction do Codex app-server.
O modelo fica então sem o corpo (descartado) e sem o conteúdo (“unchanged” dá a entender que ele ainda tem o conteúdo). Os três agora resetam os caches; a micro-compaction só reseta quando de fato reescreveu o transcript, para que uma passagem sem efeito não jogue fora um cache ainda válido.
O que você deve fazer
- Os três PRs foram mesclados em 2026-09-26, depois da tag da release v0.21.5, então eles vivem na
main. Ohermes updateos traz; um deployment fixado em tags espera a próxima. - Nenhuma mudança de configuração. Não há switch novo aqui, só comportamento corrigido.
- Numa sessão longa em lote, o sintoma revelador era o modelo afirmar que nunca viu uma saída que o transcript mostra que ele recebeu. Essa contradição deve parar de acontecer.
O princípio por trás
A compaction em meio ao turno saiu de “rebaixe tudo menos o mais novo” para “nunca toque na rodada que o modelo ainda não leu”. O marker de elisão deixou de ser uma string por ponto e virou um token guardado. O cache de leitura foi realinhado com a realidade. Os três apontam para a mesma regra: a compaction pode sacrificar informação antiga, nunca informação que está em uso. Para o quadro ao redor, comece por uma requisição de compaction em vez de dezenove para a história de velocidade, o que quarenta rodadas de compaction fazem com uma sessão para os números medidos, e o trade-off da cauda enxuta para o que é sacrificado de propósito. O resto desta janela está na página da release v0.21.5.