Compaction hat das Tool-Ergebnis gefressen, auf das Ihr Modell gewartet hat
Sie bitten den Agent, die Integration-Suite laufen zu lassen. Er tut es — tausende Zeilen Ausgabe scrollen vorbei. Dann fragen Sie, welche Tests fehlgeschlagen sind, und er sagt Ihnen, er habe nur einen einzeiligen Platzhalter gesehen, und die Screenshots, die er unterwegs aufgenommen hat, sind ebenfalls weg. Nichts ist laut fehlgeschlagen. Der Befehl lief wirklich; das Ergebnis landete wirklich in der Konversation. Es hat nur den Weg von „das Tool ist fertig“ bis „das Modell hat es gelesen“ nicht überlebt. Drei Fixes, gemergt am 26. September 2026 (PRs #124208, #124207, #124231), schließen diese Lücke — und hier steht, was sie schützen und was sie bewusst weiterhin nicht schützen.
Was „Mid-Turn-Compaction“ tatsächlich ist
Eine lange Session füllt irgendwann ihr Context-Window. Hermes fängt das mit Compaction ab: Ältere Historie wird durch eine Zusammenfassung ersetzt, damit die Konversation weiterlaufen kann. Meist passiert Compaction zwischen Turns, und Sie merken nie etwas davon.
Der gefährliche Moment ist ein anderer — der Vorbereitungsschritt, bevor eine Anfrage rausgeht (der Code nennt ihn Preflight). Genau dann enthält der Context ein Tool-Ergebnis, das gerade erst angekommen ist und noch nicht gelesen wurde. Der Befehl ist ausgeführt, die Ausgabe liegt im Transcript, und die nächste Anfrage des Modells wurde noch nicht gesendet.
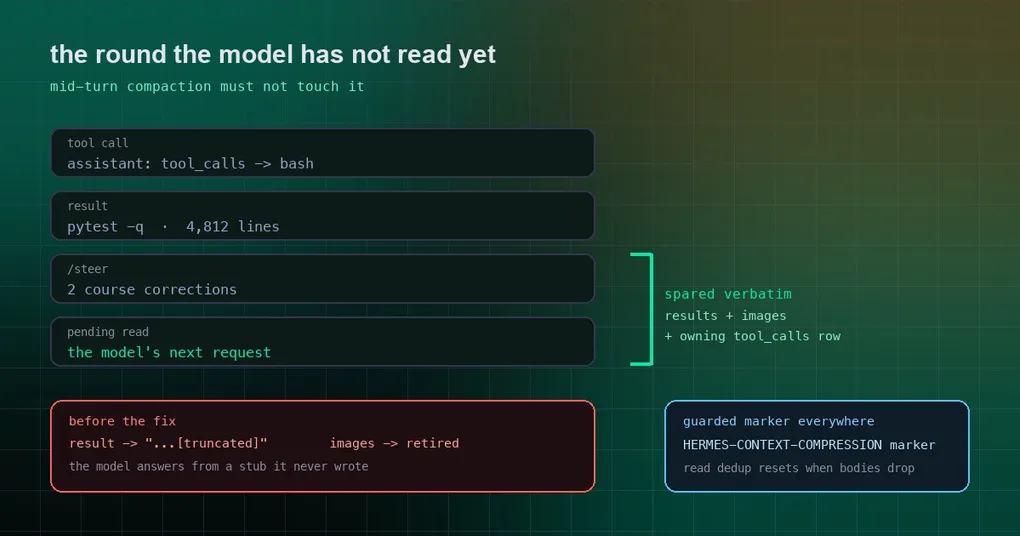
Die alte Implementierung behandelte diese Runde wie jede andere Historie: Der Pressure-Pass degradierte „alles außer dem Neuesten“, die Image-Retirement-Logik ignorierte die ausstehende Runde komplett, und der Tail Cut lief bis zu einem Floor von null herunter. Eine Compaction, die in diesem Fenster feuerte, konnte das Ergebnis auf einen einzeiligen Stub reduzieren oder seine Bilder abräumen. Das Modell wachte ohne Lesestoff auf.
Fix eins: Die Runde, auf die Sie warten, bleibt wörtlich erhalten (PR #124208)
Der Fix dreht sich um einen neuen Helper, _pending_tool_round, der den abschließenden Block von Tool-Ergebnissen findet — und die zusammenhängenden /steer-Zeilen überspringt, die zwischen einem Ergebnis und dem Lesen durch das Modell stehen können, wenn Sie mitten im Lauf eine Kurskorrektur senden. Ist diese Runde gefunden, ist sie jetzt an vier Stellen ausgenommen:
| Stufe | Was früher passierte | Was jetzt passiert |
|---|---|---|
| Pass 2 (Pressure-Pass) | Die Runde wurde zu einem Stub oder einer Zusammenfassung degradiert | Bleibt wörtlich erhalten |
| Image-Retirement (beide Scans) | Nur das neueste Bild überlebte | Alle Bilder einer Multi-Image-Runde überleben |
| Tail Cut | Walk-Floor von 0, konnte also weggeschnitten werden | Die Runde ist unerreichbar |
| Pass 3 (Argument-Truncation) | Die ausgebende Assistant-Zeile konnte geschnitten werden | Auch die dazugehörige tool_calls-Zeile bleibt verschont |
Eine Randbedingung sollte man kennen: Eine Runde, die größer als 20 % des effektiven Input-Windows ist, wird nicht verschont. Das ist Absicht — ein überdimensioniertes Ergebnis nimmt weiterhin die ursprüngliche Overflow-Notluke, denn sonst würde Compaction genau dann scheitern, wenn sie am dringendsten gebraucht wird.
Fix zwei: Jede für das Modell sichtbare Auslassung läuft über den abgesicherten Marker (PR #124207)
Früher wurde eine Truncation schlicht angekündigt: ...[truncated]. Das Problem: Hermes hält an der Tool-Dispatch-Grenze (_COMPRESSION_MARKER_RE in agent/tool_dispatch_helpers.py) eine Guard, deren einzige Aufgabe es ist, ein Modell abzufangen, das einen Elision-Marker in einen Datei-Write kopiert. Sie erkennt nur den speziellen Marker. ...[truncated] sieht sie nicht.
Die Folge ist keine kosmetische Log-Zeile, sondern die Klasse der Datenverluste. Ein Modell, das Text kopiert, den es nie vollständig gesehen hat — Marker und alles —, in write_file oder patch, wird durchgewinkt, und die Datei wird falsch geschrieben.
Jede für das Modell sichtbare Truncation läuft jetzt über den nicht imitierbaren Marker ⟪HERMES-CONTEXT-COMPRESSION: …⟫: der Compressor selbst, die Inline-Shell-Ausgabe von Skills, der LSP-Reporter, der Verification-Stop, der Memory-Context sowie der agentseitige Slack-Serializer und der Trajectory-Compressor. Ein paar Stellen unter tools/* bleiben offen — das PR sagt das, statt etwas anderes vorzugeben.
Fix drei: Das „unchanged“, das keines war (PR #124231)
read_file und skill_view führen beide einen Dedup-Cache: Lesen Sie dieselbe Datei ein zweites Mal, bekommen Sie ein billiges „unchanged“ statt des Inhalts. Ein guter Deal — bis Cache und Transcript auseinanderlaufen.
Drei Rewrite-Pfade verwerfen Tool-Ergebnis-Inhalte, ohne ihn zurückzusetzen:
- die Micro-Compaction nach dem Turn;
- ein replaybarer nativer Responses-Checkpoint;
- die Compaction des Codex app-servers.
Das Modell hat dann weder den Inhalt (verworfen) noch den Content („unchanged“ impliziert, dass es ihn noch hat). Alle drei setzen die Caches jetzt zurück; die Micro-Compaction setzt nur dann zurück, wenn sie das Transcript tatsächlich umgeschrieben hat, damit ein No-op-Pass keinen noch gültigen Cache wegwirft.
Was Sie tun sollten
- Die drei PRs wurden am 26. September 2026 gemergt, nach dem Release-Tag v0.21.5, sie stecken also auf
main.hermes updateholt sie; ein Deployment, das auf Tags gepinnt ist, wartet auf das nächste. - Keine Konfigurationsänderungen. Es gibt hier keinen neuen Schalter, nur korrigiertes Verhalten.
- In einer langen Batch-Session war das verräterische Symptom, dass das Modell behauptete, eine Ausgabe nie gesehen zu haben, die das Transcript als empfangen zeigt. Dieser Widerspruch sollte aufhören.
Das Prinzip darunter
Mid-Turn-Compaction ist von „alles außer dem Neuesten degradieren“ zu „die Runde, die das Modell noch nicht gelesen hat, nie anfassen“ gewechselt. Der Elision-Marker ist von einem String pro Stelle zu einem einzigen abgesicherten Token geworden. Der Read-Cache wurde wieder an die Realität ausgerichtet. Alle drei zeigen auf dieselbe Regel: Compaction darf alte Informationen opfern, niemals Informationen, die gerade in Gebrauch sind. Für das Umfeld beginnen Sie mit einer Compaction-Anfrage statt neunzehn für die Geschwindigkeits-Story, was vierzig Runden Compaction mit einer Session machen für die gemessenen Zahlen und dem Lean-Tail-Trade-off für das, was bewusst geopfert wird. Der Rest dieses Fensters steht auf der v0.21.5-Release-Seite.