La compaction a avalé le résultat d'outil que votre modèle attendait
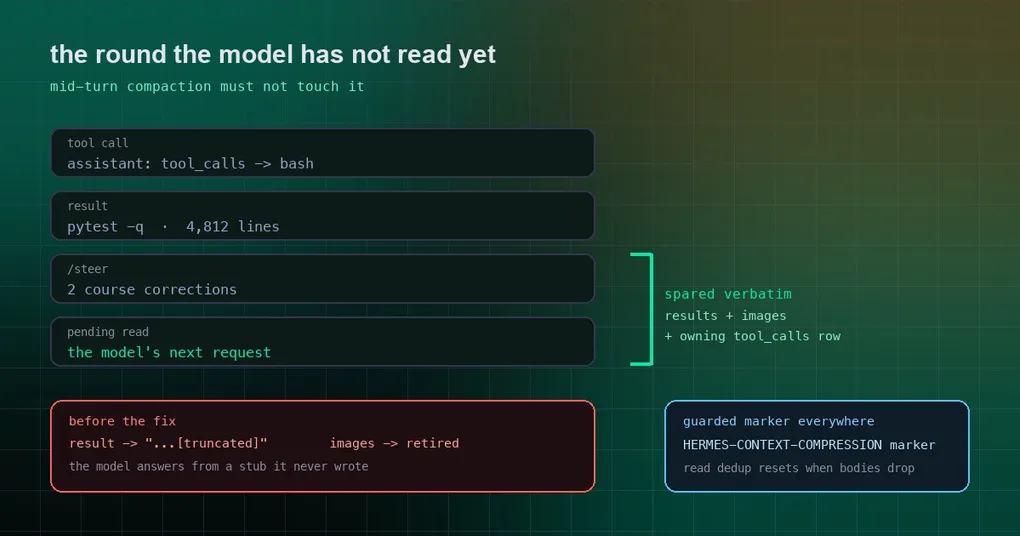
Vous demandez à l’agent de lancer la suite de tests d’intégration. Il le fait — des milliers de lignes de sortie défilent. Puis vous lui demandez quels tests ont échoué, et il vous répond qu’il n’a vu qu’un placeholder d’une seule ligne, et que les captures d’écran prises en chemin ont disparu elles aussi. Rien n’a échoué bruyamment. La commande s’est bel et bien exécutée ; le résultat est bel et bien arrivé dans la conversation. Il n’a simplement jamais survécu au trajet entre « le tool a terminé » et « le modèle l’a lu ». Trois correctifs fusionnés le 2026-09-26 (PR #124208, #124207, #124231) referment cette brèche, et voici ce qu’ils protègent — et ce qu’ils ne protègent délibérément toujours pas.
Ce qu’est réellement la compaction en cours de tour
Une session longue finit par saturer sa fenêtre de contexte. Hermes gère cela avec la compaction : l’historique ancien est remplacé par un résumé pour que la conversation puisse se poursuivre. La plupart du temps, la compaction se produit entre deux tours, et vous ne la remarquez jamais.
Le moment dangereux est tout autre — l’étape de préparation juste avant qu’une requête ne part (le code l’appelle preflight). À cet instant précis, le contexte contient un résultat d’outil qui vient d’arriver et qui n’a pas encore été lu. La commande s’est exécutée, la sortie est dans le transcript, et la requête suivante du modèle n’a pas été envoyée.
L’ancienne implémentation traitait ce tour comme n’importe quel autre élément d’historique : la passe de pression rétrogradait « tout sauf le plus récent », la logique de retrait des images ignorait complètement le tour en attente, et la coupe de queue descendait jusqu’à un plancher de zéro. Une compaction déclenchée dans cette fenêtre pouvait réduire le résultat à un stub d’une ligne, ou retirer ses images. Le modèle se réveillait sans rien à lire.
Correctif 1 : le tour que vous attendez est épargné mot pour mot (PR #124208)
Le correctif s’articule autour d’un nouveau helper, _pending_tool_round, qui repère la série finale de résultats d’outils — et ignore les lignes /steer contiguës qui peuvent s’intercaler entre un résultat et sa lecture par le modèle lorsque vous envoyez une correction de trajectoire en cours de run. Une fois ce tour identifié, il est désormais exempté à quatre endroits :
| Étape | Ce qui se passait avant | Ce qui se passe maintenant |
|---|---|---|
| Passe 2 (passe de pression) | Le tour était rétrogradé en stub ou en résumé | Conservé mot pour mot |
| Retrait des images (les deux scans) | Seule l’image la plus récente survivait | Toutes les images d’un tour multi-images survivent |
| Coupe de queue | Plancher de marche à 0, le tour pouvait donc être coupé | Le tour est hors de portée |
| Passe 3 (troncature des arguments) | La ligne de l’assistant émetteur pouvait être coupée | La ligne tool_calls propriétaire est épargnée elle aussi |
Une condition limite mérite d’être connue : un tour plus gros que 20 % de la fenêtre d’entrée effective n’est pas épargné. C’est délibéré — un résultat surdimensionné emprunte toujours la soupape de débordement d’origine, car sinon la compaction échouerait précisément au moment où elle est le plus nécessaire.
Correctif 2 : toute élision visible par le modèle passe par le marqueur protégé (PR #124207)
La troncature était annoncée sans détour : ...[truncated]. Le problème, c’est qu’Hermes maintient une garde à la frontière du dispatch d’outils (_COMPRESSION_MARKER_RE dans agent/tool_dispatch_helpers.py) dont tout le rôle est d’attraper un modèle qui recopie un marqueur d’élision dans une écriture de fichier. Elle ne reconnaît que le marqueur spécial. Elle ne voit pas ...[truncated].
La conséquence n’est pas une ligne de log cosmétique ; elle relève de la classe perte de données. Un modèle qui recopie dans write_file ou patch un texte qu’il n’a jamais vu en entier, marqueur compris, passe sans encombre — et le fichier est écrit de travers.
Toute troncature visible par le modèle passe désormais par le marqueur non imitable ⟪HERMES-CONTEXT-COMPRESSION: …⟫ : le compresseur lui-même, la sortie inline-shell des skills, le reporter LSP, l’arrêt de vérification, le contexte mémoire, ainsi que le sérialiseur Slack côté agent et le compresseur de trajectoire. Quelques emplacements sous tools/* restent ouverts — la PR le dit plutôt que de prétendre le contraire.
Correctif 3 : le « unchanged » qui n’en était pas un (PR #124231)
read_file et skill_view maintiennent tous les deux un cache de déduplication : relisez le même fichier une seconde fois et vous obtenez un « unchanged » peu coûteux à la place du corps. Le compromis est bon — jusqu’à ce que le cache et le transcript se contredisent.
Trois chemins de réécriture suppriment les corps de résultats d’outils sans réinitialiser ce cache :
- la micro-compaction d’après-tour ;
- un checkpoint natif Responses rejouable ;
- la compaction de l’app-server Codex.
Le modèle n’a alors ni le corps (supprimé) ni le contenu (« unchanged » sous-entend qu’il l’a toujours). Les trois réinitialisent désormais les caches ; la micro-compaction ne réinitialise que lorsqu’elle a réellement réécrit le transcript, pour qu’une passe sans effet ne jette pas un cache encore valide.
Ce que vous devez faire
- Les trois PR ont été fusionnées le 2026-09-26, après le tag de release v0.21.5, elles vivent donc sur
main.hermes updatevous les récupère ; un déploiement épinglé sur des tags attendra la prochaine. - Aucun changement de configuration. Il n’y a aucun nouveau switch ici, seulement un comportement corrigé.
- Sur une longue session par lots, le symptôme révélateur était un modèle affirmant n’avoir jamais vu une sortie que le transcript montre comme reçue. Cette contradiction devrait cesser de se produire.
Le principe sous-jacent
La compaction en cours de tour est passée de « rétrograder tout sauf le plus récent » à « ne jamais toucher au tour que le modèle n’a pas lu ». Le marqueur d’élision a cessé d’être une chaîne propre à chaque emplacement pour devenir un unique token protégé. Le cache de lecture a été réaligné sur la réalité. Les trois pointent vers la même règle : la compaction peut sacrifier de l’information ancienne, jamais de l’information en cours d’utilisation. Pour le contexte alentour, commencez par une seule requête de compaction au lieu de dix-neuf pour l’aspect vitesse, ce que quarante tours de compaction font à une session pour les chiffres mesurés, et le compromis de la queue allégée pour ce qui est sacrifié à dessein. Le reste de cette fenêtre est sur la page de release v0.21.5.