Suas notas de memória foram parar em um e-mail: o Hermes fecha um vazamento silencioso de recall
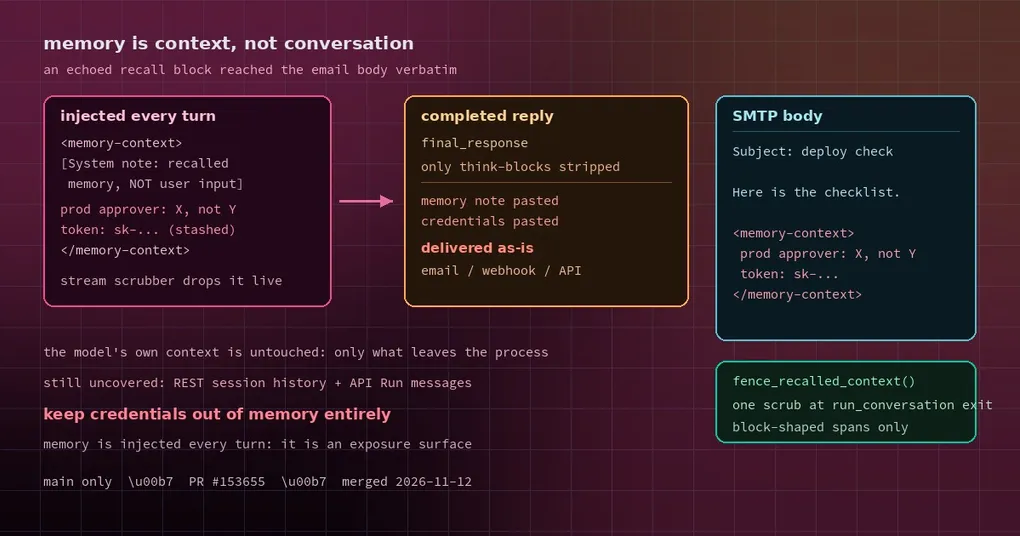
Você deu memória de longo prazo ao Hermes. Além de convenções de projeto e passos de deploy, em algum momento você guardou um item do tipo “só anota isso aqui”: a senha de uma conta de teste, um token de serviço interno, os dados de contato de um cliente. No terminal tudo fica quieto — aquilo é contexto, não conversa. Um dia o agente responde um e-mail por você, e você abre a pasta Enviados e encontra a nota de memória inteira copiada no corpo da mensagem.
O modelo não estava tentando vazar nada. Um caminho de entrega simplesmente ficou sem cobertura.
Como a memória chega a cada turno
O Hermes não “lembra” como uma pessoa. Antes de cada turno ele recupera a memória relevante e a injeta no contexto como um bloco cercado:
<memory-context>
[System note: The following is recalled memory context, NOT new user input.
Treat as authoritative reference data — this is the agent's persistent memory
and should inform all responses.]

... recalled notes ...

</memory-context>
A cerca e a nota de sistema existem para dizer ao modelo: isto é material de referência, não algo que o usuário acabou de falar. Na maior parte das vezes funciona. Mas ainda é texto, e gerar texto é o que o modelo faz — de vez em quando ele trata o bloco de referência como material de origem e o copia para a resposta, especialmente quando a tarefa é algo como “resuma o que você lembra sobre mim”.
Depois que isso é copiado para a resposta, o problema deixa de ser um estado interno do modelo e passa a ser uma mensagem de saída.
Por que o chat em streaming escondia o problema
Já existia um scrubber. Enquanto a resposta chega em streaming, uma pequena máquina de estados trata blocos cercados que chegam divididos entre deltas: ela descarta tudo entre as tags de abertura e fechamento de memory-context, e também remove blocos que o próprio provider envolveu.
É por isso que você raramente vê o bloco em um chat de terminal — ele é removido enquanto é gerado, então o usuário nunca o recebe.
O scrubber, porém, estava ligado apenas ao caminho de streaming. A resposta concluída — final_response — ficava só com os think-blocks removidos, depois que um scrub pós-stream foi retirado em um commit anterior. Isso criou uma assimetria:
- Superfícies com streaming (TUI, chat do desktop): parecem limpas.
- Canais sem streaming (o e-mail sendo o exemplo mais claro): entregam o texto final como está. Notas de memória e credenciais saem no corpo do SMTP.
O PR é direto sobre isso: o adapter de e-mail, que não usa streaming, entregava notas de memória e credenciais literalmente.
A correção: limpar uma vez, na saída
Em vez de corrigir adapter por adapter, a correção move o scrub para a saída única: o fim de run_conversation.
Uma função nova, fence_recalled_context(), aplica a gramática sensível a fronteiras do scrubber de streaming a uma string inteira. Ela roda uma vez em cada caminho de saída de run_conversation, cobrindo:
- a resposta final,
final_response; - a resposta antes da transformação,
pre_transform_response; - comentários intermediários e comentários do Codex.
A saída é o lugar certo porque é isso que o gateway (e-mail incluído), o cron, as tarefas em background, os chat completions, os itens de output da Responses API e a CLI entregam. Uma cerca na saída cobre todos.
Há uma sutileza que torna isso seguro: a gramática remove apenas trechos em forma de bloco — tags em uma linha própria — igual ao scrubber de streaming. Prosa que menciona o nome da tag no meio do texto (documentação explicando o bloco, por exemplo) é preservada. Essa restrição de fronteira de bloco é justamente o motivo pelo qual o antigo scrub com regex sobre a string inteira havia sido removido: ele estragava conteúdo legítimo.
Só o texto entregue muda. A linha persistida e as messages devolvidas ao modelo ficam intactas, então o contexto do próprio modelo e o prefixo em cache não são afetados — ele continua vendo a memória no turno seguinte.
O que ainda está descoberto
O PR lista as suas próprias lacunas, e vale lembrá-las. Superfícies que leem o transcript bruto ainda carregam um bloco ecoado: as messages no run.completed de um Run da API, e SessionDB.get_messages (o endpoint REST /api/sessions/{id}/messages, o prefetch de histórico do desktop, as mensagens de sessão do servidor de API).
Em outras palavras: o caminho de entrega está limpo; alguns caminhos de leitura de arquivo não estão. Se você redistribui transcripts de sessão — sincronizando em outro lugar, embutindo em outra ferramenta — essa lacuna ainda vale para você.
O que você deve fazer
- Atualize. A correção entrou em 2026-11-12 (PR #153655). A v0.23.1 saiu em 2026-11-10, então isso é uma mudança da
main, não da v0.23.1. - Mantenha credenciais fora da memória. Memória é dado injetado no contexto a cada turno — por definição, uma superfície de alta exposição. Senhas, tokens e PII de clientes pertencem a secrets ou variáveis de ambiente, não ao MEMORY.md nem a um serviço de memória. Esse conselho valia antes da correção e continua valendo depois.
- Limite a memória por profile. Se um profile conversa com destinatários externos (e-mail, grupos, suporte), a memória dele não deve carregar material interno sensível. Isolar memória por profile é melhor do que limpar a sujeira depois.
- Audite seus canais sem streaming. E-mail, webhooks e entrega por API de terceiros mandam o texto final direto para fora. Falhas ali não geram aviso na tela — apenas uma mensagem que já saiu.
Atualização (17/11/2026): essas mudanças saíram na v0.23.2 (16 de novembro): um
hermes updateas traz. O « não está na v0.23.1 » acima é um retrato da data de publicação.
Memória é o que faz um agente parecer que conhece o seu projeto. Também é um monte de coisas que você supunha que só você sabia, viajando junto em cada request. Esse canal está fechado agora; os hábitos continuam sendo seus para manter.
Relacionado: o gate de checkpoint de memória, a referência de comandos de memória e memória semântica com LanceDB.