Vos notes de mémoire ont fini dans un e-mail : Hermes colmate une fuite silencieuse du rappel
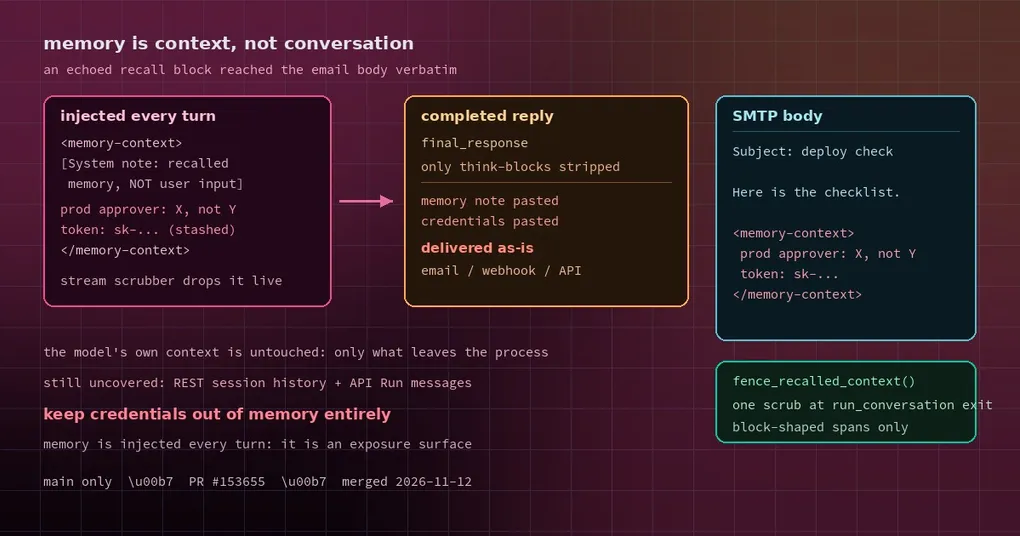
Vous avez donné une mémoire à long terme à Hermes. En plus des conventions de projet et des étapes de déploiement, vous y avez un jour rangé un « note juste ça » : le mot de passe d’un compte de test, un token de service interne, les coordonnées d’un client. Dans le terminal, ça reste discret — c’est du contexte, pas de la conversation. Puis un jour l’agent répond à un e-mail à votre place, et vous ouvrez le dossier Envoyés pour découvrir toute la note de mémoire recopiée dans le corps du message.
Le modèle n’essayait pas de faire fuiter quoi que ce soit. Un chemin de livraison était simplement resté à découvert.
Comment la mémoire arrive à chaque tour
Hermes ne « se souvient » pas comme une personne. Avant chaque tour, il rappelle la mémoire pertinente et l’injecte dans le contexte sous forme de bloc encadré :
<memory-context>
[System note: The following is recalled memory context, NOT new user input.
Treat as authoritative reference data — this is the agent's persistent memory
and should inform all responses.]

... recalled notes ...

</memory-context>
La clôture et la note système existent pour dire au modèle : ceci est une référence, pas quelque chose que l’utilisateur vient de dire. La plupart du temps, ça marche. Mais c’est du texte, et générer du texte, c’est ce que fait le modèle — il lui arrive de traiter le bloc de référence comme une source et de le recopier dans sa réponse, surtout quand la tâche ressemble à « résume ce dont tu te souviens à mon sujet ».
Une fois recopié dans la réponse, le problème cesse d’être un état interne du modèle pour devenir un message sortant.
Pourquoi le chat en streaming masquait le problème
Il existait déjà un nettoyeur. Pendant qu’une réponse est streamée, une petite machine à états gère les blocs encadrés qui arrivent découpés entre plusieurs deltas : elle supprime tout ce qui se trouve entre les balises d’ouverture et de fermeture memory-context, et retire aussi les blocs qu’un fournisseur a enveloppés de son côté.
C’est pourquoi vous voyez rarement le bloc dans un chat en terminal — il est retiré au fil de la génération, l’utilisateur ne le reçoit jamais.
Le nettoyeur, en revanche, n’était branché que sur le chemin streaming. La réponse complétée — final_response — ne subissait plus qu’un retrait des blocs de réflexion, depuis la suppression d’un nettoyage post-stream dans un commit antérieur. D’où une asymétrie :
- Les surfaces en streaming (TUI, chat desktop) : propres en apparence.
- Les canaux non streaming (l’e-mail étant l’exemple le plus clair) : livrent le texte final tel quel. Les notes de mémoire et les identifiants partent dans le corps SMTP.
La PR le dit sans détour : l’adaptateur e-mail non streaming livrait les notes de mémoire et les identifiants verbatim.
Le correctif : nettoyer une fois, à la sortie
Plutôt que de corriger les adaptateurs un par un, le correctif déplace le nettoyage vers la sortie unique : la fin de run_conversation.
Une nouvelle fonction, fence_recalled_context(), applique à une chaîne entière la grammaire sensible aux frontières du nettoyeur de streaming. Elle s’exécute une fois sur chaque chemin de sortie de run_conversation, couvrant :
- la réponse finale,
final_response; - la réponse avant transformation,
pre_transform_response; - les commentaires intermédiaires et les commentaires Codex.
La sortie est le bon endroit parce que c’est ce que livrent la gateway (e-mail compris), le cron, les tâches de fond, les chat completions, les items de sortie de la Responses API et le CLI. Une seule clôture à la sortie les couvre tous.
Il y a une subtilité qui rend cela sûr : la grammaire ne supprime que les spans en forme de bloc — balises sur leur propre ligne — exactement comme le nettoyeur de streaming. La prose qui mentionne le nom de la balise en ligne (une documentation qui explique le bloc, par exemple) est préservée. C’est précisément cette contrainte de frontière de bloc qui avait fait retirer l’ancien nettoyage regex sur la chaîne entière : il abîmait du contenu légitime.
Seul le texte livré change. La ligne persistée et les messages renvoyés au modèle sont intacts, donc le contexte propre du modèle et son préfixe en cache ne sont pas affectés — il voit toujours la mémoire au tour suivant.
Ce qui reste à découvert
La PR liste ses propres angles morts, et ils valent la peine d’être retenus. Les surfaces qui lisent la transcription brute portent encore un bloc recopié : les messages du run.completed d’un Run API, et SessionDB.get_messages (l’endpoint REST /api/sessions/{id}/messages, le prefetch d’historique desktop, les messages de session du serveur API).
Autrement dit : le chemin de livraison est propre ; certains chemins de lecture d’archives ne le sont pas. Si vous redistribuez des transcriptions de session — synchronisation ailleurs, intégration dans un autre outil — cet angle mort vous concerne toujours.
Ce que vous devriez faire
- Mettez à jour. Le correctif a été mergé le 2026-11-12 (PR #153655). La v0.23.1 est sortie le 2026-11-10 : c’est donc un changement de
main, pas de la v0.23.1. - Gardez les identifiants hors de la mémoire. La mémoire est une donnée injectée dans le contexte à chaque tour — par définition une surface très exposée. Mots de passe, tokens et données personnelles de clients appartiennent aux secrets ou aux variables d’environnement, pas à MEMORY.md ni à un service de mémoire. Ce conseil valait avant ce correctif et vaut après.
- Cloisonnez la mémoire par profil. Si un profil parle à des destinataires externes (e-mail, groupes de chat, support), sa mémoire ne devrait pas transporter de matière interne sensible. Isoler la mémoire par profil vaut mieux que nettoyer après coup.
- Auditez vos canaux non streaming. E-mail, webhooks et livraison par API tierce envoient tous le texte final directement. Une défaillance à cet endroit ne produit aucun avertissement à l’écran — juste un message déjà parti.
Mise à jour (17/11/2026) : ces changements sont sortis dans la v0.23.2 (16 novembre) : un
hermes updateles récupère. Le « pas dans la v0.23.1 » ci-dessus est un instantané du jour de publication.
La mémoire, c’est ce qui donne à un agent l’impression de connaître votre projet. C’est aussi un tas de choses que vous croyiez être le seul à connaître, qui voyagent à chaque requête. Ce canal est fermé maintenant ; les habitudes, elles, restent à votre charge.
Pour aller plus loin : la porte de contrôle de la mémoire, la référence des commandes de mémoire, et la mémoire sémantique LanceDB.