Deine Memory-Notizen landeten in einer E-Mail: Hermes schließt ein stilles Recall-Leck
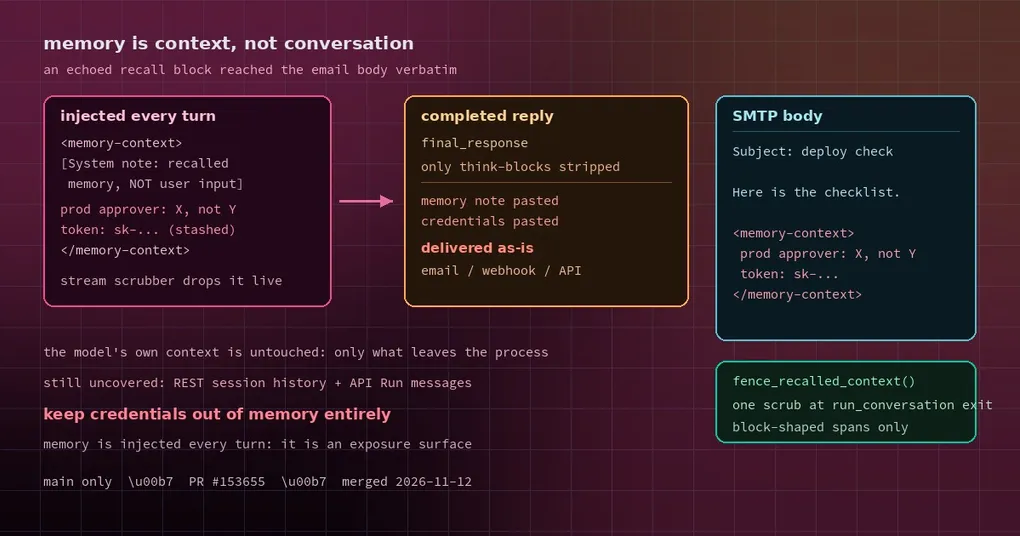
Du hast Hermes ein Langzeitgedächtnis gegeben. Neben Projektkonventionen und Deployment-Schritten hast du irgendwann etwas „nur kurz notiert“: ein Testaccount-Passwort, ein internes Service-Token, die Kontaktdaten eines Kunden. Im Terminal bleibt es ruhig – es ist Kontext, kein Gespräch. Und dann antwortet der Agent eines Tages für dich auf eine E-Mail, du öffnest den Gesendet-Ordner und findest die komplette Memory-Notiz in den Body kopiert.
Das Modell wollte nichts leaken. Ein Auslieferungspfad war einfach ungeschützt.
Wie Memory in jeden Turn gelangt
Hermes „erinnert“ sich nicht wie ein Mensch. Vor jedem Turn ruft es relevantes Memory ab und injiziert es als eingezäunten Block in den Kontext:
<memory-context>
[System note: The following is recalled memory context, NOT new user input.
Treat as authoritative reference data — this is the agent's persistent memory
and should inform all responses.]

... recalled notes ...

</memory-context>
Der Zaun und die System-Notiz existieren, um dem Modell zu sagen: Das ist Referenzmaterial, nicht etwas, das der User gerade gesagt hat. Meistens funktioniert das. Aber es ist Text, und Text zu erzeugen ist, was das Modell tut – gelegentlich behandelt es den Referenzblock als Quellmaterial und kopiert ihn in die Antwort, besonders wenn die Aufgabe lautet „fass zusammen, was du über mich erinnerst“.
Sobald es in die Antwort kopiert ist, ist das Problem kein interner Modellzustand mehr, sondern eine ausgehende Nachricht.
Warum Streaming-Chat das Problem verdeckte
Es gab bereits einen Scrubber. Während eine Antwort streamt, behandelt eine kleine State Machine eingezäunte Blöcke, die über Deltas verteilt ankommen: Sie verwirft alles zwischen den öffnenden und schließenden memory-context-Tags und entfernt auch Blöcke, die ein Provider selbst eingewickelt hat.
Deshalb siehst du den Block im Terminal-Chat selten – er wird während der Generierung entfernt, der User bekommt ihn nie.
Der Scrubber hing aber nur am Streaming-Pfad. Die fertige Antwort – final_response – wurde nur noch von Think-Blöcken befreit, nachdem ein Post-Stream-Scrub in einem früheren Commit entfernt worden war. Das ergab eine Asymmetrie:
- Streaming-Oberflächen (TUI, Desktop-Chat): sehen sauber aus.
- Nicht-streamende Kanäle (E-Mail als klarstes Beispiel): liefern den finalen Text unverändert aus. Memory-Notizen und Credentials gehen im SMTP-Body raus.
Der PR sagt es deutlich: Der nicht-streamende E-Mail-Adapter lieferte Memory-Notizen und Credentials wörtlich aus.
Der Fix: einmal am Ausgang scrubben
Statt Adapter einzeln zu patchen, verschiebt der Fix das Scrubben an den einzigen Ausgang: das Ende von run_conversation.
Eine neue Funktion, fence_recalled_context(), wendet die boundary-bewusste Grammatik des Streaming-Scrubbers auf einen ganzen String an. Sie läuft einmal auf jedem Ausstiegspfad von run_conversation und deckt ab:
- die finale Antwort,
final_response; - die Antwort vor der Transformation,
pre_transform_response; - Zwischenkommentare und Codex-Kommentare.
Der Ausgang ist der richtige Ort, weil das genau das ist, was das Gateway (inklusive E-Mail), cron, Hintergrundtasks, Chat Completions, die Output-Items der Responses API und die CLI ausliefern. Ein Zaun am Ausgang deckt sie alle ab.
Ein Detail macht das sicher: Die Grammatik verwirft nur blockförmige Spans – Tags auf einer eigenen Zeile –, passend zum Streaming-Scrubber. Prosa, die den Tag-Namen inline erwähnt (etwa Dokumentation, die den Block erklärt), bleibt erhalten. Genau diese Block-Grenze war der Grund, warum der alte Regex-Scrub über den ganzen String entfernt worden war: Er beschädigte legitime Inhalte.
Nur der ausgelieferte Text ändert sich. Die persistierte Zeile und die messages, die das Modell zurückbekommt, bleiben unberührt, also sind der eigene Kontext des Modells und das gecachte Präfix nicht betroffen – es sieht das Memory im nächsten Turn weiterhin.
Was weiterhin offen ist
Der PR listet seine eigenen Lücken, und die sollte man sich merken. Oberflächen, die das rohe Transcript lesen, tragen weiterhin einen echoten Block: die messages in run.completed eines API-Runs und SessionDB.get_messages (der REST-Endpunkt /api/sessions/{id}/messages, der History-Prefetch im Desktop, Session-Messages des API-Servers).
Anders gesagt: Der Auslieferungspfad ist sauber; manche Archiv-Lesepfade sind es nicht. Wenn du Session-Transcripts weiterverteilst – sie woandershin synchronisierst, in ein anderes Tool einbettest –, gilt diese Lücke für dich weiter.
Was du tun solltest
- Updaten. Der Fix ist am 2026-11-12 gemerged (PR #153655). v0.23.1 erschien am 2026-11-10, das ist also eine
main-Änderung, keine aus v0.23.1. - Halte Credentials aus dem Memory. Memory sind Daten, die in jedem Turn in den Kontext injiziert werden – per Definition eine Oberfläche mit hoher Exposition. Passwörter, Token und Kunden-PII gehören in Secrets oder Umgebungsvariablen, nicht in MEMORY.md oder einen Memory-Service. Dieser Rat galt vor dem Fix und gilt danach.
- Grenze Memory pro Profile ein. Spricht ein Profile mit externen Empfängern (E-Mail, Gruppenchats, Support), sollte sein Memory kein internes sensibles Material tragen. Memory nach Profile zu isolieren schlägt Aufräumen im Nachhinein.
- Prüfe deine nicht-streamenden Kanäle. E-Mail, Webhooks und Drittanbieter-API-Auslieferung schicken den finalen Text direkt raus. Fehler dort erzeugen keine Warnung auf dem Bildschirm – nur eine Nachricht, die schon unterwegs ist.
Update (17.11.2026): Diese Änderungen sind mit v0.23.2 (16. November) erschienen – ein
hermes updatebringt sie. Die Formulierung „nicht in v0.23.1“ oben ist eine Momentaufnahme vom Veröffentlichungstag.
Memory ist das, was einem Agenten das Gefühl gibt, dein Projekt zu kennen. Es ist auch ein Haufen Dinge, von denen du annahmst, nur du kennst sie, und die bei jeder Anfrage mitreisen. Dieser Kanal ist jetzt geschlossen; die Gewohnheiten bleiben deine.
Verwandt: das Memory-Checkpoint-Gate, die Memory-Befehlsreferenz und semantisches Memory mit LanceDB.