Épingler des skills dans chaque session : skills.auto_load, pour que l'agent n'oublie jamais votre process
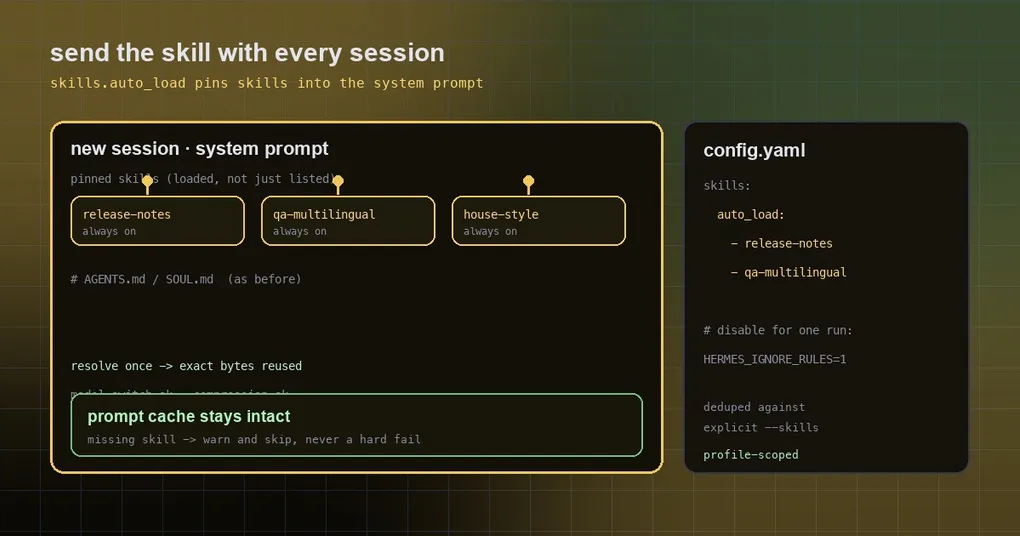
Le lundi matin, vous ouvrez une session toute neuve et vous collez les trois mêmes lignes avant même de pouvoir commencer : suivre notre gabarit maison, lancer le script de QA avant publication, ne jamais utiliser d’emoji comme titre. Le mercredi, vous changez de modèle et l’agent oublie le gabarit. Le vendredi, après une passe de compression, il se met à écrire dans une structure complètement différente — alors que tout ce que vous vouliez, c’était que ce process soit simplement là, sans avoir à le répéter.
Le système de skills a été conçu pour fonctionner à la demande : l’agent lit gratuitement la description courte de chaque skill et ne charge le corps complet que lorsqu’une tâche l’exige vraiment. Ce design économise des tokens, mais il suppose que la tâche a l’air d’avoir besoin du skill. Quand votre process est une contrainte permanente — un style d’écriture, une checklist de relecture, une procédure de release — le chargement à la demande arrive souvent trop tard.
Ce que change auto_load
Dans le config.yaml du profile :
skills:
  auto_load:
    - release-notes
    - qa-multilingual
Ces skills sont désormais entièrement chargés au début de chaque nouvelle session (injectés dans le system prompt en tant que skills chargés), et non simplement listés dans le catalogue. Cela couvre toutes les surfaces d’agent : CLI, TUI, gateway, tâches cron et agents API. La valeur par défaut est une liste vide, c’est-à-dire le comportement à la demande que vous connaissiez déjà.
Le parallèle est facile à faire : Cursor livre ce modèle sous le nom de Custom Modes — on choisit un skill, on l’épingle, et l’agent reste sur un mode opératoire. Côté Hermes, il s’agit d’une liste de configuration limitée au profile, donc le mode opératoire est bien là quelle que soit l’interface ou le modèle que vous utilisez aujourd’hui.
Un détail qu’il vaut la peine de souligner : les skills présents dans auto_load sont dédupliqués par nom canonique face aux demandes explicites --skills, et ils passent par les mêmes filtres — un skill désactivé n’est pas injecté, et un skill activé compte toujours dans l’usage de Curator, si bien qu’un skill que personne n’utilise finit par être nettoyé au lieu de rester « populaire » pour toujours parce qu’il a été épinglé.
En quoi cela diffère des trois autres façons dont un skill atteint le prompt
| Voie | Quand elle s’applique | Idéal pour |
|---|---|---|
| L’index de descriptions (par défaut) | Toujours présent, mais uniquement la description courte | La plupart des skills : l’agent décide quand il en a besoin |
skills.auto_load |
À chaque nouvelle session, corps complet chargé | Les contraintes permanentes : style maison, checklists de relecture, procédure de release |
--skills explicite en ligne de commande |
Cette invocation uniquement | Les tâches ponctuelles, ou l’essai d’un skill |
| Les répertoires de skills locaux au projet | Découverts quand leur déclencheur s’applique | Les conventions de dépôt qui voyagent avec le code |
Ils se cumulent. auto_load est le socle, --skills représente « ce dont cette exécution a besoin en plus », et les skills locaux au projet sont « les règles de ce dépôt ».
Pourquoi cela ne fait pas exploser le coût de votre prompt
C’est la partie la plus soignée de l’implémentation, et c’est ce qui rend la fonctionnalité digne de confiance. Épingler un skill signifie que chaque session transporte un bloc fixe de system prompt — implémenté à la légère, cela casse deux choses d’un coup : la taille des requêtes et le cache de prompt.
Ce qui se passe réellement : l’injection est résolue une seule fois, au premier assemblage du system prompt de l’agent, et les octets rendus exacts sont réutilisés à travers les changements de modèle, la compression et la restauration du préfixe statique. Autrement dit, elle fait partie du préfixe mis en cache au lieu d’être un contenu mutable réassemblé à chaque tour. La PR le vérifie spécifiquement : après mutation du fichier de skill sur le disque, le rendu auto-load du même agent reste stable au bit près — sinon le cache serait invalidé immédiatement.
La même vérification couvre deux comportements de plus : un skill manquant avertit et est ignoré au lieu de faire échouer le démarrage de session, et --ignore-rules (ou HERMES_IGNORE_RULES=1) supprime l’auto-load en même temps que le reste du contexte auto-injecté.
Quand ne pas l’utiliser
- N’épinglez pas une douzaine de skills. Chaque skill épinglé occupe du contexte permanent ; épinglez-en dix et vous commencerez à payer des tokens pour des procédures que vous ne touchez jamais. Deux ou trois contraintes réellement globales, c’est le bon équilibre.
- N’épinglez pas un skill sur lequel vous itérez activement. Comme le rendu est résolu une fois et stable au bit près, modifier le fichier de skill en pleine session ne change pas la session en cours. C’est la fonctionnalité qui marche comme prévu — cela signifie simplement « modifier, puis démarrer une nouvelle session ».
- Parfois, vous voulez une exécution propre :
HERMES_IGNORE_RULES=1 hermes chat -q "...", ou--ignore-rules; ajoutez--ignore-user-configen CI pour une exécution entièrement isolée.
Un cas réel : épinglez votre procédure de release
Supposez que vous ayez une routine de release figée — comment le numéro de version est dérivé, quel script de QA tourne, quel est l’ordre des sections. Écrivez-la sous forme de skill, puis épinglez-le :
skills:
  auto_load:
    - release-notes
    - qa-multilingual
Vérifiez ensuite trois choses :
hermes config get skills.auto_load          # confirmer la valeur du profile
hermes session new                          # démarrer une session neuve
hermes skills list                          # est-il compté comme chargé ?
Demandez-lui maintenant de faire le travail et regardez s’il utilise votre gabarit du premier coup, sans que vous ayez dit « suis notre gabarit » au préalable. Sinon, vérifiez les noms des skills (une faute de frappe ne produit qu’un avertissement et un saut), puis vérifiez que vous n’avez pas démarré la session avec --ignore-rules.
C’est aussi ce qui rend le changement de modèle sûr : passez à un modèle bon marché pour le travail de routine et à un modèle costaud pour les cas difficiles, et les skills épinglés suivent — et comme les octets rendus ne changent pas, le préfixe mis en cache survit au changement. Si vous voulez le même process dans les exécutions sans surveillance, associez-le à stream-json pour que la CI puisse décider si l’exécution a réussi, et aux skills locaux au projet pour que les conventions propres à un dépôt voyagent avec son code.
En résumé
skills.auto_load a l’air d’un petit confort et se comporte comme une fonctionnalité de fiabilité : il transforme « une contrainte que je répète à chaque fois » en « l’état par défaut d’une session ». Vous payez du contexte permanent pour de la cohérence de comportement — ce qui compte le plus précisément quand l’agent tourne avec un autre modèle, après une compression, ou sans surveillance sur une planification. Pour voir quelle release l’a livré et ce qui a changé à côté, lisez ce que la v0.21.4 a réellement livré ; pour le système dans son ensemble, voyez la référence de la commande hermes skills.