Skills in jede Session heften: skills.auto_load, damit der Agent deinen Prozess nie vergisst
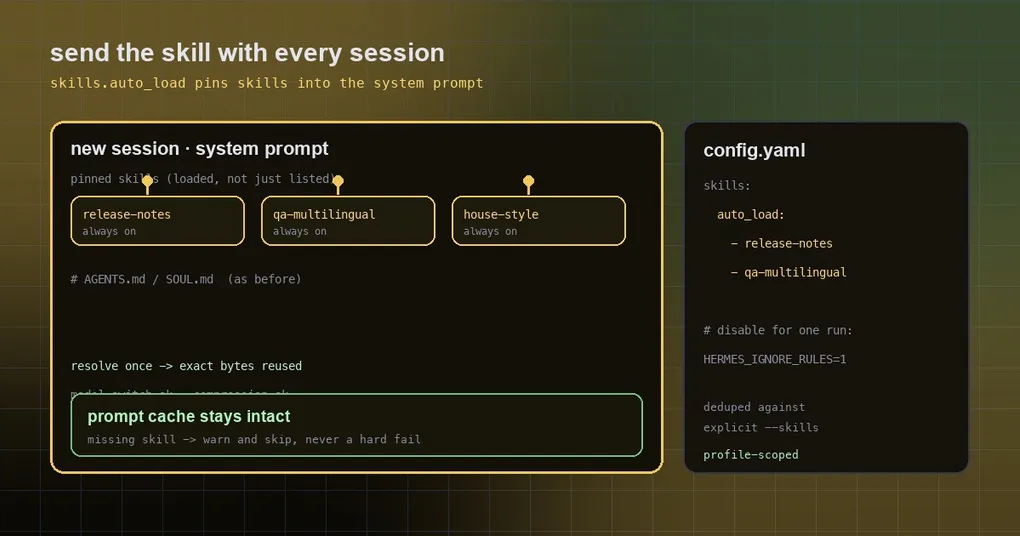
Montagmorgen öffnest du eine frische Session und fügst dieselben drei Zeilen ein, bevor du überhaupt anfangen kannst: unserem Haus-Template folgen, das QA-Skript vor dem Veröffentlichen ausführen, niemals Emoji als Überschrift verwenden. Am Mittwoch wechselst du das Modell und der Agent vergisst das Template. Am Freitag, nach einem Kompressions-Durchlauf, schreibt er plötzlich in einer völlig anderen Struktur — und du wolltest doch nur, dass dieser Prozess einfach da ist, ohne ihn jedes Mal neu zu erwähnen.
Das Skills-System wurde auf On-Demand ausgelegt: Der Agent liest die kurze Beschreibung jedes Skills kostenlos und lädt den vollständigen Body nur, wenn eine Aufgabe tatsächlich danach verlangt. Dieses Design spart Token, setzt aber voraus, dass die Aufgabe so aussieht, als bräuchte sie das Skill. Wenn dein Prozess eine durchgehende Vorgabe ist — ein Schreibstil, eine Review-Checkliste, eine Release-Prozedur — kommt das On-Demand-Laden oft zu spät.
Was auto_load ändert
In der config.yaml des Profiles:
skills:
  auto_load:
    - release-notes
    - qa-multilingual
Diese Skills sind jetzt zu Beginn jeder neuen Session vollständig geladen (als geladene Skills in den System-Prompt injiziert) und nicht bloß im Katalog aufgeführt. Es deckt jede Agent-Oberfläche ab: CLI, TUI, Gateway, Cron-Jobs und API-Agents. Der Default ist eine leere Liste, was genau dem On-Demand-Verhalten entspricht, das du schon hattest.
Die Parallele ist leicht zu ziehen: Cursor liefert dieses Muster als Custom Modes — ein Skill auswählen, anheften, den Agent auf einem Playbook halten. Auf der Hermes-Seite ist es eine Profile-scoped Config-Liste, sodass das Playbook da ist, egal welche Oberfläche oder welches Modell du heute verwendest.
Ein Detail, das es wert ist, eigens erwähnt zu werden: Skills in auto_load werden anhand des kanonischen Namens dedupliziert gegen explizite --skills-Anfragen, und sie durchlaufen dieselben Gates — ein deaktiviertes Skill wird nicht injiziert, und ein aktiviertes zählt weiterhin auf die Curator-Nutzung, sodass ein Skill, das niemand verwendet, irgendwann aufgeräumt wird, statt für immer „populär“ zu bleiben, weil es angeheftet war.
Wie es sich von den anderen drei Wegen unterscheidet, auf denen ein Skill in den Prompt gelangt
| Weg | Wann es greift | Gut für |
|---|---|---|
| Der Beschreibungs-Index (Default) | Immer vorhanden, aber nur die kurze Beschreibung | Die meisten Skills: Der Agent entscheidet, wann er eines braucht |
skills.auto_load |
Jede neue Session, vollständiger Body geladen | Durchgehende Vorgaben: Haus-Stil, Review-Checklisten, Release-Prozedur |
Explizites --skills auf der Kommandozeile |
Nur für diesen Aufruf | Einmalige Aufgaben oder um ein Skill auszuprobieren |
| Projektlokale Skill-Verzeichnisse | Entdeckt, wenn ihr Trigger greift | Repository-Konventionen, die mit dem Code reisen |
Sie stapeln sich. auto_load ist der Boden, --skills ist „was dieser Lauf zusätzlich braucht“, und projektlokale Skills sind „die Regeln dieses Repos“.
Warum es deine Prompt-Kosten nicht sprengt
Das ist der sorgfältigste Teil der Implementierung, und es ist der Grund, warum das Feature Vertrauen verdient. Ein Skill anzuheften bedeutet, dass jede Session einen festen Block System-Prompt mit sich trägt — nachlässig implementiert bricht das zwei Dinge gleichzeitig: Request-Größe und Prompt-Caching.
Was tatsächlich passiert: Die Injektion wird einmal aufgelöst, wenn der System-Prompt des Agents zum ersten Mal gebaut wird, und die exakten gerenderten Bytes werden über Modellwechsel, Kompression und Wiederherstellung des statischen Präfix hinweg wiederverwendet. Mit anderen Worten: Sie wird Teil des gecachten Präfix, statt veränderlicher Inhalt zu sein, der in jedem Turn neu zusammengesetzt wird. Der PR verifiziert genau das: Nachdem die Skill-Datei auf der Platte verändert wurde, bleibt das Auto-Load-Rendering desselben Agents byte-stabil — andernfalls würde der Cache sofort ungültig.
Dieselbe Verifikation deckt zwei weitere Verhaltensweisen ab: Ein fehlendes Skill warnt und wird übersprungen, statt den Session-Start zu brechen, und --ignore-rules (oder HERMES_IGNORE_RULES=1) unterdrückt das Auto-Load zusammen mit dem Rest des automatisch injizierten Kontexts.
Wann man es nicht verwenden sollte
- Heftet nicht ein Dutzend Skills an. Jedes angeheftete Skill belegt stehenden Kontext; heftest du zehn an, fängst du an, Token für Prozeduren zu zahlen, die du nie anfasst. Zwei oder drei wirklich globale Vorgaben sind der Sweet Spot.
- Heftet kein Skill an, an dem du gerade aktiv arbeitest. Weil das Rendering einmal aufgelöst wird und byte-stabil ist, ändert das Bearbeiten der Skill-Datei mitten in der Session die laufende Session nicht. Das ist das Feature, das exakt wie entworfen arbeitet — es bedeutet nur „bearbeiten, dann eine neue Session starten“.
- Gelegentlich willst du einen sauberen Lauf:
HERMES_IGNORE_RULES=1 hermes chat -q "...", oder--ignore-rules; ergänze--ignore-user-configin der CI für einen vollständig isolierten Lauf.
Ein echter Anwendungsfall: Hefte deine Release-Prozedur an
Angenommen, du hast eine feste Release-Routine — wie die Versionsnummer abgeleitet wird, welches QA-Skript läuft, wie die Reihenfolge der Abschnitte ist. Schreibe sie als Skill und hefte sie an:
skills:
  auto_load:
    - release-notes
    - qa-multilingual
Dann prüfe drei Dinge:
hermes config get skills.auto_load          # den Profile-Wert bestätigen
hermes session new                          # eine frische Session starten
hermes skills list                          # wird es als geladen gezählt?
Jetzt bitte ihn, die Arbeit zu erledigen, und beobachte, ob er dein Template beim ersten Versuch verwendet, ohne dass du vorher „unserem Template folgen“ sagst. Wenn nicht, prüfe die Skill-Namen (ein Tippfehler erzeugt nur eine Warnung und ein Überspringen) und dann, ob du die Session mit --ignore-rules gestartet hast.
Das ist auch das, was Modellwechsel sicher macht: Wechsle für Routinearbeit auf ein günstiges Modell und für die schwierigen Fälle auf ein starkes, und die angehefteten Skills kommen mit — und weil sich die gerenderten Bytes nicht ändern, überlebt das gecachte Präfix den Wechsel. Wenn du denselben Prozess auch in unbeaufsichtigten Läufen willst, kombiniere es mit stream-json, damit die CI entscheiden kann, ob der Lauf erfolgreich war, und mit projektlokalen Skills, damit die eigenen Konventionen eines Repositories mit seinem Code reisen.
Die Kurzfassung
skills.auto_load sieht wie eine kleine Annehmlichkeit aus und verhält sich wie ein Reliability-Feature: Es verwandelt „eine Vorgabe, die ich jedes Mal wiederhole“ in „den Standardzustand einer Session“. Du zahlst stehenden Kontext für Verhaltenskonsistenz — was genau dann am wichtigsten ist, wenn der Agent mit einem anderen Modell läuft, nach einer Kompression oder unbeaufsichtigt nach Zeitplan. Um zu sehen, welches Release es ausgeliefert hat und was sich daneben sonst geändert hat, lies was v0.21.4 tatsächlich ausgeliefert hat; für das größere System siehe die hermes skills Befehl-Referenz.