Fijar skills en cada session: skills.auto_load para que el agent nunca olvide tu proceso
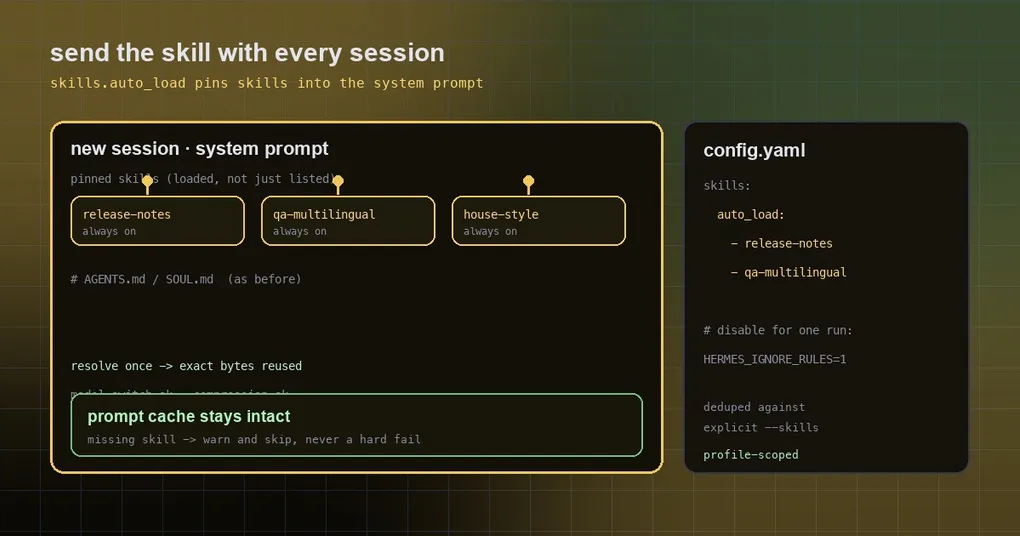
El lunes por la mañana abres una session nueva y pegas las mismas tres líneas antes de poder empezar: sigue nuestra plantilla interna, ejecuta el script de QA antes de publicar, nunca uses emoji como encabezado. El miércoles cambias de modelo y el agent se olvida de la plantilla. El viernes, después de una pasada de compresión, empieza a escribir con una estructura completamente distinta — y tú solo querías que ese proceso estuviera ahí, sin tener que repetirlo.
El sistema de skills se diseñó para ser bajo demanda: el agent lee gratis la descripción corta de cada skill y solo carga el cuerpo completo cuando una tarea realmente lo pide. Ese diseño ahorra token, pero da por supuesto que la tarea parece necesitar el skill. Cuando tu proceso es una restricción permanente — un estilo de escritura, una checklist de revisión, un procedimiento de release — la carga bajo demanda suele llegar demasiado tarde.
Qué cambia auto_load
En el config.yaml del profile:
skills:
  auto_load:
    - release-notes
    - qa-multilingual
Esos skills ahora se cargan por completo al inicio de cada nueva session (se inyectan en el prompt de sistema como skills ya cargados), y no se limitan a aparecer en el catálogo. Cubre todas las superficies del agent: CLI, TUI, gateway, trabajos cron y agentes de API. El valor predeterminado es una lista vacía, es decir, el comportamiento bajo demanda que ya tenías.
El paralelismo es fácil de trazar: Cursor ofrece este patrón como Custom Modes — eliges un skill, lo fijas y mantienes al agent sobre un playbook. En el lado de Hermes es una lista de configuración con alcance de profile, así que el playbook está ahí sin importar qué interfaz o modelo uses hoy.
Un detalle que merece mención: los skills de auto_load se deduplican por nombre canónico frente a las peticiones explícitas de --skills, y pasan por las mismas puertas — un skill desactivado no se inyecta, y uno activado sigue contando para el uso del Curator, de modo que un skill que nadie usa acaba limpiándose en lugar de quedarse “popular” para siempre solo porque estaba fijado.
En qué se diferencia de las otras tres vías por las que un skill llega al prompt
| Vía | Cuándo se aplica | Ideal para |
|---|---|---|
| El índice de descripciones (predeterminado) | Siempre presente, pero solo la descripción corta | La mayoría de skills: el agent decide cuándo necesita uno |
skills.auto_load |
En cada nueva session, con el cuerpo completo cargado | Restricciones permanentes: estilo interno, checklists de revisión, procedimiento de release |
--skills explícito en la línea de comandos |
Solo esta invocación | Tareas puntuales, o probar un skill |
| Directorios de skills locales del proyecto | Se descubren cuando aplica su disparador | Convenciones del repositorio que viajan con el código |
Se pueden combinar: auto_load es el suelo, --skills es “lo que esta ejecución necesita además”, y los skills locales del proyecto son “las normas de este repositorio”.
Por qué no dispara el coste de tu prompt
Esta es la parte más cuidada de la implementación, y por eso vale la pena confiar en la función. Fijar un skill significa que cada session arrastra un bloque fijo de prompt de sistema — implementado sin cuidado, eso rompe dos cosas a la vez: el tamaño de la petición y la caché de prompt.
Lo que ocurre en realidad es que la inyección se resuelve una sola vez, cuando se construye por primera vez el prompt de sistema del agent, y los bytes exactos ya renderizados se reutilizan entre cambios de modelo, compresiones y restauraciones del prefijo estático. En otras palabras, pasa a formar parte del prefijo cacheado en lugar de ser contenido mutable que se vuelve a montar en cada turno. La PR lo verifica específicamente: después de modificar el archivo del skill en disco, el renderizado de auto-load del mismo agent sigue siendo estable byte a byte — de lo contrario la caché se invalidaría de inmediato.
Esa misma verificación cubre dos comportamientos más: un skill ausente avisa y se omite en lugar de romper el arranque de la session, y --ignore-rules (o HERMES_IGNORE_RULES=1) suprime el auto-load junto con el resto del contexto inyectado automáticamente.
Cuándo no usarlo
- No fijes una docena de skills. Cada skill fijado ocupa contexto permanente; fija diez y empezarás a pagar token por procedimientos que nunca tocas. Dos o tres restricciones realmente globales son el punto óptimo.
- No fijes un skill que estés iterando activamente. Como el renderizado se resuelve una vez y es estable byte a byte, editar el archivo del skill a mitad de session no cambia la session en ejecución. Eso es la función trabajando según lo diseñado — solo significa “edita y luego abre una session nueva”.
- De vez en cuando quieres una ejecución limpia:
HERMES_IGNORE_RULES=1 hermes chat -q "...", o--ignore-rules; añade--ignore-user-configen CI para una ejecución totalmente aislada.
Un uso real: fija tu procedimiento de release
Supón que tienes una rutina de release fija: cómo se deriva el número de versión, qué script de QA se ejecuta, cuál es el orden de las secciones. Escríbela como un skill y fíjala:
skills:
  auto_load:
    - release-notes
    - qa-multilingual
Luego comprueba tres cosas:
hermes config get skills.auto_load          # confirma el valor del profile
hermes session new                          # abre una session nueva
hermes skills list                          # ¿aparece como cargado?
Ahora pídele que haga el trabajo y observa si usa tu plantilla a la primera, sin que le digas antes “sigue nuestra plantilla”. Si no lo hace, revisa los nombres de los skills (una errata solo produce un aviso y una omisión) y comprueba que no hayas iniciado la session con --ignore-rules.
Esto es también lo que hace seguro cambiar de modelo: pasa a un modelo barato para el trabajo rutinario y a uno potente para los casos difíciles, y los skills fijados van contigo — y como los bytes renderizados no cambian, el prefijo cacheado sobrevive al cambio. Si quieres el mismo proceso también en ejecuciones desatendidas, combínalo con stream-json para que CI pueda decidir si la ejecución tuvo éxito, y con los skills locales del proyecto para que las convenciones propias de un repositorio viajen con su código.
La versión corta
skills.auto_load parece una pequeña comodidad y se comporta como una función de fiabilidad: convierte “una restricción que repito cada vez” en “el estado predeterminado de una session”. Pagas contexto permanente a cambio de consistencia de comportamiento — y eso importa sobre todo cuando el agent corre con otro modelo, después de una compresión o desatendido según un horario. Para ver en qué release llegó y qué más cambió a la vez, lee qué trajo realmente la v0.21.4; para el sistema completo, consulta la referencia del comando hermes skills.