Deux façons dont cron échoue en silence : un thread qui ne démarre jamais, et un job qui revient
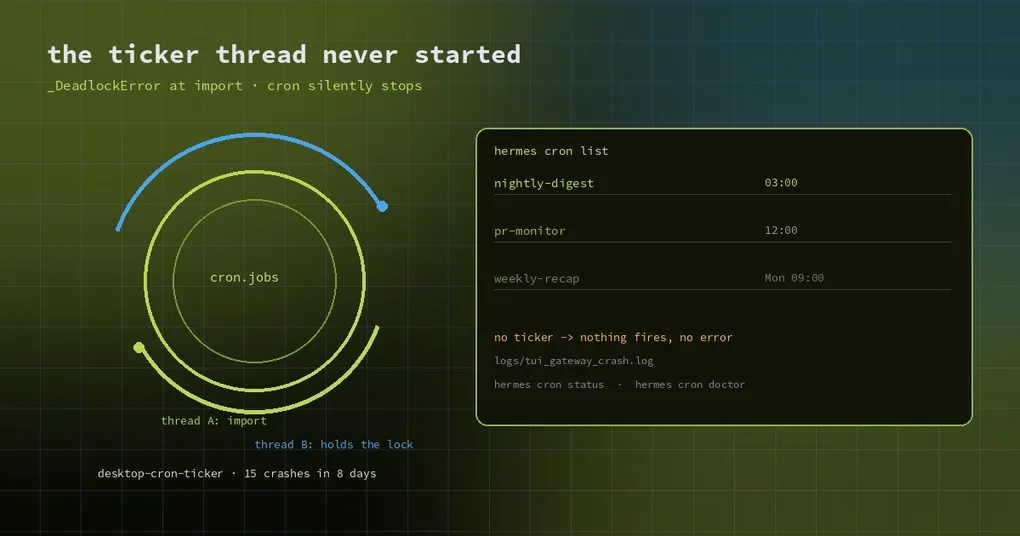
Lundi matin. Les trois jobs qui auraient dû tourner pendant le week-end ne l’ont pas fait. hermes cron list les affiche tous, en bonne santé, et le log ne contient ni erreur ni échec : rien ne s’est passé, parce que le scheduler ne tournait pas.
Les échecs de cron sont presque toujours silencieux. Un appel au modèle réessaie, lève une exception, notifie ; un scheduler qui ne tick jamais ne fait simplement rien. Deux rapports indépendants publiés cette semaine couvrent les variantes les plus discrètes : un thread qui ne démarre jamais, et un job supprimé qui revient tout seul.
Mode un : le thread cron meurt pendant l’import
Le backend desktop (le processus hermes dashboard) embarque un ticker cron in-process pour que les jobs planifiés se déclenchent même sans gateway. Son point d’entrée est _start_desktop_cron_ticker dans hermes_cli/web_server.py, et sa première instruction est from cron.scheduler_provider import ....
Sur Python 3.14, cet import tombe parfois sur le deadlock d’import de modules de CPython :
=== thread exception · 2026-10-24 23:23:13 · thread=desktop-cron-ticker ===
  File ".../hermes_cli/web_server.py", line 107, in _start_desktop_cron_ticker
    from cron.scheduler_provider import InProcessCronScheduler, resolve_cron_scheduler
  File ".../cron/__init__.py", line 13, in <module>
    from cron.jobs import (...)
_frozen_importlib._DeadlockError: deadlock detected by _ModuleLock('cron.jobs')
Le détail décisif n’est pas dans la trace : l’exception est levée dans la première instruction du thread, donc la logique de retry, de fallback et d’alerting ne s’exécute jamais. Le ticker n’existe pas dans ce processus tant qu’il n’a pas redémarré. Un rapporteur l’a rencontré 15 fois en huit jours sur macOS, le lock alternant entre cron.jobs et cron.executions.
Ce qui le rend difficile à repérer, c’est un second scheduler. La plupart des installations font aussi tourner un gateway géré par launchd ou systemd qui tick le même store cron : les jobs continuent de se déclencher et le thread mort ne laisse aucun symptôme. Ce n’est que lorsque le backend desktop est le seul scheduler — une seule machine, l’app uniquement, pas de gateway séparé — que cela devient une panne cron réelle et totalement silencieuse.
Il laisse quand même une trace : ~/.hermes/logs/tui_gateway_crash.log, cherchez thread exception et desktop-cron-ticker. Le deadlock est suivi dans une entrée umbrella antérieure (#134889, Lane 3), et la direction du correctif est simple : importer le store cron sur le main thread avant que le thread du ticker existe, pour supprimer la race plutôt que la réduire.
Mode deux : un job supprimé est réécrit sur le disque
Le second mode est plus humiliant. Vous lancez hermes cron remove <id>, le job disparaît de hermes cron list, et deux vérifications manuelles confirment qu’il est bien parti. Un jour plus tard, il est de retour sur le disque, identique octet pour octet — même created_at, même state=completed, même last_run_at. Aucun chemin de code ne recrée un job one-shot terminé : la seule explication est un writer qui a chargé le store avant la suppression et a vidé sa copie en mémoire ensuite.
Le mécanisme est dans cron/jobs.py. _merge_unexpected_disk_jobs / _unmerged_disk_jobs protègent les lignes présentes sur le disque mais absentes d’un payload de sauvegarde — c’est la direction create, et elle logge (le garde-fou ajouté pour #80624). La direction delete (des lignes du payload qui ont disparu du disque) est réécrite sans condition, sans une seule ligne de log. Un writer de longue durée qui a chargé jobs.json avant votre suppression sauvegarde tout le store à la fin de son travail, et la suppression est défaite en silence.
Le coût dans le rapport était concret : le job one-shot ressuscité pointait vers un script retiré, a relancé une suite nocturne et a produit deux pages de monitoring plus un cycle de RCA. C’est arrivé dans un environnement avec 15 stores cron derrière un gateway multiplexé — plus il y a de writers, plus la race est probable.
Le correctif proposé, ce sont des tombstones de suppression : toute sauvegarde portant removed_ids persiste aussi ces ids avec un timestamp de suppression dans un sidecar par store, cron/jobs.removed.json ; chaque sauvegarde fusionnante soustrait ensuite les ids de tombstones récents de son payload, sauf si le created_at de la ligne est postérieur à la suppression (pour qu’une recréation légitime avec un id recyclé fonctionne encore) — et cette fois, elle logge. Un sidecar plutôt qu’une clé de métadonnées dans jobs.json, pour que les réparations replace=True et les réécritures externes du fichier entier ne puissent pas effacer l’intention de suppression.
Comment trier dans l’ordre
Trois commandes et un fichier suffisent en général à savoir dans quel mode vous êtes :
hermes cron status        # is a scheduler actually running
hermes cron doctor        # common health problems
hermes cron runs          # durable execution attempts: did anything run
hermes cron incidents     # persisted failure incidents
Ensuite, vérifiez à la main : cherchez thread exception dans ~/.hermes/logs/tui_gateway_crash.log. Si status ne signale aucun scheduler, que runs est vide depuis des jours et que le crash log mentionne desktop-cron-ticker, c’est le mode un. Si le job a bien tourné, ou si un job « est revenu », comparez le created_at et le last_run_at de cette ligne dans jobs.json avec ce que vous savez — c’est le mode deux.
Quatre habitudes qui évitent les deux
- Un scheduler par store. Un backend desktop, un gateway launchd et un service systemd qui tick le même store, c’est la principale source de writers invisibles. Gardez-en un.
- Confirmez les suppressions après un tick, pas immédiatement. Revérifiez
hermes cron listquelques minutes plus tard, ou après un redémarrage du scheduler. La race se produit dans une sauvegarde de fermeture, pas au moment de la suppression. - Ne laissez pas cron être le seul signal. Faites remonter la fin des jobs importants ailleurs — un webhook, un message, une ligne dans un fichier. C’est mieux que de lire
hermes cron listaprès coup. - Lancez
hermes cron statusaprès chaque mise à jour, surtout quand la version de Python ou la topologie de scheduling a changé.
La version courte
Les jobs planifiés échouent sans bruit, il faut donc écouter exprès. Un scheduler tourne-t-il, le job a-t-il vraiment tourné, une ligne supprimée est-elle encore sur le disque — chacune de ces questions a une vérification bon marché. Faites-en une habitude et les lundis matins cesseront d’être une surprise.
Pour aller plus loin : le guide de health-check cron, annuler un run en cours, la continuité de mémoire entre les runs cron, ce qu’il y a d’autre dans la fenêtre v0.22.7.