Dos formas en que cron falla en silencio: un hilo que nunca arranca y un trabajo que vuelve
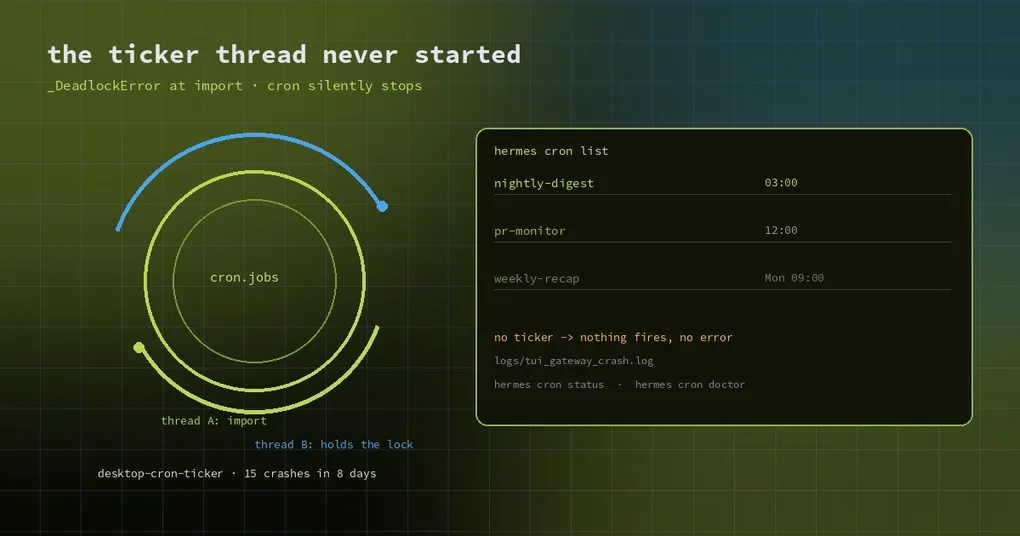
Lunes por la mañana. Los tres trabajos que debían haberse ejecutado durante el fin de semana no se ejecutaron. hermes cron list los muestra todos, sanos, y el log no tiene errores ni fallos: no pasó nada, porque el scheduler no estaba corriendo.
Los fallos de cron son casi siempre silenciosos. Una llamada al modelo reintenta, lanza una excepción, notifica; un scheduler que nunca hace tick simplemente no trabaja. Dos reportes independientes de esta semana cubren las versiones más calladas: un hilo que nunca arranca y un trabajo que borraste y vuelve por su cuenta.
Modo uno: el hilo de cron muere durante el import
El backend de escritorio (el proceso hermes dashboard) ejecuta un ticker de cron en proceso para que los trabajos programados sigan disparándose cuando no hay ningún gateway cerca. Su punto de entrada es _start_desktop_cron_ticker en hermes_cli/web_server.py, y su primera sentencia es from cron.scheduler_provider import ....
En Python 3.14 ese import a veces choca con el deadlock de importación de módulos de CPython:
=== thread exception · 2026-10-24 23:23:13 · thread=desktop-cron-ticker ===
  File ".../hermes_cli/web_server.py", line 107, in _start_desktop_cron_ticker
    from cron.scheduler_provider import InProcessCronScheduler, resolve_cron_scheduler
  File ".../cron/__init__.py", line 13, in <module>
    from cron.jobs import (...)
_frozen_importlib._DeadlockError: deadlock detected by _ModuleLock('cron.jobs')
El detalle crucial no está en el trace: la excepción se lanza dentro de la primera sentencia del hilo, así que la lógica de reintento, fallback y alertas nunca llega a ejecutarse. El ticker no existe en ese proceso hasta que se reinicia. Un reportero lo sufrió 15 veces en ocho días en macOS, con el lock alternando entre cron.jobs y cron.executions.
Lo que lo hace difícil de notar es un segundo scheduler. La mayoría de las instalaciones también ejecutan un gateway gestionado por launchd o systemd que hace tick sobre el mismo store de cron, así que los trabajos siguen disparándose y el hilo muerto no deja síntoma. Solo cuando el backend de escritorio es el único scheduler —una sola máquina, solo la app, sin gateway aparte— se convierte en una caída de cron real y completamente silenciosa.
Deja un rastro: ~/.hermes/logs/tui_gateway_crash.log, busca thread exception y desktop-cron-ticker. El deadlock está registrado en una entrada umbrella anterior (#134889, Lane 3), y la dirección del arreglo es directa: importar el store de cron en el hilo principal antes de que exista el hilo del ticker, para eliminar la carrera en lugar de estrecharla.
Modo dos: un trabajo borrado vuelve a escribirse en disco
El segundo modo es más insultante. Ejecutas hermes cron remove <id>, el trabajo desaparece de hermes cron list y dos comprobaciones manuales confirman que ya no está. Un día después vuelve a estar en disco, idéntico byte a byte: el mismo created_at, el mismo state=completed, el mismo last_run_at. Ningún camino de código recrea un trabajo one-shot completado, así que la única explicación es un writer que cargó el store antes del borrado y volcó su copia en memoria después.
El mecanismo está en cron/jobs.py. _merge_unexpected_disk_jobs / _unmerged_disk_jobs protegen las filas que existen en disco pero faltan en el payload de un guardado: esa es la dirección create, y registra log (el guard añadido para #80624). La dirección delete (filas del payload que ya no están en disco) se escribe de vuelta sin condiciones, sin una sola línea de log. Un writer de larga vida que cargó jobs.json antes de tu borrado guarda el store completo al final de su trabajo, y el borrado se deshace en silencio.
El costo en el reporte fue concreto: el trabajo one-shot resucitado apuntaba a un script retirado, volvió a ejecutar una suite nocturna y produjo dos páginas de monitoreo más un ciclo de RCA. Ocurrió en una instalación con 15 stores de cron detrás de un gateway multiplexado: cuantos más writers, más probable es la carrera.
El arreglo propuesto son lápidas de borrado (delete tombstones): cualquier guardado que lleve removed_ids persiste también esos ids con un timestamp de eliminación en un sidecar por store, cron/jobs.removed.json; cada guardado que hace merge resta entonces los ids de lápidas recientes de su payload, salvo que el created_at de la fila sea posterior al borrado (así una recreación legítima con un id reciclado sigue funcionando), y esta vez registra log. Un sidecar y no una clave de metadatos en jobs.json, para que las reparaciones con replace=True y las reescrituras externas de archivo completo no puedan borrar la intención de eliminar.
Cómo hacer el triaje en orden
Tres comandos y un archivo suelen identificar en qué modo estás:
hermes cron status        # is a scheduler actually running
hermes cron doctor        # common health problems
hermes cron runs          # durable execution attempts: did anything run
hermes cron incidents     # persisted failure incidents
Luego revisa a mano: busca thread exception en ~/.hermes/logs/tui_gateway_crash.log. Si status informa que no hay scheduler, runs está vacío desde hace días y el crash log menciona desktop-cron-ticker, es el modo uno. Si el trabajo sí se ejecutó, o si un trabajo «volvió», compara el created_at y el last_run_at de esa fila en jobs.json con lo que sabes: es el modo dos.
Cuatro hábitos que evitan ambos
- Un scheduler por store. Un backend de escritorio, un gateway de launchd y un servicio de systemd haciendo tick sobre el mismo store es la principal fuente de writers invisibles. Quédate con uno.
- Confirma los borrados después de un tick, no de inmediato. Vuelve a revisar
hermes cron listunos minutos después, o tras reiniciar el scheduler. La carrera ocurre en un guardado de cierre, no en el momento del borrado. - No dejes que cron sea la única señal. Haz que los trabajos importantes reporten su finalización en algún lugar externo: un webhook, un mensaje, una línea en un archivo. Eso supera a leer
hermes cron lista posteriori. - Ejecuta
hermes cron statusdespués de cada actualización, sobre todo cuando cambió la versión de Python o la topología de scheduling.
La versión corta
Los trabajos programados fallan sin hacer ruido, así que tienes que escuchar a propósito. ¿Hay un scheduler corriendo?, ¿se ejecutó de verdad el trabajo?, ¿sigue una fila borrada en disco? Cada pregunta tiene una comprobación barata. Convierte las comprobaciones en hábito y los lunes por la mañana dejan de ser una sorpresa.
Lecturas relacionadas: la guía de health-check de cron, cancelar una ejecución en curso, continuidad de memoria entre ejecuciones de cron, qué más hay en la ventana de la v0.22.7.