Zwei Wege, wie cron lautlos scheitert: ein Thread, der nie startet, und ein Job, der wiederkommt
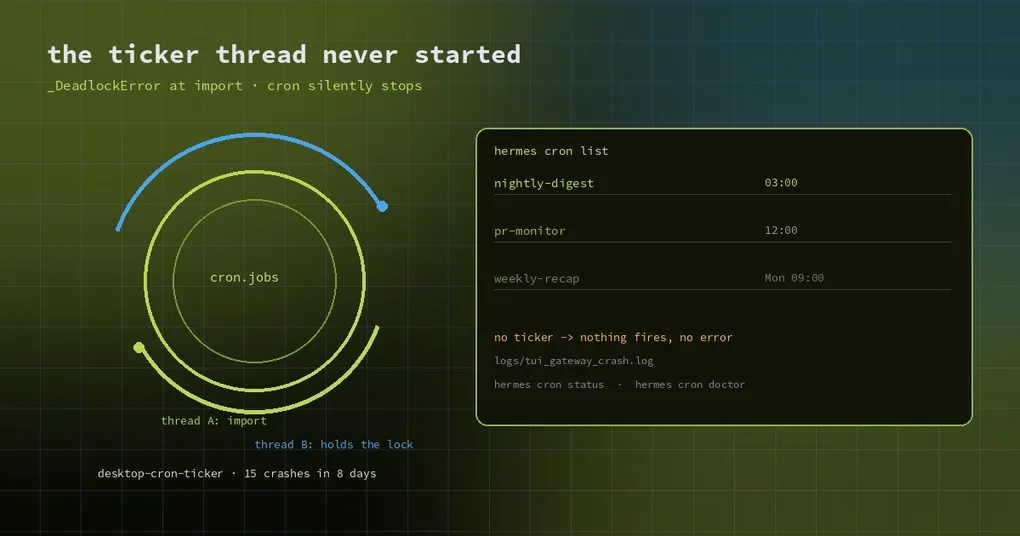
Montagmorgen. Die drei Jobs, die übers Wochenende hätten laufen sollen, sind nicht gelaufen. hermes cron list zeigt sie alle, gesund, und im Log stehen weder Fehler noch Fehlschläge – es ist nichts passiert, weil der Scheduler nicht lief.
Cron-Fehler sind fast immer stumm. Ein Model-Call versucht es erneut, wirft eine Exception, benachrichtigt; ein Scheduler, der nie tickt, arbeitet einfach nicht. Zwei unabhängige Berichte aus dieser Woche decken die leisesten Varianten ab: ein Thread, der nie startet, und ein Job, den man gelöscht hat und der von selbst zurückkommt.
Modus eins: Der cron-Thread stirbt beim Import
Das Desktop-Backend (der Prozess hermes dashboard) betreibt einen In-Process-cron-Ticker, damit geplante Jobs auch ohne gateway feuern. Sein Einstiegspunkt ist _start_desktop_cron_ticker in hermes_cli/web_server.py, und seine erste Anweisung lautet from cron.scheduler_provider import ....
Auf Python 3.14 trifft dieser Import gelegentlich auf den Modul-Import-Deadlock von CPython:
=== thread exception · 2026-10-24 23:23:13 · thread=desktop-cron-ticker ===
  File ".../hermes_cli/web_server.py", line 107, in _start_desktop_cron_ticker
    from cron.scheduler_provider import InProcessCronScheduler, resolve_cron_scheduler
  File ".../cron/__init__.py", line 13, in <module>
    from cron.jobs import (...)
_frozen_importlib._DeadlockError: deadlock detected by _ModuleLock('cron.jobs')
Das entscheidende Detail steht nicht im Trace: Die Exception wird in der ersten Anweisung des Threads geworfen, also läuft die Logik für Retry, Fallback und Alerting nie an. Der Ticker existiert in diesem Prozess nicht, bis er neu startet. Ein Reporter traf es auf macOS 15-mal in acht Tagen, wobei der Lock zwischen cron.jobs und cron.executions wechselte.
Was es so schwer bemerkbar macht, ist ein zweiter Scheduler. Die meisten Installationen betreiben zusätzlich ein von launchd oder systemd verwaltetes gateway, das denselben cron-Store tickt, also feuern die Jobs weiter und der tote Thread hinterlässt kein Symptom. Erst wenn das Desktop-Backend der einzige Scheduler ist – eine Maschine, nur die App, kein separates gateway –, wird daraus ein echter und völlig lautloser cron-Ausfall.
Eine Spur bleibt trotzdem: ~/.hermes/logs/tui_gateway_crash.log, suche nach thread exception und desktop-cron-ticker. Der Deadlock ist in einem älteren Umbrella-Eintrag erfasst (#134889, Lane 3), und die Richtung des Fixes ist geradlinig: den cron-Store im Main-Thread importieren, bevor der Ticker-Thread existiert, damit die Race entfernt und nicht nur eingegrenzt wird.
Modus zwei: Ein gelöschter Job wird zurück auf die Platte geschrieben
Modus zwei ist die größere Frechheit. Man führt hermes cron remove <id> aus, der Job verschwindet aus hermes cron list, und zwei manuelle Prüfungen bestätigen: weg. Einen Tag später ist er wieder auf der Platte, byte-identisch – gleiches created_at, gleiches state=completed, gleiches last_run_at. Kein Codepfad legt einen abgeschlossenen One-Shot-Job neu an, also bleibt nur eine Erklärung: ein Writer, der den Store vor dem Löschen geladen und seine In-Memory-Kopie danach zurückgeschrieben hat.
Der Mechanismus steckt in cron/jobs.py. _merge_unexpected_disk_jobs / _unmerged_disk_jobs schützen Zeilen, die auf der Platte existieren, aber in einem Save-Payload fehlen – das ist die create-Richtung, und sie loggt (der Guard aus #80624). Die delete-Richtung (Zeilen im Payload, die auf der Platte fehlen) wird bedingungslos zurückgeschrieben, ohne eine Logzeile. Ein langlebiger Writer, der jobs.json vor dem Löschen geladen hat, speichert am Ende seiner Arbeit den ganzen Store – und das Löschen ist still rückgängig gemacht.
Der Preis in dem Bericht war konkret: Der wiederauferstandene One-Shot-Job zeigte auf ein ausgemustertes Skript, ließ eine nächtliche Suite erneut laufen und erzeugte zwei Monitoring-Seiten plus einen RCA-Zyklus. Passiert ist das in einer Umgebung mit 15 cron-Stores hinter einem gemultiplexten gateway – je mehr Writer, desto wahrscheinlicher die Race.
Der vorgeschlagene Fix sind Delete-Tombstones: Jeder Save, der removed_ids trägt, persistiert diese IDs samt Entfernungs-Timestamp zusätzlich in einem Sidecar pro Store, cron/jobs.removed.json; jeder mergende Save zieht dann frische Tombstone-IDs von seinem Payload ab, es sei denn, das created_at der Zeile liegt nach der Entfernung (damit ein legitimes Neuanlegen mit recycelter ID weiter funktioniert) – und diesmal wird geloggt. Ein Sidecar statt eines Metadaten-Keys in jobs.json, damit replace=True-Reparaturen und externe Komplett-Rewrites die Löschabsicht nicht ausradieren können.
Wie man es der Reihe nach eingrenzt
Drei Befehle und eine Datei zeigen meist, in welchem Modus man steckt:
hermes cron status        # is a scheduler actually running
hermes cron doctor        # common health problems
hermes cron runs          # durable execution attempts: did anything run
hermes cron incidents     # persisted failure incidents
Dann von Hand prüfen: ~/.hermes/logs/tui_gateway_crash.log nach thread exception durchsuchen. Wenn status keinen Scheduler meldet, runs seit Tagen leer ist und das Crash-Log desktop-cron-ticker nennt, ist es Modus eins. Wenn der Job tatsächlich lief, oder wenn ein Job „zurückkam“, dann vergleicht man created_at und last_run_at dieser Zeile in jobs.json mit dem, was man weiß – das ist Modus zwei.
Vier Gewohnheiten, die beides verhindern
- Ein Scheduler pro Store. Ein Desktop-Backend, ein launchd-gateway und ein systemd-Service, die denselben Store ticken, sind die Hauptquelle unsichtbarer Writer. Nimm einen.
- Löschungen nach einem Tick bestätigen, nicht sofort. Prüfe
hermes cron listein paar Minuten später oder nach einem Neustart des Schedulers erneut. Die Race steckt in einem abschließenden Save, nicht im Moment des Löschens. - cron darf nicht das einzige Signal sein. Wichtige Jobs sollten ihren Abschluss irgendwo extern melden – ein Webhook, eine Nachricht, eine Zeile in einer Datei. Das schlägt jedes nachträgliche Lesen von
hermes cron list. - Nach jedem Upgrade
hermes cron statusausführen, besonders wenn sich die Python-Version oder die Scheduling-Topologie geändert hat.
Die Kurzfassung
Geplante Jobs scheitern ohne Geräusch, man muss also bewusst hinhören. Läuft ein Scheduler, ist der Job wirklich gelaufen, steht eine gelöschte Zeile noch auf der Platte – für jede dieser Fragen gibt es einen billigen Check. Mach die Checks zur Gewohnheit, dann sind Montagmorgen keine Überraschung mehr.
Lesestoff: der cron-Health-Check-Leitfaden, einen laufenden Run abbrechen, Memory-Kontinuität über cron-Runs hinweg, was sonst im Fenster von v0.22.7 steckt.