Un job cron a réécrit sa propre cible de livraison, et les rapports ont cessé d'arriver
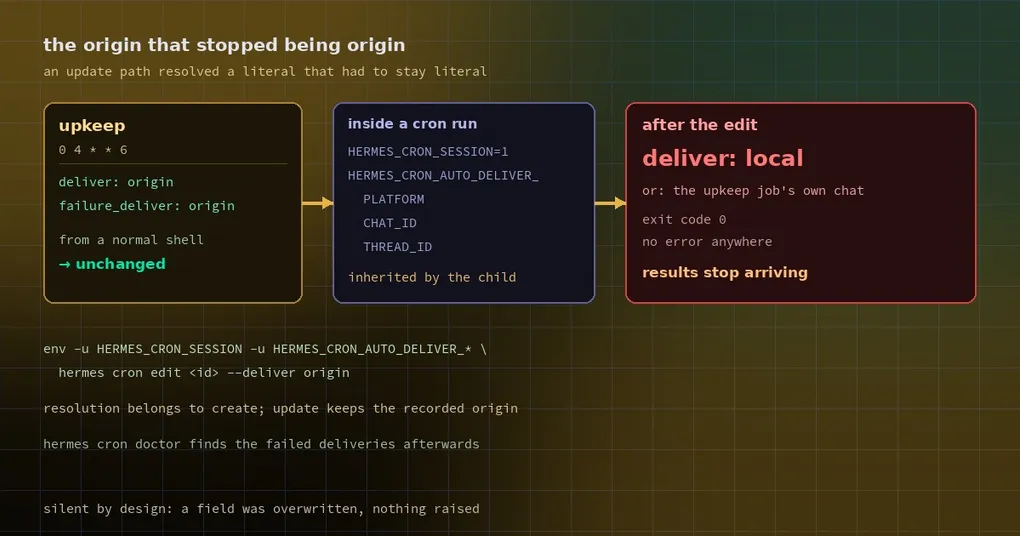
Votre table cron compte 19 jobs. L’un d’eux s’appelle upkeep et exécute « tidy up » à 4 h du matin chaque samedi. Son travail est banal : lister tous les jobs, puis rafraîchir depuis un modèle les prompts et les réglages de livraison de quelques voisins — dont la ligne
hermes cron edit <upkeep-id> --deliver originqui se lit comme « renvoie les résultats dans le chat où j’ai été créé ». La première semaine, tout allait bien. La deuxième, le rapport du samedi n’est pas arrivé. La troisième non plus. hermes cron list affiche le champ deliver de ce job à local — aucune erreur, aucun avertissement : il est simplement passé de « livrer chez moi » à « ne livrer nulle part ».
Ce que signifie réellement origin
La sémantique compte, car le bug se niche à l’intérieur. Le champ deliver d’un job cron peut désigner une cible concrète (telegram:<chat_id>, slack, local, all), ou valoir origin — le chat dans lequel le job a été créé.
origin est une expression relative au moment de la création. À la création du job, Hermes enregistre l’adresse de la conversation à cet instant précis ; toutes les exécutions suivantes livrent à cet endroit. S’il n’existait aucune source exploitable à la création (job créé par un script, ou sur la plateforme api_server en requête/réponse, incapable de recevoir une livraison), un fallback vers le canal d’accueil prend le relais.
La documentation officielle énonce clairement ce principe, dans la section consacrée à la gestion du cron depuis l’intérieur d’une exécution cron :
Pas de livraison en suspens. Une exécution cron est éphémère ;
deliver: origindepuis l’intérieur d’une telle exécution est donc résolu au moment de la création vers la cible concrète du job créateur (platform:chat_id[:thread_id], oulocalsi le job créateur ne livre nulle part).
Retenez ces trois mots : au moment de la création. Le scénario documenté est celui de la création d’un nouveau job depuis une exécution cron — un job flambant neuf ne doit pas pointer vers une session éphémère qui disparaîtra, donc origin est résolu à l’instant même de sa création.
Mettre à jour un job existant est une situation entièrement différente. Le job existe déjà, son origin a été enregistré il y a longtemps, et origin garde pour lui un sens stable. Le résoudre de nouveau à ce stade ne corrige rien : cela corrompt une valeur qui était déjà correcte.
Ce que fait le code
_update_core_fields, dans tools/cronjob_tools.py, fait passer deliver et failure_deliver par le même résolveur sur le chemin de mise à jour :
if deliver is not None:
    ...
    updates["deliver"] = _resolve_cron_context_deliver(_normalize_deliver_param(deliver))
if a["failure_deliver"] is not None:
    ...
    _norm_fd = _resolve_cron_context_deliver(_norm_fd)
    updates["failure_deliver"] = _norm_fd
Et la docstring du résolveur annonce elle-même sa portée (tools/cronjob_job_args.py) :
def _resolve_cron_context_deliver(deliver: Optional[str]) -> Optional[str]:
    """Resolve ``origin`` to a concrete target for creates made FROM a cron run (the creating
    session is ephemeral, so by fire time there is no origin). Non-cron sessions: unchanged.
    Cron sessions: ``origin`` (or omitted) becomes the creating run's ``platform:chat_id[:thread]``
    from HERMES_CRON_AUTO_DELIVER_*, or ``local`` when it has no concrete target; other
    elements pass through. Otherwise the scheduler would guess a home channel."""
« For creates made FROM a cron run. » La première ligne du corps dit exactement la même chose :
if not is_truthy_value(get_session_env("HERMES_CRON_SESSION", "")):
    return deliver
En dehors d’une exécution cron, la valeur est renvoyée intacte. À l’intérieur, origin (et None) deviennent l’adresse concrète du créateur, assemblée à partir de HERMES_CRON_AUTO_DELIVER_PLATFORM / _CHAT_ID / _THREAD_ID ; sans cible concrète, tout retombe sur local.
Le problème, c’est que le scheduler définit ces trois variables pour le job en cours d’exécution (cron/scheduler.py affecte HERMES_CRON_AUTO_DELIVER_* et les marque héritables par les sous-processus). Donc quand vous appelez hermes cron edit depuis une exécution cron, le processus enfant hérite de la cible de livraison du job en cours. Une commande censée signifier « garde ton propre origin » devient « adopte mon chat » — et si le job d’entretien livre lui-même vers local, le résultat est local.
Vous ne verrez rien se produire. updates["deliver"] est simplement écrasé, la commande se termine avec le code 0, et une colonne de hermes cron list a discrètement changé.
Trois vérifications à faire
Un : listez les jobs en origin et confirmez qu’ils affichent toujours origin.
hermes cron listSi vous trouvez des local parmi des jobs que vous n’avez jamais modifiés, voilà ce qui s’est passé.
Deux : lancez le contrôle de santé des livraisons.
hermes cron doctorIl s’agit d’une inspection en lecture seule de toute la flotte : exécutions en échec, livraisons en échec, next_run_at dépassé ou absent, scripts ou workdirs manquants — le code de sortie est non nul dès qu’il détecte un problème. Il ne vous dira pas « origin a été réécrit en local », mais « ce job est configuré pour livrer et échoue sans arrêt » remonte généralement ici.
Trois : ne modifiez pas la livraison depuis l’intérieur d’une exécution cron.
C’est le contournement direct. Un job d’entretien peut sans risque modifier les prompts, les planifications et les noms via l’outil cronjob ; le champ de livraison doit être changé par un humain, ou écrit comme cible explicite plutôt que comme origin.
Si vous devez vraiment effectuer cette modification depuis une exécution cron, retirez les variables autour de l’appel CLI :
env -u HERMES_CRON_SESSION \
    -u HERMES_CRON_AUTO_DELIVER_PLATFORM \
    -u HERMES_CRON_AUTO_DELIVER_CHAT_ID \
    -u HERMES_CRON_AUTO_DELIVER_THREAD_ID \
    hermes cron edit <id> --deliver origin
Le mécanisme se suit facilement : hors d’une « session cron », le résolveur renvoie son entrée dès la première ligne, origin reste littéral, et un origin littéral est parfaitement valide pour un job existant — il possède un origin enregistré, plus un fallback vers le canal d’accueil lorsqu’il n’en a pas.
Pourquoi ce bug est si difficile à repérer
Trois traits silencieux se cumulent :
- Aucune erreur. Le chemin de succès se résume à un écrasement de champ et à un code de sortie 0.
- Exposition différée. L’exécution d’entretien elle-même semble normale ; les dégâts n’apparaissent que lorsque le job voisin se déclenche à son tour et qu’aucune sortie n’arrive — généralement plusieurs jours plus tard.
- Symptômes trompeurs. Votre premier réflexe est « la plateforme de livraison a cassé » ou « le token du bot a expiré », donc vous épluchez les logs Telegram et gateway alors que la vraie modification dort dans
jobs.json.
Le correctif est étroit : appliquer la résolution de contexte cron uniquement à la création, et conserver l’origin littéral lors de la mise à jour. Un patch communautaire et un test de non-régression existent (le nouveau test échoue sur main et passe avec le patch), mais ils ne sont pas encore fusionnés. En attendant, les trois vérifications ci-dessus restent le mieux que vous puissiez faire.
Un dernier point sur la livraison cron
deliver et failure_deliver sont deux champs distincts — le second indique où vont les échecs, et il partage le chemin de résolution du premier. Ce bug réécrit donc les deux. Si vous aviez configuré « les succès au groupe, les échecs en privé pour moi », vérifiez les deux colonnes.
Cron offre bien plus de réglages qu’on ne le croit : un job peut livrer via son propre bot (voir donner à un job cron son propre bot), conserver une mémoire d’une exécution à l’autre (voir la continuité mémoire du cron), et être contrôlé avec cron doctor (voir le guide de cron doctor). La liste complète des sous-commandes se trouve dans la référence de la commande cron.
S’il ne fallait retenir qu’une phrase : origin est relatif au moment de la création, et tout ce qui le « re-résout » plus tard peut casser une adresse qui était déjà juste.