Un cron job reescribió su propio destino de entrega y los informes dejaron de llegar
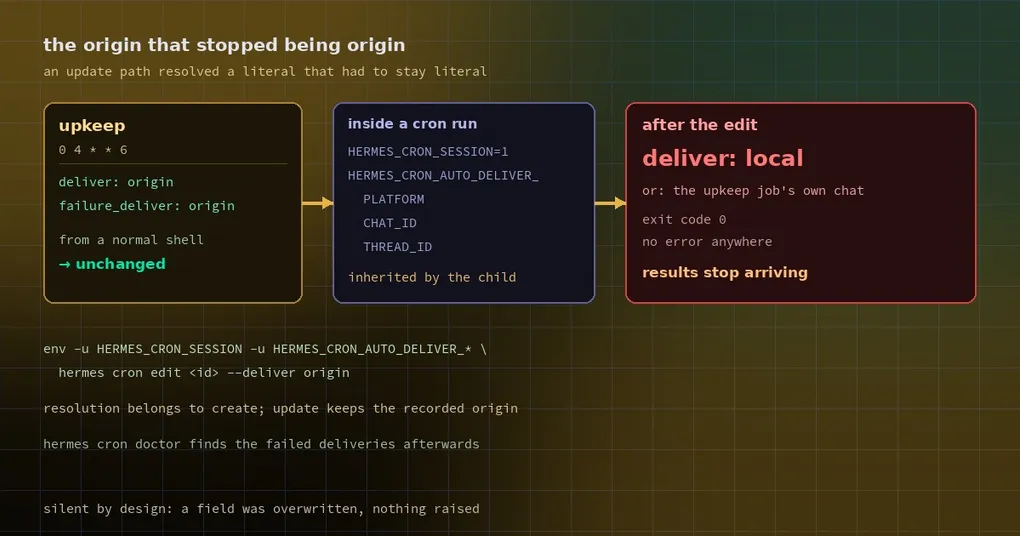
Tu tabla de cron tiene 19 jobs. Uno se llama upkeep y cada sábado a las 4 de la mañana hace «limpieza». Nada del otro mundo: recorre todos los jobs y refresca el prompt y la configuración de entrega de unos cuantos hermanos a partir de una plantilla, incluida la línea
hermes cron edit <upkeep-id> --deliver originque se lee como «devuelve los resultados al chat donde me crearon». La primera semana fue bien. En la segunda, el informe del sábado no llegó. En la tercera tampoco. hermes cron list muestra el campo deliver de ese job como local: ningún error, ninguna advertencia, simplemente pasó de «entregar a mí» a «no entregar a ninguna parte».
Qué significa realmente origin
La semántica importa, porque el bug vive dentro de ella. El deliver de un cron job puede nombrar un destino concreto (telegram:<chat_id>, slack, local, all), o puede ser origin: el chat en el que se creó el job.
origin es una expresión relativa al momento de creación. Cuando se crea el job, Hermes guarda la dirección de la conversación en ese instante; todas las ejecuciones posteriores entregan ahí. Si en el momento de la creación no había una fuente usable (un job creado por un script, o sobre la plataforma api_server de petición/respuesta, que no puede recibir entregas), entra en juego el fallback a home channel.
La documentación oficial deja el diseño claro, en la sección sobre cómo gestionar cron desde dentro de una ejecución de cron:
Sin entregas colgando. Una ejecución de cron es efímera, así que
deliver: origindesde dentro de una de ellas se resuelve en el momento de creación al destino concreto del job creador (platform:chat_id[:thread_id], olocalsi el job creador no entrega a ninguna parte).
Fíjate en esas tres palabras: en el momento de creación. El escenario documentado es crear un job nuevo desde dentro de una ejecución de cron: un job recién nacido no debe apuntar a una sesión efímera que va a desaparecer, así que origin se resuelve en el instante en que se crea.
Actualizar un job existente es un caso completamente distinto. El job ya existe, su origin se registró hace mucho y origin sigue siendo significativo y estable para él. Volver a resolverlo en ese punto no arregla nada: corrompe un valor que ya era correcto.
Qué hace el código
_update_core_fields en tools/cronjob_tools.py pasa tanto deliver como failure_deliver por el mismo resolver en la ruta de actualización:
if deliver is not None:
    ...
    updates["deliver"] = _resolve_cron_context_deliver(_normalize_deliver_param(deliver))
if a["failure_deliver"] is not None:
    ...
    _norm_fd = _resolve_cron_context_deliver(_norm_fd)
    updates["failure_deliver"] = _norm_fd
Y el docstring de ese resolver declara su alcance (tools/cronjob_job_args.py):
def _resolve_cron_context_deliver(deliver: Optional[str]) -> Optional[str]:
    """Resolve ``origin`` to a concrete target for creates made FROM a cron run (the creating
    session is ephemeral, so by fire time there is no origin). Non-cron sessions: unchanged.
    Cron sessions: ``origin`` (or omitted) becomes the creating run's ``platform:chat_id[:thread]``
    from HERMES_CRON_AUTO_DELIVER_*, or ``local`` when it has no concrete target; other
    elements pass through. Otherwise the scheduler would guess a home channel."""
«For creates made FROM a cron run». La primera línea del cuerpo dice lo mismo:
if not is_truthy_value(get_session_env("HERMES_CRON_SESSION", "")):
    return deliver
Fuera de una ejecución de cron devuelve el valor tal cual. Dentro de una, origin (y None) se convierten en la dirección concreta del creador, montada a partir de HERMES_CRON_AUTO_DELIVER_PLATFORM / _CHAT_ID / _THREAD_ID; si no hay destino concreto, degrada a local.
El problema es que el scheduler define esas tres variables para el job que se está ejecutando en ese momento (cron/scheduler.py asigna HERMES_CRON_AUTO_DELIVER_* y las marca como heredables por los subprocesos). Así que cuando llamas a hermes cron edit desde dentro de una ejecución de cron, el proceso hijo lleva el destino de entrega del job en ejecución. Un comando que debía significar «quédate con tu propio origin» pasa a significar «cámbiate a mi chat»; y si el job de mantenimiento entrega a local, el resultado es local.
No lo vas a ver pasar. updates["deliver"] simplemente se sobrescribe, el comando sale con código 0 y una columna de hermes cron list ha cambiado sin hacer ruido.
Tres comprobaciones que hacer
Uno: lista los jobs con origin y confirma que siguen diciendo origin.
hermes cron listSi encuentras local entre jobs que nunca tocaste, esto es lo que pasó.
Dos: pasa el chequeo de salud de las entregas.
hermes cron doctorEs una revisión de flota de solo lectura: ejecuciones fallidas, entregas fallidas, next_run_at vencido o ausente, scripts o workdirs que faltan, y sale con código distinto de cero cuando encuentra problemas. No te va a decir «origin se reescribió a local», pero «este job está configurado para entregar y falla una y otra vez» suele salir a la superficie aquí.
Tres: no edites la entrega desde dentro de una ejecución de cron.
Este es el workaround directo. Un job de mantenimiento puede cambiar prompts, horarios y nombres con seguridad a través de la herramienta cronjob; el campo de entrega lo debería cambiar una persona, o escribirse como destino explícito en lugar de origin.
Si de verdad necesitas hacer esa edición desde dentro de una ejecución de cron, quita las variables alrededor de la llamada al CLI:
env -u HERMES_CRON_SESSION \
    -u HERMES_CRON_AUTO_DELIVER_PLATFORM \
    -u HERMES_CRON_AUTO_DELIVER_CHAT_ID \
    -u HERMES_CRON_AUTO_DELIVER_THREAD_ID \
    hermes cron edit <id> --deliver origin
El mecanismo se sigue fácil: fuera de una «sesión de cron» el resolver devuelve su entrada en la primera línea, origin se queda literal, y un origin literal es válido para un job existente —tiene un origin registrado, más un fallback a home channel cuando no lo tiene—.
Por qué este bug es tan difícil de detectar
Se apilan tres rasgos silenciosos:
- No hay error. El camino de éxito es sobrescribir un campo y salir con código 0.
- Exposición diferida. La ejecución de mantenimiento en sí parece correcta; el daño solo aparece cuando el siguiente job hermano se dispara y no hay ninguna salida, normalmente días después.
- Síntomas engañosos. Tu primer instinto es «se rompió la plataforma de entrega» o «caducó el token del bot», así que te vas a leer los logs de Telegram y del gateway mientras el cambio real está sentado en
jobs.json.
El arreglo es acotado: aplicar la resolución de contexto de cron solo en la creación y mantener el origin literal en la actualización. Existe un patch de la comunidad y su test de regresión (el test nuevo falla en main y pasa con el patch), pero todavía no se ha mergeado. Mientras no lo esté, las tres comprobaciones de arriba son lo mejor que puedes hacer.
Una cosa más sobre la entrega de cron
deliver y failure_deliver son dos campos separados: el segundo dice adónde van los fallos y comparte la ruta de resolución del primero. Así que este bug reescribe los dos. Si tenías configurado «éxitos al grupo, fallos a mí en privado», revisa las dos columnas.
Cron tiene más mandos de los que la mayoría supone: un job puede entregar a través de su propio bot (ver darle a un cron job su propio bot), llevar memoria entre ejecuciones (ver continuidad de memoria en cron) y comprobarse con cron doctor (ver la guía de cron doctor). La lista completa de subcomandos está en la referencia del comando cron.
Si te quedas con una sola línea: origin es relativo al momento de creación, y cualquier cosa que lo «vuelva a resolver» después puede romper una dirección que ya estaba bien.