Ein Cron-Job schrieb sein eigenes Zustellziel um – und die Berichte blieben aus
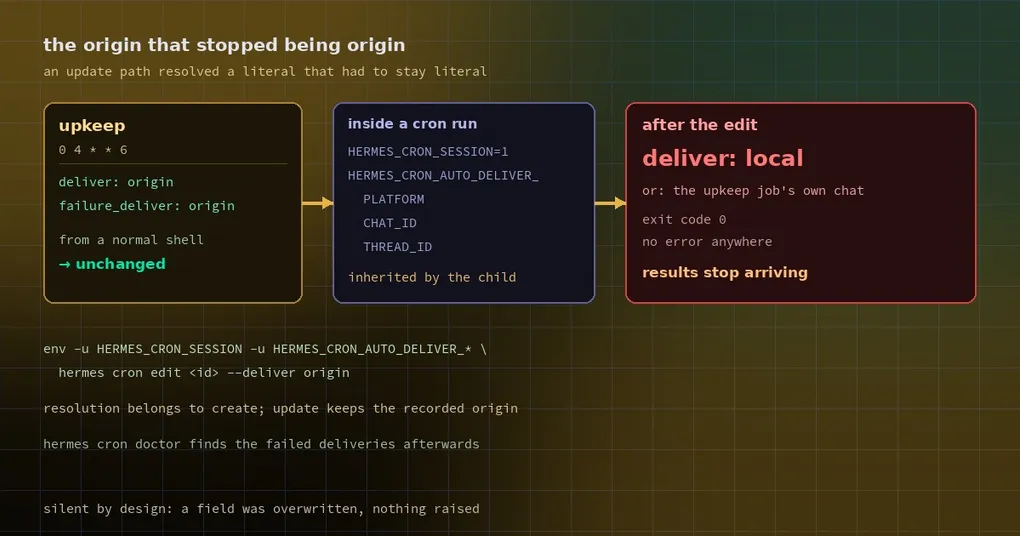
Deine Cron-Tabelle hat 19 Jobs. Einer heißt upkeep und räumt jeden Samstag um 4 Uhr morgens auf. Er macht etwas Schlichtes: alle Jobs auflisten, die Prompts und Zustelleinstellungen einiger Nachbarjobs aus einer Vorlage auffrischen – darunter die Zeile
hermes cron edit <upkeep-id> --deliver originwas so viel heißt wie: „schick die Ergebnisse zurück in den Chat, in dem ich angelegt wurde“. Woche eins lief sauber. In Woche zwei kam der Samstagsbericht nicht an. In Woche drei auch nicht. hermes cron list zeigt das deliver-Feld dieses Jobs als local – kein Fehler, keine Warnung, es ging einfach von „an mich zustellen“ zu „nirgendwohin zustellen“.
Was origin tatsächlich bedeutet
Die Semantik ist hier entscheidend, denn der Bug steckt mitten darin. Das deliver eines Cron-Jobs kann ein konkretes Ziel benennen (telegram:<chat_id>, slack, local, all) oder eben origin sein – der Chat, in dem der Job angelegt wurde.
origin ist ein Ausdruck relativ zum Erstellungszeitpunkt. Beim Anlegen des Jobs notiert Hermes die Gesprächsadresse von genau diesem Moment; jeder spätere Lauf stellt dorthin zu. Gab es zum Erstellungszeitpunkt keine brauchbare Quelle (ein Job aus einem Skript, oder auf der Request/Response-Plattform api_server, die keine Zustellungen empfangen kann), springt ein Home-Channel-Fallback ein.
Die offizielle Doku sagt das im Abschnitt über das Verwalten von Cron aus einem Cron-Lauf heraus ganz klar:
Keine hängende Zustellung. Ein Cron-Lauf ist flüchtig, deshalb wird
deliver: originaus einem Lauf heraus zum Erstellungszeitpunkt auf das konkrete Ziel des erzeugenden Jobs aufgelöst (platform:chat_id[:thread_id], oderlocal, wenn der erzeugende Job nirgendwohin zustellt).
Beachte diese drei Wörter: at create time. Das dokumentierte Szenario ist das Anlegen eines neuen Jobs aus einem Cron-Lauf heraus – ein brandneuer Job darf nicht auf eine flüchtige Session zeigen, die verschwindet, also wird origin in dem Moment aufgelöst, in dem er entsteht.
Einen bestehenden Job zu aktualisieren ist eine völlig andere Situation. Der Job existiert bereits, sein Origin wurde vor langer Zeit festgehalten, und origin ist für ihn sinnvoll und stabil. Ihn an dieser Stelle erneut aufzulösen repariert nichts – es beschädigt einen Wert, der schon korrekt war.
Was der Code tut
_update_core_fields in tools/cronjob_tools.py schickt auf dem Update-Pfad sowohl deliver als auch failure_deliver durch denselben Resolver:
if deliver is not None:
    ...
    updates["deliver"] = _resolve_cron_context_deliver(_normalize_deliver_param(deliver))
if a["failure_deliver"] is not None:
    ...
    _norm_fd = _resolve_cron_context_deliver(_norm_fd)
    updates["failure_deliver"] = _norm_fd
Und der Docstring dieses Resolvers benennt seinen Geltungsbereich selbst (tools/cronjob_job_args.py):
def _resolve_cron_context_deliver(deliver: Optional[str]) -> Optional[str]:
    """Resolve ``origin`` to a concrete target for creates made FROM a cron run (the creating
    session is ephemeral, so by fire time there is no origin). Non-cron sessions: unchanged.
    Cron sessions: ``origin`` (or omitted) becomes the creating run's ``platform:chat_id[:thread]``
    from HERMES_CRON_AUTO_DELIVER_*, or ``local`` when it has no concrete target; other
    elements pass through. Otherwise the scheduler would guess a home channel."""
„For creates made FROM a cron run“ – der erste Satz im Funktionsrumpf sagt genau dasselbe:
if not is_truthy_value(get_session_env("HERMES_CRON_SESSION", "")):
    return deliver
Außerhalb eines Cron-Laufs kommt der Wert unverändert zurück. Innerhalb eines Laufs werden origin (und None) zur konkreten Adresse des Erzeugers, zusammengesetzt aus HERMES_CRON_AUTO_DELIVER_PLATFORM / _CHAT_ID / _THREAD_ID; ohne konkretes Ziel fällt der Wert auf local zurück.
Das Problem: Der Scheduler setzt diese drei Variablen für den Job, der gerade läuft (cron/scheduler.py belegt HERMES_CRON_AUTO_DELIVER_* und markiert sie als an Subprozesse vererbbar). Wenn du also hermes cron edit aus einem Cron-Lauf heraus aufrufst, trägt der Kindprozess das Zustellziel des laufenden Jobs mit sich. Ein Befehl, der „behalte dein eigenes Origin“ bedeuten sollte, wird zu „werde stattdessen mein Chat“ – und wenn der Wartungsjob selbst auf local zustellt, ist das Ergebnis local.
Du wirst es nicht bemerken. updates["deliver"] wird einfach überschrieben, der Befehl endet mit Exit-Code 0, und eine Spalte in hermes cron list hat sich still verändert.
Drei Checks, die du laufen lassen solltest
Erstens: die origin-Jobs auflisten und prüfen, ob dort noch origin steht.
hermes cron listWenn du bei Jobs, die du nie angefasst hast, auf local stößt, dann ist genau das passiert.
Zweitens: den Zustell-Health-Check laufen lassen.
hermes cron doctorDas ist eine reine Lese-Prüfung über die ganze Flotte: fehlgeschlagene Läufe, fehlgeschlagene Zustellungen, überfällige oder fehlende next_run_at, fehlende Skripte oder Workdirs – mit Exit-Code ungleich null, wenn er Probleme findet. Er wird dir nicht sagen „origin wurde auf local umgeschrieben“, aber „dieser Job ist auf Zustellung konfiguriert und scheitert dauernd“ taucht hier meist auf.
Drittens: die Zustellung nicht aus einem Cron-Lauf heraus bearbeiten.
Das ist der direkte Workaround. Ein Wartungsjob kann Prompts, Zeitpläne und Namen gefahrlos über das cronjob-Tool ändern; das Zustellfeld sollte ein Mensch anfassen – oder als explizites Ziel statt origin geschrieben werden.
Wenn du diesen Edit wirklich aus einem Cron-Lauf heraus brauchst, nimm die Variablen um den CLI-Aufruf herum weg:
env -u HERMES_CRON_SESSION \
    -u HERMES_CRON_AUTO_DELIVER_PLATFORM \
    -u HERMES_CRON_AUTO_DELIVER_CHAT_ID \
    -u HERMES_CRON_AUTO_DELIVER_THREAD_ID \
    hermes cron edit <id> --deliver origin
Der Mechanismus ist leicht nachzuvollziehen: Außerhalb einer „cron session“ gibt der Resolver in der ersten Zeile einfach seine Eingabe zurück, origin bleibt literal, und ein literales origin ist für einen bestehenden Job gültig – er hat ein festgehaltenes Origin, plus einen Home-Channel-Fallback, falls nicht.
Warum dieser Bug ungewöhnlich schwer zu entdecken ist
Drei stille Eigenschaften kommen zusammen:
- Kein Fehler. Der Erfolgspfad ist ein Feld-Overwrite und Exit-Code 0.
- Verzögerte Wirkung. Der Wartungslauf selbst sieht sauber aus; der Schaden zeigt sich erst, wenn der nächste Nachbarjob feuert und keine Ausgabe erscheint – meist Tage später.
- Irreführende Symptome. Der erste Instinkt ist „die Zustellplattform ist kaputt“ oder „der Bot-Token ist abgelaufen“, also liest du Telegram- und Gateway-Logs, während die eigentliche Änderung in
jobs.jsonsteht.
Der Fix ist eng umrissen: die Cron-Context-Auflösung nur beim Anlegen anwenden, und beim Update das literale origin erhalten. Es gibt einen Community-Patch samt Regressionstest (der neue Test scheitert auf main und läuft mit dem Patch durch), aber er ist noch nicht gemergt. Bis dahin sind die drei Checks oben das Beste, was du tun kannst.
Noch eine Sache zur Cron-Zustellung
deliver und failure_deliver sind zwei getrennte Felder – das zweite sagt, wohin Fehler gehen, und es teilt sich den Auflösungspfad mit dem ersten. Dieser Bug schreibt also beide um. Wenn du „Erfolg in die Gruppe, Fehler privat an mich“ konfiguriert hattest, prüfe beide Spalten.
Cron hat mehr Stellschrauben, als die meisten annehmen: Ein Job kann über seinen eigenen Bot zustellen (siehe einem Cron-Job einen eigenen Bot geben), Gedächtnis über Läufe hinweg mitführen (siehe Cron-Memory-Kontinuität) und mit cron doctor geprüft werden (siehe der Cron-Doctor-Leitfaden). Die vollständige Liste der Subcommands steht in der Cron-Command-Referenz.
Wenn du dir nur einen Satz merkst: origin ist relativ zum Erstellungszeitpunkt, und alles, was ihn später „neu auflöst“, kann eine Adresse kaputt machen, die längst richtig war.