El modelo ya no olvida lo que pensó: el razonamiento se reproduce entre turnos, recargas y compactación
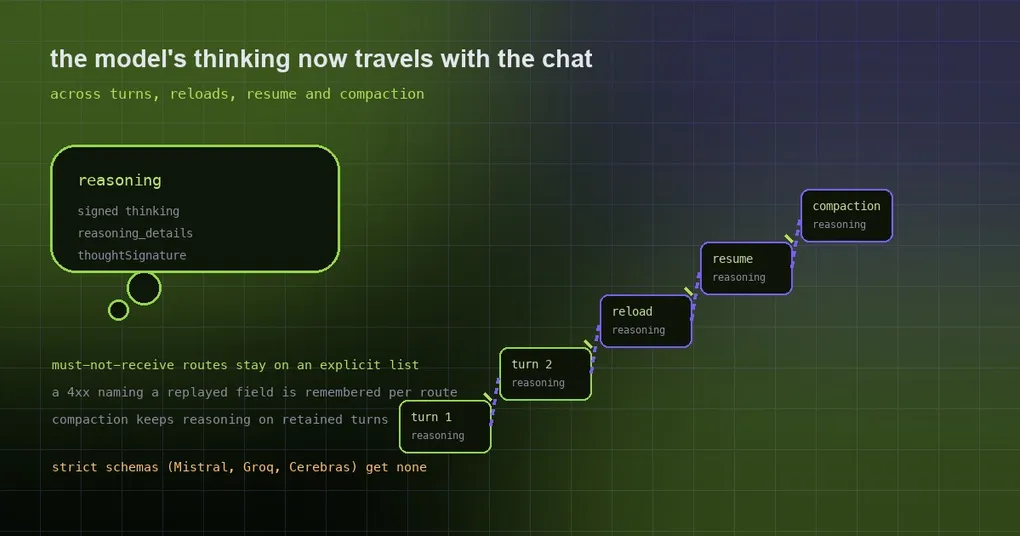
Te ha pasado: una sesión de depuración corre durante media hora, la retomas con --resume y el modelo se comporta como si te acabara de conocer. Las conclusiones a las que ya había llegado, las dos direcciones que acababa de descartar: desaparecidas. Le explicas el contexto de nuevo desde cero. Peor aún, preguntas por tercera vez lo mismo sobre el mismo error y obtienes un diagnóstico distinto cada vez.
La mayoría lo achaca a que el modelo tiene mala memoria. Una causa muy concreta es que Hermes no estaba devolviendo todo lo que el modelo había pensado. El contenido de razonamiento tiene que reenviarse de vuelta en el siguiente turno en muchos providers, y Hermes solo lo hacía en un puñado de rutas. En todas las demás se descartaba en el momento en que salía del modelo, y la compactación y el branching de sesión borraban activamente el razonamiento de turnos anteriores.
Los cambios fusionados en la ventana actual convierten el replay de excepción en comportamiento por defecto.
Por qué el razonamiento tiene que viajar con la conversación
Primero la versión en lenguaje llano, para que el resto no sea todo jerga. Un modelo de razonamiento produce un bloque de «thinking» antes de responder. Puede ser texto legible, o un blob cifrado o firmado; los providers los llaman de formas distintas: reasoning_content, reasoning_details, un bloque de thinking firmado, el thoughtSignature de Gemini, etc.
Tres propiedades importan:
- Algunos providers lo tratan como parte del historial de la conversación: deja fuera el thinking del turno anterior en la siguiente petición y la calidad cae de forma notable, o la petición falla con un 400 en cuanto hay llamadas a herramientas de por medio.
- Algunos providers lo cifran o firman, así que solo funciona cuando se reenvía palabra por palabra: reconstruirlo tú mismo no produce nada útil.
- Algunos providers aplican un esquema de petición estricto donde un campo de más es un error duro, así que en esas rutas no debes enviar ni un byte más.
Por eso el replay nunca fue «simplemente incluirlo todo». Es despacho por ruta: cada ruta sabe qué lee y qué no se le debe enviar jamás.
Cómo se comportaba antes
Antes de este cambio, el comportamiento se describía mejor como «unas cuantas rutas estaban resueltas»:
reasoning_contentsolo volvía a DeepSeek, Kimi, MiMo y Ollama Cloud.reasoning_detailssolo volvía a openrouter.ai.- El thinking firmado de Claude se descartaba en Bedrock, Vertex y Foundry.
- El
thoughtSignaturede los turnos de texto de Gemini no se capturaba nunca. - La compactación eliminaba el razonamiento de turnos anteriores del historial canónico.
El resultado son las dos experiencias de arriba: un modelo que vuelve a adivinar tras --resume, y una sesión cuya calidad se desploma justo después de la compactación.
Cómo funciona ahora: una tabla de rutas más un registro portador privado
Una tabla de rutas. Cada ruta ahora mapea a los campos portadores que puede leer (_REASONING_CARRIER_ROUTES en message_sanitization):
| Ruta | Campos que recibe |
|---|---|
| OpenRouter, Kilo, Vercel AI Gateway, Nous Portal | los tres: reasoning_content, reasoning, reasoning_details (bloques firmados y cifrados palabra por palabra) |
| Novita, MiniMax, Tencent | reasoning_content + reasoning_details |
| Servidores locales | reasoning_content + reasoning |
| Todo lo demás | reasoning_content |
| Esquemas estrictos (Mistral, Groq, Cerebras, SambaNova, Hunyuan) | ninguno |
| Nivel must-echo (DeepSeek, Kimi, MiMo y compañía) | solo un marcador " ", para evitar el 400 en turnos con herramientas sin razonamiento almacenado; no es razonamiento en sí |
Los flags de keep-thinking de los proveedores también van incluidos: el clear_thinking: false de GLM, el preserve_thinking de DashScope, el keep: "all" de Kimi.
Un registro portador privado. Campos como el thoughtSignature de Gemini y reasoning_text / reasoning_opaque / thought_signature de Copilot no encajan en la forma estándar: no había dónde ponerlos. Ahora se guardan como un registro privado hermes.native_assistant (implementado en agent/reasoning_carriers.py, con StreamCarriers acumulándolos a partir de los deltas en streaming), y solo su propia ruta recibe ese registro. Otras rutas nunca ven el campo, así que nunca obtienen un 400 por él. Como el registro vive en la sesión, sobrevive a los turnos del gateway y a --resume.
Bedrock Converse tiene su propio manejo. Solicita thinking para Claude y mantiene una política de replay por modelo (firmado / recorte / sin firma), y almacena el razonamiento como reasoning_details con forma de Anthropic para que un turno recargado desde state.db también se reproduzca. Esa es precisamente la línea del cuerpo del release v0.21.7: el thinking firmado se reproduce después de hermes chat --resume y en el siguiente turno del gateway.
Cuando una ruta se niega: regístralo y reintenta una vez
Incluso una tabla de rutas cuidadosa se queda obsoleta: lo que un provider acepta hoy puede rechazarlo mañana. Por eso hay un fallback:
Cuando una petición devuelve un 4xx cuyo mensaje nombra un campo reproducido (solo cuenta la frase de campo desconocido), Hermes registra ese veredicto por (provider, host, model), lo persiste en la config de modelo de la sesión para que --resume conserve la memoria, y luego reintenta una vez sin ese campo.
Tres restricciones evitan que esto se vuelva un lastre:
- El nivel must-echo nunca puede registrar
reasoning_content, porque ese campo es obligatorio. - El historial nunca se muta: el campo solo se omite de la petición.
- Reintenta exactamente una vez, así que no puede entrar en bucle ante un fallo.
La compactación y el branching dejan de comerse el razonamiento
La otra mitad es la retención:
- La compactación (
compress()y la pasada de salvamento) ya no elimina texto de razonamiento ni elementos cifrados de los turnos retenidos. Solo se descartan los checkpoints eclipsados por uno más nuevo. - El
/branchde la CLI copiareasoning_content, así que una rama nueva lleva su propio historial. - La estimación de preflight y el recorrido de cola de la compactación valoran los portadores opacos de forma idéntica, así que la compactación no entra en bucle intentando contarlos.
Qué cambia para ti
- Una sesión reanudada se comporta como la sesión que dejaste. Las sesiones largas de depuración retomadas con
--resume, o continuadas a lo largo de turnos del gateway, conservan las conclusiones a las que ya habían llegado. - La compactación mantiene la calidad más estable. Tras comprimir el contexto, el modelo sigue viendo su propio thinking anterior en lugar de solo las conclusiones.
- Usuarios de Claude en Bedrock, Vertex y Foundry. El thinking firmado ya no se descarta, y las sesiones reanudadas ya no se rechazan en bloque.
- Usuarios de Gemini y Copilot. Firmas y campos opacos que antes no se capturaban ahora viajan con la conversación.
Dónde mirar cuando se porta mal
# ¿la sesión lleva un registro portador?
hermes sessions show <session-id> | head -40

# observa qué campos de razonamiento lleva una petición (logging de debug)
hermes logs --follow | grep -i reasoning

# dónde vive el estado de sesión, para confirmar que el razonamiento se guarda por turno
ls -l "$HERMES_HOME/state.db"
Si ves que una ruta registra un rechazo por campo desconocido y luego reintenta, es el fallback haciendo su trabajo: normalmente se recupera en el siguiente turno. Si una ruta sigue fallando de la misma manera, vale la pena abrir un issue: la tabla de rutas necesita actualizarse.
Para las demás palancas del razonamiento, consulta nuestra guía de reasoning effort. El lado operativo de reanudar está en la guía de resume de sesiones, y el contexto sobre la compactación está en la guía del tail lean de compresión.