O modelo não esquece mais o que pensou: o raciocínio é reproduzido entre turnos, recarregamentos e compactação
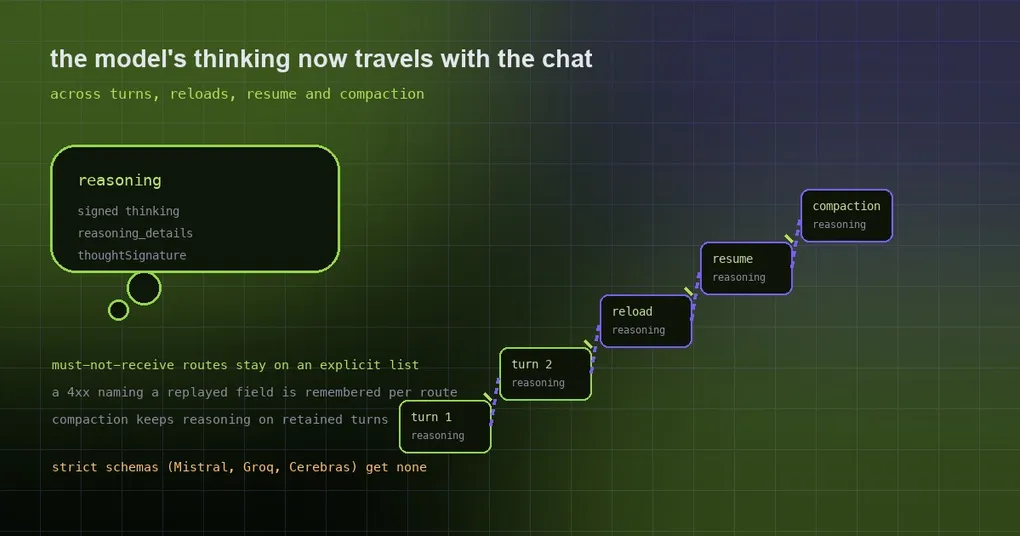
Você já viu isso: uma sessão de debugging roda por meia hora, você a retoma com --resume e o modelo age como se estivesse te conhecendo agora. As conclusões a que ele já tinha chegado, as duas direções que ele tinha acabado de descartar — sumiram. Você explica o contexto de novo do zero. Pior ainda, você faz a mesma pergunta sobre o mesmo erro pela terceira vez e recebe um diagnóstico diferente a cada vez.
A maioria das pessoas atribui isso à memória ruim do modelo. Uma causa bem concreta é que o Hermes não estava trazendo de volta tudo o que o modelo tinha pensado. O conteúdo de raciocínio precisa ser ecoado no próximo turno em muitos providers, e o Hermes só fazia isso para um punhado de rotas. Em todo o resto, ele era descartado no momento em que saía do modelo, e a compactação e o branching de sessão apagavam ativamente o raciocínio de turnos anteriores.
Mudanças mescladas na janela atual transformam o replay de exceção em padrão.
Por que o raciocínio precisa viajar com a conversa
Primeiro a versão em linguagem simples, para que o resto não seja só jargão. Um modelo de raciocínio produz um bloco de “pensamento” antes de responder. Ele pode ser texto legível, ou um blob criptografado ou assinado — os providers dão nomes diferentes a isso: reasoning_content, reasoning_details, um bloco de thinking assinado, o thoughtSignature do Gemini, e assim por diante.
Três propriedades importam:
- Alguns providers tratam isso como parte do histórico da conversa: deixe o thinking do turno anterior fora da próxima requisição e a qualidade cai visivelmente, ou a requisição falha com um 400 quando há tool calls envolvidas.
- Alguns providers criptografam ou assinam isso, então só funciona quando ecoado de volta na íntegra — reconstruí-lo por conta própria não produz nada útil.
- Alguns providers rodam um schema de requisição estrito em que um campo a mais é erro fatal, então para essas rotas você não pode enviar um byte além.
É por isso que o replay nunca foi “simplesmente incluir tudo”. É dispatch por rota: cada rota sabe o que lê e o que nunca pode receber.
Como se comportava antes
Antes dessa mudança, o comportamento se descrevia melhor como “algumas rotas eram cuidadas”:
reasoning_contentsó voltava para DeepSeek, Kimi, MiMo e Ollama Cloud.reasoning_detailssó voltava para openrouter.ai.- O thinking assinado do Claude era descartado no Bedrock, no Vertex e no Foundry.
- O
thoughtSignaturede turno de texto do Gemini nunca era capturado. - A compactação removia o raciocínio de turnos anteriores do histórico canônico.
O resultado são as duas experiências acima: um modelo que chuta de novo depois de --resume e uma sessão cuja qualidade cai de um penhasco logo depois da compactação.
Como funciona agora: uma tabela de rotas mais um registro privado de carrier
Uma tabela de rotas. Cada rota agora mapeia os campos de carrier que consegue ler (_REASONING_CARRIER_ROUTES em message_sanitization):
| Rota | Campos que recebe |
|---|---|
| OpenRouter, Kilo, Vercel AI Gateway, Nous Portal | todos os três: reasoning_content, reasoning, reasoning_details (blocos assinados e criptografados na íntegra) |
| Novita, MiniMax, Tencent | reasoning_content + reasoning_details |
| Servidores locais | reasoning_content + reasoning |
| Todo o resto | reasoning_content |
| Schemas estritos (Mistral, Groq, Cerebras, SambaNova, Hunyuan) | nenhum |
| Camada must-echo (DeepSeek, Kimi, MiMo e afins) | apenas um placeholder " ", para evitar o 400 em turnos com tools sem raciocínio armazenado — não é raciocínio em si |
As flags de keep-thinking dos fornecedores vêm junto: clear_thinking: false do GLM, preserve_thinking do DashScope, keep: "all" do Kimi.
Um registro privado de carrier. Campos como o thoughtSignature do Gemini e reasoning_text / reasoning_opaque / thought_signature do Copilot não pertencem ao formato padrão — não havia onde colocá-los. Eles agora são armazenados como um registro privado hermes.native_assistant (implementado em agent/reasoning_carriers.py, com StreamCarriers acumulando-os a partir dos deltas do stream), e apenas a própria rota deles recebe esse registro. Outras rotas nunca veem o campo, então nunca recebem um 400 por causa dele. Como o registro vive na sessão, ele sobrevive a turnos do gateway e ao --resume.
O Bedrock Converse tem tratamento próprio. Ele pede thinking para o Claude e mantém uma política de replay por modelo (assinado / removido / não assinado), e armazena o raciocínio como reasoning_details no formato do Anthropic, para que um turno recarregado de state.db também seja reproduzido. É exatamente essa a linha do corpo da release v0.21.7: o thinking assinado é reproduzido depois de hermes chat --resume e no próximo turno do gateway.
Quando uma rota recusa: registre e tente uma vez
Mesmo uma tabela de rotas cuidadosa fica desatualizada — o que um provider aceita hoje pode rejeitar amanhã. Por isso existe um fallback:
Quando uma requisição retorna um 4xx cuja mensagem nomeia um campo reproduzido (só a formulação de campo desconhecido conta), o Hermes registra esse veredito por (provider, host, model), persiste isso na config de modelo da sessão para que o --resume mantenha a memória, e então tenta uma vez sem esse campo.
Três restrições impedem que isso vire um problema:
- A camada must-echo nunca pode registrar
reasoning_content, porque esse campo é obrigatório. - O histórico nunca é alterado — o campo só é omitido da requisição.
- Ele tenta exatamente uma vez, então não pode entrar em loop em cima de uma falha.
Compactação e branching param de comer o raciocínio
A outra metade é a retenção:
- A compactação (
compress()e a passagem de salvage) não remove mais texto de raciocínio nem itens criptografados dos turnos retidos. Só checkpoints ofuscados por um mais novo são descartados. - O
/branchda CLI copiareasoning_content, então um novo branch carrega o seu próprio histórico. - A estimativa de preflight e a varredura de tail da compactação precificam carriers opacos de forma idêntica, então a compactação não entra em loop tentando contabilizá-los.
O que muda para você
- Uma sessão retomada se comporta como a sessão que você deixou. Sessões longas de debugging retomadas com
--resume, ou continuadas entre turnos do gateway, mantêm as conclusões a que já tinham chegado. - A compactação mantém a qualidade mais estável. Depois que o contexto é comprimido, o modelo ainda vê o seu próprio raciocínio anterior em vez de apenas as conclusões.
- Usuários do Claude no Bedrock, no Vertex e no Foundry. O thinking assinado não é mais descartado, e sessões retomadas não são mais rejeitadas por completo.
- Usuários do Gemini e do Copilot. Assinaturas e campos opacos que nunca eram capturados antes agora viajam com a conversa.
Onde olhar quando algo se comporta mal
# a sessão carrega um registro de carrier
hermes sessions show <session-id> | head -40

# acompanhe quais campos de raciocínio uma requisição carrega (log de debug)
hermes logs --follow | grep -i reasoning

# onde vive o estado da sessão, para confirmar que o raciocínio é guardado por turno
ls -l "$HERMES_HOME/state.db"
Se você vir uma rota registrar uma rejeição de campo desconhecido e então tentar de novo, é o fallback fazendo o seu trabalho — normalmente ele se recupera no próximo turno. Se uma rota continua falhando do mesmo jeito, vale abrir uma issue: a tabela de rotas precisa de atualização.
Para os outros ajustes de raciocínio, veja o nosso guia de reasoning effort. O lado operacional do resume está no guia de resume de sessão, e o contexto sobre compactação está no guia de compression lean-tail.