Le modèle n'oublie plus ce qu'il a pensé : le raisonnement est rejoué d'un tour à l'autre, après un rechargement et après compaction
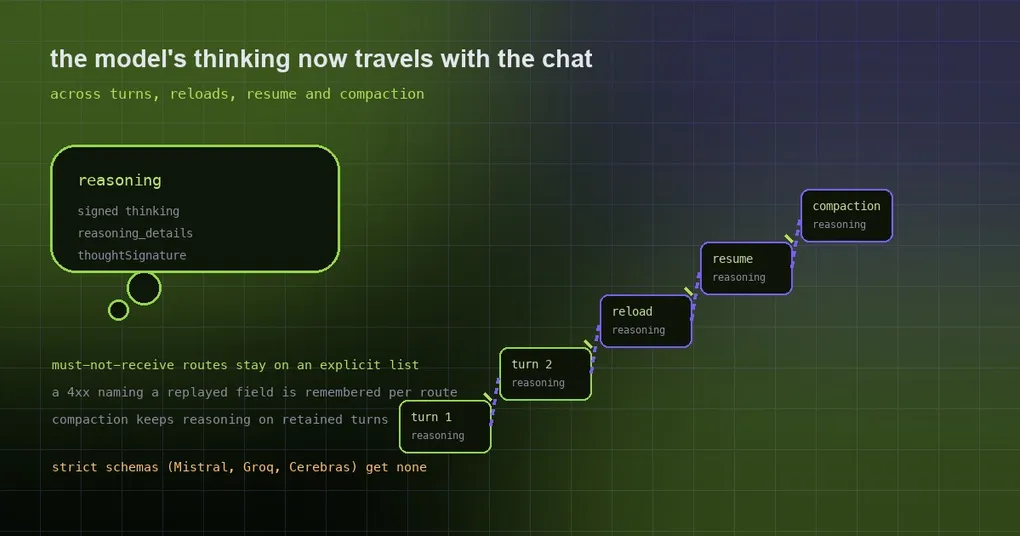
Vous connaissez la scène : une session de débogage tourne pendant une demi-heure, vous la reprenez avec --resume, et le modèle se comporte comme s’il venait de vous rencontrer. Les conclusions auxquelles il était déjà parvenu, les deux pistes qu’il venait d’écarter — envolées. Vous réexpliquez tout le contexte depuis zéro. Pire, vous reposez une troisième fois la même question sur la même erreur et obtenez un diagnostic différent à chaque fois.
La plupart des gens mettent cela sur le compte d’une mauvaise mémoire du modèle. Une cause très concrète est que Hermes ne renvoyait pas tout ce que le modèle avait pensé. Sur de nombreux providers, le contenu de raisonnement doit être réinjecté au tour suivant, et Hermes ne le faisait que pour une poignée de routes. Partout ailleurs, il était jeté dès qu’il quittait le modèle, et la compaction ainsi que le branchement de session supprimaient activement le raisonnement des tours précédents.
Les changements fusionnés dans la fenêtre actuelle font passer le rejeu du statut d’exception à celui de défaut.
Pourquoi le raisonnement doit voyager avec la conversation
D’abord la version en clair, pour que la suite ne soit pas qu’un amas de jargon. Un modèle de raisonnement produit un bloc « réflexion » avant de répondre. Cela peut être du texte lisible, ou un blob chiffré ou signé — les providers les nomment différemment : reasoning_content, reasoning_details, un bloc de réflexion signé, le thoughtSignature de Gemini, etc.
Trois propriétés comptent :
- Certains providers le traitent comme une partie de l’historique de la conversation : omettez la réflexion du tour précédent dans la requête suivante et la qualité chute nettement, ou la requête échoue par un 400 dès que des appels d’outils sont impliqués.
- Certains providers le chiffrent ou le signent, si bien qu’il ne fonctionne que réinjecté mot pour mot — le reconstruire vous-même ne produit rien d’utile.
- Certains providers appliquent un schéma de requête strict où un champ supplémentaire est une erreur dure ; pour ces routes, vous ne devez donc pas envoyer un octet de plus.
Voilà pourquoi le rejeu n’a jamais été « il suffit de tout inclure ». C’est un dispatch par route : chaque route sait ce qu’elle lit et ce qu’il ne faut jamais lui envoyer.
Comment cela se comportait auparavant
Avant ce changement, le comportement se décrivait le mieux comme « quelques routes étaient prises en charge » :
reasoning_contentne revenait qu’à DeepSeek, Kimi, MiMo et Ollama Cloud.reasoning_detailsne revenait qu’à openrouter.ai.- La réflexion signée de Claude était jetée sur Bedrock, Vertex et Foundry.
- Le
thoughtSignaturedes tours texte de Gemini n’était jamais capturé du tout. - La compaction retirait le raisonnement des tours précédents de l’historique canonique.
Le résultat, ce sont les deux expériences ci-dessus : un modèle qui redevine après --resume, et une session dont la qualité chute d’un coup juste après la compaction.
Comment ça marche maintenant : une table de routes et un enregistrement de transport privé
Une seule table de routes. Chaque route correspond désormais aux champs de transport qu’elle peut lire (_REASONING_CARRIER_ROUTES dans message_sanitization) :
| Route | Champs reçus |
|---|---|
| OpenRouter, Kilo, Vercel AI Gateway, Nous Portal | les trois : reasoning_content, reasoning, reasoning_details (blocs signés et chiffrés mot pour mot) |
| Novita, MiniMax, Tencent | reasoning_content + reasoning_details |
| Serveurs locaux | reasoning_content + reasoning |
| Tout le reste | reasoning_content |
| Schémas stricts (Mistral, Groq, Cerebras, SambaNova, Hunyuan) | aucun |
| Palier must-echo (DeepSeek, Kimi, MiMo et compagnie) | un simple placeholder " ", pour empêcher le 400 sur les tours d’outils sans raisonnement stocké — ce n’est pas le raisonnement lui-même |
Les flags de maintien de la réflexion des fournisseurs suivent aussi : clear_thinking: false de GLM, preserve_thinking de DashScope, keep: "all" de Kimi.
Un enregistrement de transport privé. Des champs comme le thoughtSignature de Gemini et reasoning_text / reasoning_opaque / thought_signature de Copilot n’appartiennent pas à la forme standard — il n’y avait nulle part où les mettre. Ils sont désormais stockés comme un enregistrement privé hermes.native_assistant (implémenté dans agent/reasoning_carriers.py, avec StreamCarriers qui les accumule à partir des deltas en streaming), et seule leur propre route reçoit cet enregistrement. Les autres routes ne voient jamais le champ, donc elles ne reçoivent jamais de 400 à cause de lui. Comme l’enregistrement vit dans la session, il survit aux tours de gateway et à --resume.
Bedrock Converse a son propre traitement. Il demande la réflexion pour Claude et conserve une politique de rejeu par modèle (signé / retiré / non signé), et stocke le raisonnement sous forme de reasoning_details au format Anthropic, afin qu’un tour rechargé depuis state.db soit aussi rejoué. C’est précisément la ligne du corps de la release v0.21.7 : la réflexion signée est rejouée après hermes chat --resume et au tour de gateway suivant.
Quand une route refuse : on consigne, on réessaie une fois
Même une table de routes soignée se périme — ce qu’un provider accepte aujourd’hui, il peut le rejeter demain. Il existe donc un fallback :
Quand une requête renvoie un 4xx dont le message nomme un champ rejoué (seule la formulation « champ inconnu » compte), Hermes consigne ce verdict par (provider, host, model), le persiste dans la config de modèle de la session pour que --resume conserve la mémoire, puis réessaie une fois sans ce champ.
Trois contraintes empêchent que cela devienne un fardeau :
- Le palier must-echo ne peut jamais consigner
reasoning_content, car ce champ est requis. - L’historique n’est jamais muté — le champ est seulement omis de la requête.
- Il réessaie exactement une fois, donc il ne peut pas boucler sur un échec.
La compaction et le branchement cessent de manger le raisonnement
L’autre moitié, c’est la rétention :
- La compaction (
compress()et la passe de récupération) ne retire plus le texte de raisonnement ni les éléments chiffrés des tours conservés. Seuls les checkpoints masqués par un plus récent sont supprimés. - Le
/branchdu CLI copiereasoning_content, si bien qu’une nouvelle branche emporte son propre historique. - L’estimation de pré-vol et le parcours de queue de la compaction évaluent les transports opaques de façon identique, donc la compaction ne boucle pas en essayant de les comptabiliser.
Ce que cela change pour vous
- Une session reprise se comporte comme la session que vous avez quittée. Les longues sessions de débogage reprises avec
--resume, ou poursuivies au fil des tours de gateway, conservent les conclusions déjà atteintes. - La compaction garde une qualité plus stable. Après compression du contexte, le modèle voit toujours sa propre réflexion antérieure au lieu des seules conclusions.
- Les utilisateurs de Claude sur Bedrock, Vertex et Foundry. La réflexion signée n’est plus jetée, et les sessions reprises ne sont plus rejetées en bloc.
- Les utilisateurs de Gemini et Copilot. Les signatures et champs opaques qui n’étaient jamais capturés auparavant voyagent désormais avec la conversation.
Où regarder quand ça se comporte mal
# la session porte-t-elle un enregistrement de transport
hermes sessions show <session-id> | head -40

# observer quels champs de raisonnement une requête transporte (journal de débogage)
hermes logs --follow | grep -i reasoning

# où vit l'état de session, pour confirmer que le raisonnement est gardé tour par tour
ls -l "$HERMES_HOME/state.db"
Si vous voyez une route consigner un rejet de champ inconnu puis réessayer, c’est le fallback qui fait son travail — il récupère généralement au tour suivant. Si une route continue d’échouer de la même façon, cela vaut une issue : la table de routes a besoin d’être mise à jour.
Pour les autres réglages de raisonnement, voir notre guide de l’effort de raisonnement. Le volet opérationnel de la reprise est dans le guide du resume de session, et le contexte sur la compaction dans le guide de la queue allégée de compression.