Después de un kill -9 algunos procesos nunca se van: ahora en Hermes cada hijo muere con su padre
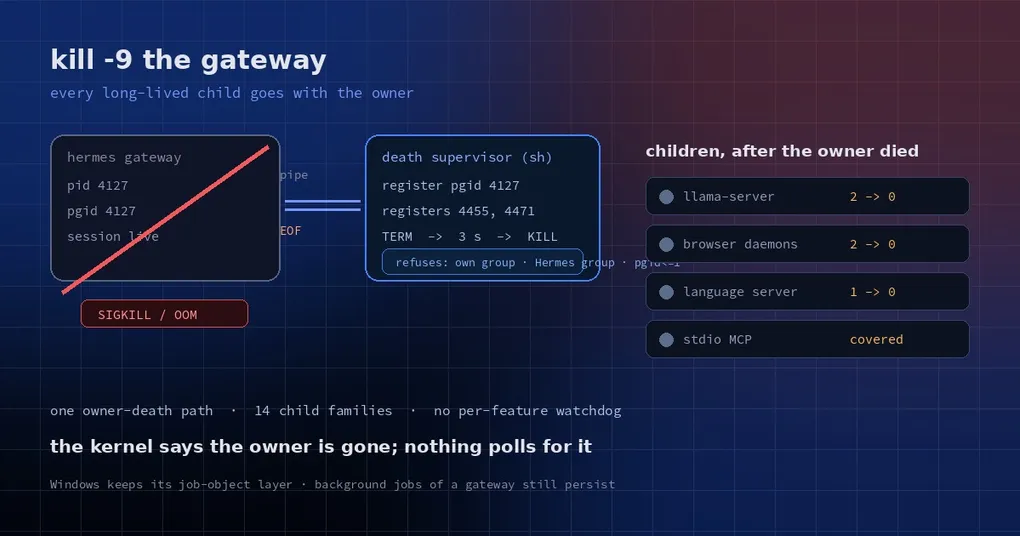
Son las 2 de la mañana, los ventiladores del portátil aúllan y le haces kill -9 al gateway de Hermes que se descontroló. A la mañana siguiente ss -ltnp sigue mostrando el puerto 8080 ocupado, y ps lista un llama-server, dos daemons de navegador y un language server cuyo padre murió hace horas. Ninguno se fue. Los matas uno por uno y te preguntas si mañana vas a repetir el mismo ritual.
Eso no es un error del usuario: así funciona Unix. Cuando un proceso padre muere, sus hijos pasan a depender de init (PID 1) y siguen funcionando. Para un comando de una sola ejecución eso da igual. Para algo como Hermes, que arranca todo un elenco de hijos de larga vida, es un problema real. Un cambio reciente (PR #137057) reemplazó un montón de parches por funcionalidad por un solo mecanismo: cuando muere el dueño, cada hijo de larga vida que arrancó se va con él.
Por qué los hijos “se olvidan” de morir
Casi todo lo que hace un agente genera un proceso: npm run dev, un daemon de automatización de navegador, un router de modelos local, un language server, una celda de ejecución de código, un servidor MCP sobre stdio. Esos procesos deberían vivir exactamente lo que vive el proceso de Hermes que los lanzó. Por defecto no lo hacen: simplemente reciben un padre nuevo.
La factura llega de formas muy concretas: la memoria sube de a poco, los puertos quedan tomados y el siguiente arranque falla, un modelo local sigue quemando GPU después de que la sesión terminó, y un daemon viejo pelea con el nuevo por el mismo pid file. Depurar es peor todavía: ves un proceso python que no reconoces y no tienes idea de quién lo lanzó.
Antes, Hermes parchaba esto familia por familia: un barrido de huérfanos en el siguiente arranque, un poller por dueño, un watchdog del pid del padre, un pipe de muerte, un hook atexit. Ninguno actuaba en el momento en que el dueño moría de verdad; cada uno esperaba al siguiente boot o al siguiente poll, y cada copia arrastraba sus propios bugs.
Un solo pipe te avisa que el dueño ya no está
El diseño nuevo mantiene exactamente un mecanismo. Cada proceso de Hermes sostiene el extremo de escritura de un pipe; un supervisor (un script POSIX sh, de unos 0,5 MB residente en reposo, frente a los 8,1 MB de la versión anterior en Python) sostiene el extremo de lectura. Cuando arranca un hijo, Hermes registra su process group en el supervisor; cuando el hijo termina normalmente, lo desregistra.
El truco es el EOF. En el instante en que el proceso de Hermes desaparece —salida limpia, crash, kill -9, OOM killer, un stop de systemd— el extremo de escritura se cierra y el supervisor lee EOF de inmediato. Eso es el kernel diciéndote que quien tenía el extremo de escritura ya no existe, y no se puede ignorar ni perder. Al recibir EOF, el supervisor manda TERM a cada grupo registrado, espera hasta 3 segundos y después manda KILL.
También rechaza objetivos peligrosos: su propio grupo, el grupo de Hermes y cualquier cosa con pgid 1 o menor. Arranca de forma perezosa en el primer registro y sale tras 30 segundos inactivo, así un comando en primer plano que registra y libera su grupo no deja un /bin/sh colgado en cada ejecución.
Dos detalles de ingeniería salieron directo de fallos en producción. Las escrituras concurrentes del ledger de spawns: tres procesos que arrancaban 15 hijos cada uno solían conservar solo 18 de 45 filas porque el read-modify-write no estaba serializado; ahora toma un file lock entre procesos que espera como máximo 2 segundos, para que un escritor atascado no congele a los demás. El supervisor siendo matado a él mismo: pkill -f hermes se lo lleva por delante, así que se reinicia replicando todos los grupos mientras existan registros; pero un supervisor que termina por sí solo dentro de los 5 segundos posteriores al arranque (una instalación rota) no se reinicia en bucle.
La API es pequeña: spawn_owned() es la única forma de arrancar un hijo de larga vida (lidera su propio process group, lo registra y lo anota en el ledger); own_process_groups() / release_process_groups() adoptan grupos que lanzó otra cosa, como el MCP SDK o un browser harness; release_process_group_once_empty() devuelve un grupo solo cuando ya no queda nada adentro.
14 familias de hijos migradas
Estos son los números del PR. El test de cada fila mata al dueño con kill -9 y cuenta lo que sigue vivo después; cada fila tiene un dueño de control que sigue vivo, para que un arreglo no pueda pasar simplemente matando todo.
| Familia de hijos | Antes (main) | Después |
|---|---|---|
| Servidores MCP sobre stdio | cubiertos por el supervisor MCP anterior | cubiertos por el compartido |
| Router llama-server y modelos | 2 | 0 |
| Daemons del browser harness | 2 (y 4 quedaban tras una salida limpia) | 0 (0) |
| Language servers (descendientes que ignoran el EOF de stdin) | 1 | 0 |
| Subprocesos de code-cell dentro del kernel | 3/3 | 0/3 |
| Worker de slash-commands | 1 | 0 |
| Comando en primer plano del terminal | 2 | 0 |
| Jobs en segundo plano del terminal (en un proceso que no es gateway) | 3 | 0 |
| Bridges de WhatsApp / Raft | 1 / 1 | 0 / 0 |
| Servidor de la app verify / TTS-STT del comando | 3 / 3 | 0 / 0 |
| cua-driver embebido (Linux) | 1 | 0 |
| Bridge de emparejamiento de WhatsApp del dashboard | 1 | 0 |
| Mantenimiento de git acotado (repack, commit-graph) | 2 | 0 |
También hay un ratchet de CI: scripts/check_detached_spawns.py recorre los árboles de producción y rompe el build ante cualquier llamada nueva de spawn separado (start_new_session, process_group, os.setsid y compañía), salvo que la línea, o la de arriba, lleve un marcador detached-spawn: ok — <why>. La línea base está vacía. Así el arreglo no se puede erosionar en silencio más adelante.
Hay tres familias que deben sobrevivir al dueño
Una limpieza uniforme no significa “matar todo”. Hay procesos que se conservan a propósito:
- Los jobs en segundo plano de cualquier gateway. CLI, TUI, Desktop, ACP, cron y mensajería ejecutan herramientas dentro de un gateway, y cada arranque de gateway llama a
recover_from_checkpoint, que vuelve a adoptar sus jobs junto con sus logs de salida. Matar tunpm run dev &porque al gateway se le ocurrió quedar idle sería un desastre, así que solo un proceso que no es gateway es dueño de sus jobs en segundo plano. - Jobs con
persist_on_release(#41225): el nombre es el contrato; están pensados para sobrevivir. - La pantalla del Bot Desktop. Una pantalla virtual por profile, compartida entre turnos, abierta a que un humano tome el control, y re-enganchada por un gateway reiniciado después de una comprobación de identidad.
- Además los hand-offs del updater y de
/update, los propios servicios gateway/dashboard/launchd, los workers de cron y kanban, el daemon de egress y un Chrome de/browser connect: cosas que existen justamente porque tienen que sobrevivir a su lanzador. Cada una lleva su razón escrita en el código.
Versión corta: lo que arrancas para una tarea muere con Hermes; lo que pediste explícitamente que persistiera, no.
Revisar tu propia máquina
Puedes comprobarlo hoy mismo, sin esperar una versión nueva. Toma una foto del estado antes de reiniciar el gateway y compara después de un kill -9:
# hijos de larga vida que Hermes suele dejar atrás
ps -eo pid,ppid,pgid,etime,cmd | grep -Ei 'llama-server|chromium|puppeteer|language-server' | grep -v grep

# puertos que retienen esos daemons
ss -ltnp | grep -E ':8080|:9222|:8000'
Un ppid de 1 significa que init lo adoptó: en un build viejo, esa es la señal de que la limpieza nunca ocurrió. Si quieres barrer lo que ya está ahí, el tutorial de agent-janitor cubre un plugin de terceros que clasifica los huérfanos según la evidencia antes de matar nada. Los dos se complementan: el supervisor evita restos nuevos, el janitor limpia el historial.
Qué cambia en el día a día
Tres diferencias prácticas:
- Los reinicios después de un crash son limpios. Se acabó el
pkill -f llama-serverantes de arrancar y el “port already in use” causado por un daemon del build anterior. - Los modelos locales dejan de quemar GPU. llama-server y sus hijos de modelo terminan con la sesión.
- La curva de memoria se aplana. Cada crash dejaba residuos; un día completo de reinicios podía costar gigabytes.
Límites que conviene conocer: Windows usa otra capa (job objects) y no cambia; solo se poseen los hijos de larga vida, así que los comandos de una sola ejecución se comportan exactamente igual que antes; y los jobs en segundo plano de un gateway pueden seguir sobreviviendo a un gateway matado por diseño, no por descuido.
Estado del release
PR #137057 se fusionó en main el 2026-10-29 y ya está en la v0.22.6 (2026-11-02): con actualizar lo tienes, sin instalar desde main. En builds antiguos, haz la comprobación de arriba y combínala con el watchdog de bucle del gateway para que un proceso trabado al menos se reinicie en lugar de podrirse en silencio.
Si encuentras una familia nueva de restos en tu máquina —el daemon propio de un plugin, por ejemplo— vale la pena abrir un issue. El código core ahora tiene una barrera de CI por delante; los plugins todavía dependen de que sus autores sean cuidadosos.