Nach kill -9 bleiben manche Prozesse einfach da: Hermes lässt jetzt jedes Kind mit seinem Elternprozess sterben
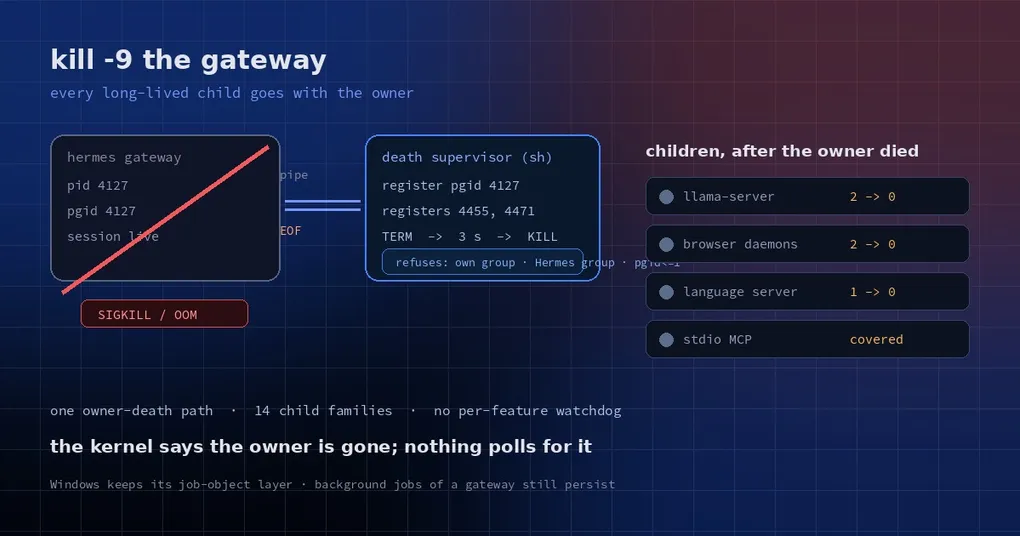
Es ist 2 Uhr nachts, die Lüfter des Laptops heulen, und du schickst dem Hermes-Gateway, das völlig aus dem Ruder gelaufen ist, ein kill -9 hinterher. Am nächsten Morgen zeigt ss -ltnp immer noch Port 8080 als belegt, und ps listet einen llama-server, zwei Browser-Daemons und einen Language Server auf, deren Elternprozess vor Stunden gestorben ist. Keiner von ihnen hat sich verabschiedet. Du beendest sie einzeln und fragst dich, ob morgen dasselbe Ritual wartet.
Das ist kein Anwenderfehler — so funktioniert Unix. Stirbt ein Elternprozess, werden seine Kinder an init (PID 1) umgehängt und laufen weiter. Bei einem Einmal-Befehl ist das egal. Bei etwas wie Hermes, das eine ganze Riege langlebiger Kinder startet, ist es ein echtes Problem. Eine aktuelle Änderung (PR #137057) hat einen Haufen feature-spezifischer Workarounds durch einen einzigen Mechanismus ersetzt: stirbt der Owner, verschwinden alle langlebigen Kinder, die er gestartet hat, mit ihm.
Warum Kinder das Sterben „vergessen“
Praktisch alles, was ein Agent tut, startet einen Prozess: npm run dev, ein Browser-Automation-Daemon, ein lokaler Model-Router, ein Language Server, eine Code-Execution-Zelle, ein MCP-Server über stdio. Diese Prozesse sollten genau so lange leben wie der Hermes-Prozess, der sie gestartet hat. Standardmäßig tun sie das nicht — sie bekommen einfach einen neuen Parent.
Die Rechnung kommt konkret: Speicher kriecht nach oben, Ports bleiben belegt, sodass der nächste Start scheitert, ein lokales Modell verbrennt weiter GPU, nachdem die Session längst vorbei ist, und ein alter Daemon streitet sich mit dem neuen um dieselbe pid-Datei. Das Debugging ist noch schlimmer: Da taucht ein unbekannter python-Prozess auf, und du hast keine Ahnung, wer ihn gestartet hat.
Hermes hat diese Familie früher Stück für Stück geflickt — ein Orphan-Sweep beim nächsten Start, ein Poller pro Owner, ein Parent-PID-Watchdog, eine Death-Pipe, ein atexit-Hook. Keiner davon wirkte in dem Moment, in dem der Owner tatsächlich starb; jeder wartete auf den nächsten Boot oder den nächsten Poll, und jede Kopie hatte ihre eigenen Bugs.
Eine Pipe sagt dir, dass der Owner weg ist
Das neue Design kommt mit genau einem Mechanismus aus. Jeder Hermes-Prozess hält das Schreibende einer Pipe; ein Supervisor (ein POSIX-sh-Skript, im Idle ungefähr 0,5 MB resident, gegenüber 8,1 MB bei der früheren Python-Version) hält das Leseende. Startet ein Kind, meldet Hermes seine Prozessgruppe beim Supervisor an; beendet sich das Kind regulär, meldet es sie wieder ab.
Der Trick ist EOF. In dem Moment, in dem der Hermes-Prozess verschwindet — sauberer Exit, Crash, kill -9, der OOM-Killer, ein systemd stop — wird das Schreibende geschlossen und der Supervisor liest sofort EOF. Das ist der Kernel, der dir sagt, dass der Halter des Schreibendes nicht mehr existiert, und das lässt sich weder ignorieren noch verpassen. Bei EOF schickt der Supervisor TERM an jede angemeldete Gruppe, wartet bis zu 3 Sekunden und schickt dann KILL.
Unsichere Ziele lehnt er ab: seine eigene Gruppe, die Gruppe von Hermes und alles mit einer pgid von 1 oder darunter. Er startet lazy bei der ersten Anmeldung und beendet sich nach 30 Sekunden Idle, damit ein Vordergrundbefehl, der seine Gruppe anmeldet und wieder freigibt, nicht bei jedem Lauf eine /bin/sh zurücklässt.
Zwei Engineering-Details stammen direkt aus Produktionsausfällen. Die nebenläufigen Schreibzugriffe auf das Spawn-Ledger: Drei Prozesse, die je 15 Kinder starteten, behielten früher nur 18 von 45 Zeilen, weil Read-Modify-Write nicht serialisiert war; jetzt greift ein prozessübergreifender File-Lock, der höchstens 2 Sekunden wartet, sodass ein hängender Writer die anderen nicht einfrieren kann. Der Supervisor, der selbst abgeschossen wird: pkill -f hermes nimmt ihn mit, deshalb wird er mit Replay aller Gruppen neu gestartet, solange Anmeldungen existieren — aber ein Supervisor, der sich innerhalb von 5 Sekunden nach dem Start selbst beendet (eine kaputte Installation), wird nicht in einer Schleife neu gestartet.
Die API ist klein: spawn_owned() ist der einzige Weg, ein langlebiges Kind zu starten (es führt seine eigene Prozessgruppe, meldet sie an und trägt sie ins Ledger ein); own_process_groups() / release_process_groups() übernehmen Gruppen, die jemand anderes gestartet hat, etwa das MCP SDK oder ein Browser-Harness; release_process_group_once_empty() gibt eine Gruppe erst zurück, wenn nichts mehr darin übrig ist.
14 Kinder-Familien umgestellt
Das sind die Zahlen aus dem PR. Der Test in jeder Zeile killt den Owner mit kill -9 und zählt, was danach noch lebt; jede Zeile hat einen lebenden Kontroll-Owner, damit ein Fix nicht dadurch besteht, dass einfach alles abgeschossen wird.
| Kinder-Familie | Vorher (main) | Nachher |
|---|---|---|
| stdio-MCP-Server | vom alten MCP-only-Supervisor abgedeckt | vom gemeinsamen abgedeckt |
| llama-server-Router und Modelle | 2 | 0 |
| Browser-Harness-Daemons | 2 (und 4 nach einem sauberen Exit übrig) | 0 (0) |
| Language Server (Nachfahren, die stdin-EOF ignorieren) | 1 | 0 |
| Code-Cell-Subprozesse im Kernel | 3/3 | 0/3 |
| Slash-Command-Worker | 1 | 0 |
| Terminal-Vordergrundbefehl | 2 | 0 |
| Terminal-Hintergrundjobs (in einem Nicht-Gateway-Prozess) | 3 | 0 |
| WhatsApp- / Raft-Bridges | 1 / 1 | 0 / 0 |
| verify-App-Server / Command-TTS-STT | 3 / 3 | 0 / 0 |
| Eingebetteter cua-driver (Linux) | 1 | 0 |
| WhatsApp-Pairing-Bridge im Dashboard | 1 | 0 |
| Begrenzte git-Maintenance (repack, commit-graph) | 2 | 0 |
Dazu kommt eine CI-Ratsche: scripts/check_detached_spawns.py läuft durch die Produktionsbäume und lässt den Build bei jedem neuen Detached-Spawn-Aufruf (start_new_session, process_group, os.setsid und Verwandte) fehlschlagen, es sei denn, die Zeile oder die Zeile darüber trägt einen Marker detached-spawn: ok — <why>. Die Baseline ist leer. Der Fix kann also später nicht leise erodieren.
Drei Familien sollen den Owner überleben
Einheitliches Aufräumen heißt nicht „alles abschießen“. Manche Prozesse bleiben bewusst:
- Hintergrundjobs jedes Gateways. CLI, TUI, Desktop, ACP, cron und Messaging führen ihre Tools alle in einem Gateway aus, und jeder Gateway-Boot ruft
recover_from_checkpointauf, was die Jobs samt ihren Output-Logs wieder übernimmt. Deinnpm run dev &abzuschießen, nur weil das Gateway zufällig in den Idle gegangen ist, wäre eine Katastrophe — deshalb besitzt nur ein Nicht-Gateway-Prozess seine Hintergrundjobs. persist_on_release-Jobs (#41225) — der Name ist der Vertrag; sie sollen überleben.- Der Bot-Desktop-Screen. Ein virtueller Screen pro Profil, über Turns hinweg geteilt, für menschliche Übernahme offen, von einem neu gestarteten Gateway nach einer Identitätsprüfung wieder angehängt.
- Dazu die Übergaben von Updater und
/update, die Dienste gateway/dashboard/launchd selbst, cron- und kanban-Worker, der Egress-Daemon und ein Chrome aus/browser connect— Dinge, die genau deshalb existieren, weil sie ihren Launcher überleben müssen. Jedes trägt einen schriftlich festgehaltenen Grund im Code.
Kurzfassung: Was du für eine Aufgabe startest, stirbt mit Hermes; was du ausdrücklich als persistent angefordert hast, nicht.
Die eigene Maschine prüfen
Das lässt sich schon heute verifizieren, ohne neues Release. Mach eine Momentaufnahme, bevor du das Gateway neu startest, und vergleiche nach einem kill -9:
# langlebige Kinder, die Hermes gern zurücklässt
ps -eo pid,ppid,pgid,etime,cmd | grep -Ei 'llama-server|chromium|puppeteer|language-server' | grep -v grep

# Ports, die diese Daemons halten
ss -ltnp | grep -E ':8080|:9222|:8000'
Eine ppid von 1 heißt: init hat den Prozess übernommen — bei einem älteren Build ist das das Signal dafür, dass nie aufgeräumt wurde. Wenn du den Altbestand gleich wegräumen willst: die agent-janitor-Walkthrough beschreibt ein Drittanbieter-Plugin, das Orphans anhand von Belegen bewertet, bevor es etwas killt. Die beiden ergänzen sich: Der Supervisor verhindert neue Reste, der Janitor räumt die Historie auf.
Was sich im Alltag ändert
Drei praktische Unterschiede:
- Neustarts nach einem Crash sind sauber. Kein
pkill -f llama-servermehr vor dem Start, kein „Port already in use“ mehr, verursacht durch einen Daemon aus dem vorherigen Build. - Lokale Modelle verbrennen keine GPU mehr. llama-server und seine Modell-Kinder enden mit der Session.
- Die Speicherkurve flacht ab. Jeder Crash hinterließ früher Rückstände; ein voller Tag mit Neustarts konnte Gigabytes kosten.
Grenzen, die man kennen sollte: Windows nutzt eine andere Schicht (Job Objects) und ist unverändert; nur langlebige Kinder werden besessen, Einmal-Befehle verhalten sich also exakt wie bisher; und Hintergrundjobs des Gateways können ein gekilltes Gateway weiterhin überleben — by design, nicht aus Versehen.
Release-Status
PR #137057 wurde am 2026-10-29 in main gemerged und ist mit v0.22.6 (2026-11-02) in ein Release gekommen – ein normales Update genügt, keine main-Installation nötig. Auf älteren Builds hilft die Prüfung oben plus der Gateway-Loop-Watchdog, damit ein festgefahrener Prozess wenigstens neu gestartet wird, statt still vor sich hin zu verrotten.
Wenn du auf deiner Maschine eine neue Familie von Resten findest — etwa den eigenen Daemon eines Plugins — lohnt sich ein Issue. Vor dem Core-Code steht inzwischen ein CI-Gate; Plugins verlassen sich weiterhin darauf, dass ihre Autoren sorgfältig sind.