kill -9 之后总有几个进程不肯走:Hermes 现在让子进程跟着父进程一起死
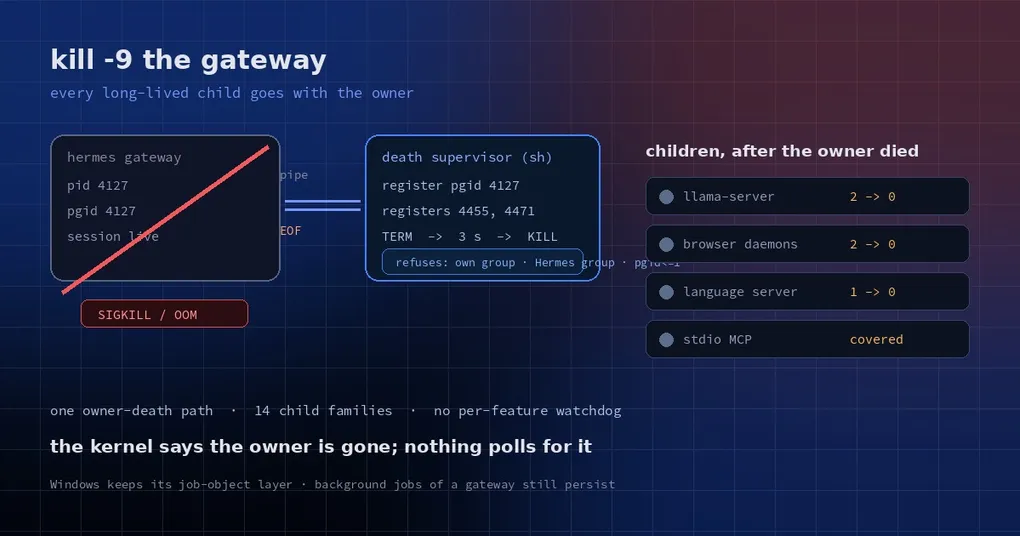
凌晨两点,机器忽然变卡,你 kill -9 掉那个跑疯了的 Hermes 网关。第二天打开终端,ss -ltnp 显示 8080 端口还被占着,ps 里躺着一个 llama-server、两个浏览器守护进程、一个语言服务器——它们的父进程早就没了,却谁也不肯退场。你只能一个个 kill,顺便担心下次是不是又要来一遍。
这不是你的操作问题,而是 Unix 的老规矩:父进程死了,子进程会被交给 init(PID 1)收养,然后继续活着。对一次性命令无所谓,对 Hermes 这种会拉起一堆长生命周期子进程的程序就很要命。Hermes 最近的改动(PR #137057)把这件事从“每个功能自己想办法”改成了统一机制:父进程一断气,它启动的所有长生命周期子进程跟着走。
子进程为什么“忘了死”
agent 干活的每一步几乎都在开进程:跑一条 npm run dev、起一个浏览器守护进程、拉一个本地模型的路由器、开一个语言服务器、执行一段代码、连一个 MCP 服务器。这些进程的寿命本来应该跟启动它的那个 Hermes 进程一样长,但默认情况下它们是独立的——父进程消失,它们只换了个爹。
后果很具体:内存被慢慢吃掉、端口被占着导致下次启动失败、本地模型还在推理烧 GPU、旧版本的守护进程和新版本的抢同一个 pid 文件。更麻烦的是排查:你看到一个陌生的 python 进程,完全不知道是谁启动的。
以前 Hermes 每个功能各写各的补丁:下次启动时扫一遍孤儿进程、给每个 owner 配一个轮询器、写一个 parent-pid 看门狗、开一个死亡管道、注册一个 atexit 钩子。做法不少,但都不在“父进程真正死掉”的那一刻生效——它们要等下一次启动,或者等某个定时检查。而且每套逻辑都是复制的,改一处漏三处。
一条管道就能知道“爸爸死了没有”
新的做法只保留一种机制:每个 Hermes 进程持有一根管道的写端,监督进程(一个 POSIX sh 脚本,空闲时常驻内存大约 0.5 MB,早期 Python 版本是 8.1 MB)持有读端。子进程启动时,Hermes 把自己的进程组号登记给监督进程;子进程正常结束时再注销。
关键在 EOF:只要 Hermes 这个进程消失——不管是正常退出、崩溃、kill -9、被 OOM killer 挑中,还是 systemd 停服务——管道写端就没了,读端立刻读到 EOF。**这是内核告诉你“持有写端的进程已经不存在了”,无法被忽略,也不需要轮询。**监督进程收到 EOF 后给每个登记过的进程组发 TERM,等最多 3 秒,再发 KILL。
它也会拒绝危险目标:自己的进程组、Hermes 所在的进程组、以及 pgid 小于等于 1 的组,一律不动。监督进程是懒启动的:第一次有进程登记才起来,连续 30 秒没有登记就自己退出,所以一条命令跑完就走的场景不会每次都留一个 /bin/sh 挂着。
配套还有两处工程细节,都是被真实故障逼出来的。**一是登记表(spawn ledger)的并发写。**以前三个进程各起 15 个子进程,45 行记录最后只剩 18 行,因为读-改-写没有加锁。现在写之前拿一个跨进程文件锁,最多等 2 秒,拿不到也不会卡死。**二是监督进程自己被杀。**如果你 pkill -f hermes 把它一起带走了,只要还有进程组登记着,就重启它并把所有组重新登记一遍;而一个刚启动 5 秒就自己退出(比如装坏了)的监督进程不会进入重启循环。
真正落地的接口只有几个:spawn_owned() 用来启动长生命周期子进程(自己成为一个进程组的组长、登记给监督进程、写进登记表),own_process_groups() / release_process_groups() 用来接管别人启动的组(比如 MCP SDK 或浏览器守护进程),release_process_group_once_empty() 只在组里没人了才交还,避免“漏网之鱼”失去保护。
14 类子进程统一搬家
下表是 PR 里给出的实测对比,测试方式是:父进程被 kill -9 之后,等一段时间看还有几个进程活着(每个场景都有一个对照组,确保不是把所有进程都杀光了)。
| 子进程家族 | 改动前残留 | 改动后 |
|---|---|---|
| stdio MCP 服务器 | 由旧的 MCP 专用监督者覆盖 | 由统一监督者覆盖 |
| llama-server 路由器与模型 | 2 | 0 |
| 浏览器守护进程 | 2(正常退出后还留 4 个) | 0(正常退出后 0 个) |
| 语言服务器(忽略 stdin EOF 的子进程) | 1 | 0 |
| 代码执行内核里的单元子进程 | 3/3 | 0/3 |
| 斜杠命令 worker | 1 | 0 |
| 终端前台命令 | 2 | 0 |
| 终端后台任务(非网关进程里) | 3 | 0 |
| WhatsApp / Raft 桥 | 1 / 1 | 0 / 0 |
| verify 应用服务器 / 命令式 TTS-STT | 3 / 3 | 0 / 0 |
| 内嵌 cua-driver(Linux) | 1 | 0 |
| 仪表盘的 WhatsApp 配对桥 | 1 | 0 |
| 有界 git 维护(repack、commit-graph) | 2 | 0 |
还有一条 CI 规矩:scripts/check_detached_spawns.py 会扫描代码,任何新的“脱离父进程”写法(start_new_session、process_group、os.setsid 之类)都必须带一行理由注释,否则构建直接失败。也就是说,这个修复不会被下一个人悄悄改回去。
有三类子进程是故意不跟着死的
统一收尸不等于“全杀”。有几处刻意保留,因为它们活着才有意义:
- 网关的后台任务。所有网关(CLI、TUI、桌面端、ACP、cron、消息平台)的后台任务,在网关重启后会被
recover_from_checkpoint重新接管,输出日志也还在。如果网关只是空闲退出就把你的npm run dev &杀掉,那是灾难。所以这类任务只在“非网关进程”里被监督者接管。 persist_on_release的后台任务(#41225)。名字就说明了:它就是要跨进程活下来。- Bot Desktop 的虚拟屏幕。每个 profile 一块屏幕,跨会话保留,人还能接管;重启的网关会带着身份校验重新挂上去。
- 更新器、
/update交接、网关/仪表盘/launchd 服务本身、cron 与 kanban worker、egress 守护进程、Chrome 连接——这些都是“必须比启动者活得久”的东西,代码里逐个标了理由。
一句话记:你临时跑的东西会跟着 Hermes 死,你明确要求常驻的东西不会。
怎么确认自己有没有中招
你现在就能自查,不需要等新版本。下次启动网关前先记一份进程快照,kill -9 之后再对比:
# 记下当前和 Hermes 相关的长生命周期进程
ps -eo pid,ppid,pgid,etime,cmd | grep -Ei 'llama-server|chromium|puppeteer|language-server' | grep -v grep

# 端口占用(浏览器守护进程、本地模型路由器常占这些)
ss -ltnp | grep -E ':8080|:9222|:8000'
如果 ppid 变成了 1,说明它已经被 init 收养——在旧版本上这就是“该收尸了”的信号。想一次性看清所有孤儿,可以按 ppid=1 过滤,再对照启动时间判断是不是你的 agent 留下的。站内另一篇 agent-janitor 的实战记录讲的就是怎么用第三方插件批量清理这类残留,两者可以配合:新的监督机制负责“不让它发生”,janitor 负责“清理历史遗留”。
这件事对日常使用意味着什么
对普通用户,最直接的三个变化:
- **崩溃之后重启更干净。**不再需要手动
pkill -f llama-server,也不会出现“新网关起不来因为端口被旧守护进程占着”。 - **本地模型不再偷偷烧 GPU。**llama-server 和它的模型子进程会跟着会话结束。
- **内存曲线更平。**以前每次崩溃都会留一点垃圾,跑一天下来能差出几个 GB。
需要注意的边界:Windows 上走的是另一套机制(job object),行为不变;被监督者接管的只是“长生命周期子进程”,一次性命令本来就等着它结束;网关的后台任务仍然可能在你杀进程后继续跑,这是设计取舍,不是漏网。
现在的状态
PR #137057 于 2026-10-29 合并进 main,并已随 v0.22.6(2026-11-02 发布) 进入正式发行版——升级后就是默认行为,不需要从主线源码安装。还在老版本上时,先照上面的方法自查,配合 gateway 循环看门狗一起用,能少踩不少“进程还在但网关已经死了”的坑。
如果你在自己的机器上发现了新的残留进程家族(比如某个插件自己起的守护进程),值得提一个 issue——现在这套机制有 CI 挡着,新代码很难再偷偷绕过它,但插件那边还靠自觉。