El culpable del OOM a las 3 de la mañana: los procesos huérfanos que dejó tu agente
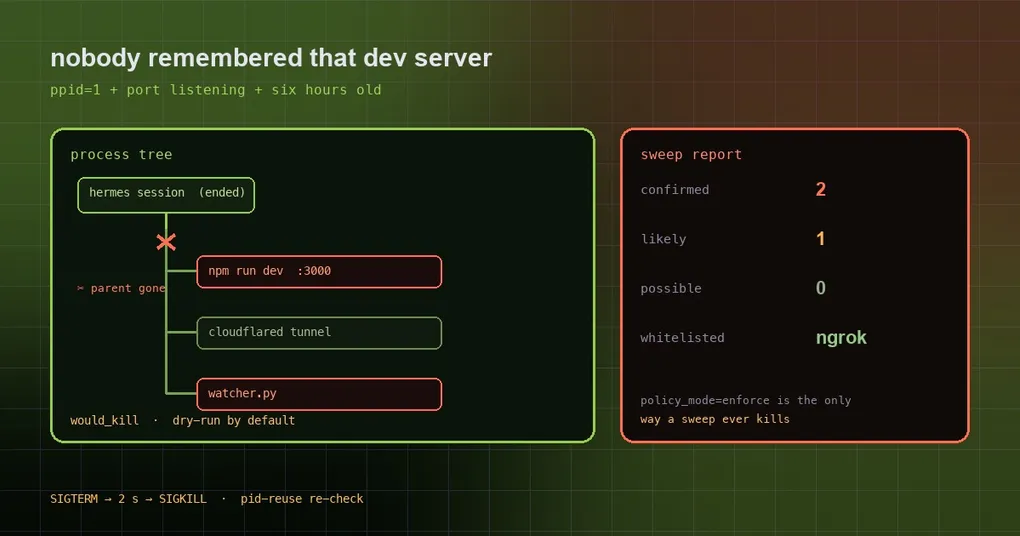
El ventilador del portátil vuelve a arrancar, localhost:3000 dice que el puerto está ocupado y ps aux muestra cuatro procesos node y python que no reconoces. En algún rincón de tu memoria: la semana pasada le pediste al agente que “levantara un servidor y lo probara”, la session terminó y el servidor no. Lo que todos esos restos tienen en común es que nadie los recuerda y nada lleva la cuenta — y ese es exactamente el trabajo de agent-janitor.
De dónde salen los procesos huérfanos
Una llamada de herramienta del agente se parece mucho a que tú escribas en una terminal. Le pides que ejecute npm run dev en segundo plano, que abra un túnel cloudflared o que enganche un watcher de archivos; el comando retorna y el proceso sigue vivo. Cuando la session termina y su terminal desaparece, Linux reasigna el superviviente al PID 1 — eso es lo que significa ppid == 1, y es la firma de “huérfano” más fiable que existe.
El costo es concreto: puertos ocupados, RAM consumida, un OOM a las 3 de la mañana y, la próxima vez que arrancas el agente, un servicio propio al que no puede llegar. Peor aún es el costo de clasificar el problema: no tienes ni idea de quién lanzó ese python app.py.
Juzga con pruebas, no con corazonadas
agent-janitor clasifica los procesos en lugar de disparar contra cualquier cosa sospechosa:
| Prueba | Confianza |
|---|---|
| Reasignado a init (ppid=1) y retiene un puerto / rasgos de dev server / TTL superado | confirmado |
| Solo reasignado a init (ppid=1) | probable |
| Rasgos de dev y TTL superado, pero el padre sigue vivo | posible (nunca se limpia solo) |
Todo lo que lee es local: ppid y líneas de comando desde /proc, sockets en escucha desde /proc/net/tcp{,6}, y un umbral de antigüedad. Solo los confirmed y los likely se pueden matar.
Dos clases quedan exentas por nombre: los daemons del sistema (multipathd, udisksd, ModemManager, systemd-* y compañía) y los agentes de gestión de host y VM (tailscaled, agentes de proveedores cloud, amazon-ssm-agent, walinuxagent, google_guest_agent). Tú añades tu propia infraestructura a una whitelist:
janitor whitelist add ngrok
janitor whitelist add cloudflared
janitor whitelist add tmux
Las entradas de la whitelist son subcadenas que se comparan con la línea de comando (distingue mayúsculas, se escapan las regex, sin inyección). Un array vacío o un archivo ausente significa que no hay nada en la whitelist.
Instala y escanea antes de limpiar
Vive en el catálogo curado (agent-janitor 0.3.1, nivel comunitario, requiere Hermes >= 0.21.6). Instálalo por nombre si tu catálogo lo lista; si no, desde el repositorio como muestra el README:
git clone https://github.com/ZidoCode/agent-janitor ~/.hermes/plugins/agent-janitor
hermes plugins enable agent-janitor
Ahora solo escanea; no limpies nada todavía:
python3 ~/.hermes/plugins/agent-janitor/janitor_cli.py scan
python3 ~/.hermes/plugins/agent-janitor/janitor_cli.py sweep --ttl-h 6
Ese segundo comando suena alarmante, pero por defecto es un dry run: las decisiones se imprimen y se registran como would_kill, nada muere.
Un solo archivo habilita la matanza real — <hermes-home>/plugin-data/agent-janitor/policy_mode, cuyo contenido debe ser exactamente enforce:
echo enforce > ~/.hermes/plugin-data/agent-janitor/policy_modeEse diseño vale la pena copiarlo: seguro por defecto, y el estado peligroso exige una decisión escrita.
Antes de activar enforce, haz estas cinco cosas
- Llena la whitelist primero. Tu túnel, proxy inverso, tmux, cualquier cosa “lanzada por el agente pero mantenida a propósito” entra con
janitor whitelist add. - Lee la salida del dry run como la lista de bajas. Eso es exactamente sobre lo que actuará enforce, ni más ni menos.
- Sabe a quién alcanza. La regla es “reasignado al PID 1 hace más de un minuto, no exento, no en whitelist” — no comprueba quién arrancó el proceso. Un
hermes gatewaylanzado connohupo un servidor tmux entra en el objetivo en modo enforce si no lo pusiste en la whitelist, y al ejecutarse como root eso incluye procesos de otros usuarios. - Sabe qué deja atrás.
spawns.jsonlregistra los comandos de terminal que parecían iniciar trabajo en segundo plano, ysweeps.jsonlregistra cada decisión (would_killo ejecutado), así que puedes auditar la limpieza después. - Sabe el orden de la matanza. SIGTERM, espera dos segundos, SIGKILL — y antes del
kill -9vuelve a leer la línea de comando y aborta si el PID fue reciclado. Sin fuego amigo por reutilización de PID.
Combínalo con el ledger para saber de quién es cada proceso
Por sí solo, janitor solo puede decir “este proceso es un huérfano”. Con agent-ledger, del mismo autor, instalado, lee el ledger y convierte un python app.py anónimo en “lanzado por esta llamada de herramienta concreta en el puerto 8080, hace 12 días”. La atribución es difusa — compara por el nombre base del ejecutable — así que tómala como pista, no como prueba. El propio autor la etiqueta igual.
Tres límites que tienes que conocer
- Solo Linux, porque lee
/proc. macOS y Windows no están soportados, así que en un Mac esta herramienta va en tus servidores, no en tu portátil. - La suspensión del portátil infla el uptime. El uptime es relativo al arranque y sigue contando mientras la máquina duerme, así que puede haber falsos positivos de TTL en equipos que cierran la tapa. En un servidor — el objetivo principal — esto no aplica.
- La whitelist compara subcadenas de la línea de comando, así que un shell en whitelist que luego lanza algo peligroso es invisible para ella.
Para reducir en general el problema de “no sé qué hizo mi agente”: janitor cubre la dimensión de procesos, el fingerprinting de skills cubre la de skills y el cron doctor cubre los trabajos programados. Para la rutina general de instalar y fijar versiones, consulta la guía del catálogo de plugins.