Una línea basura en jobs.json detuvo todos tus cron jobs
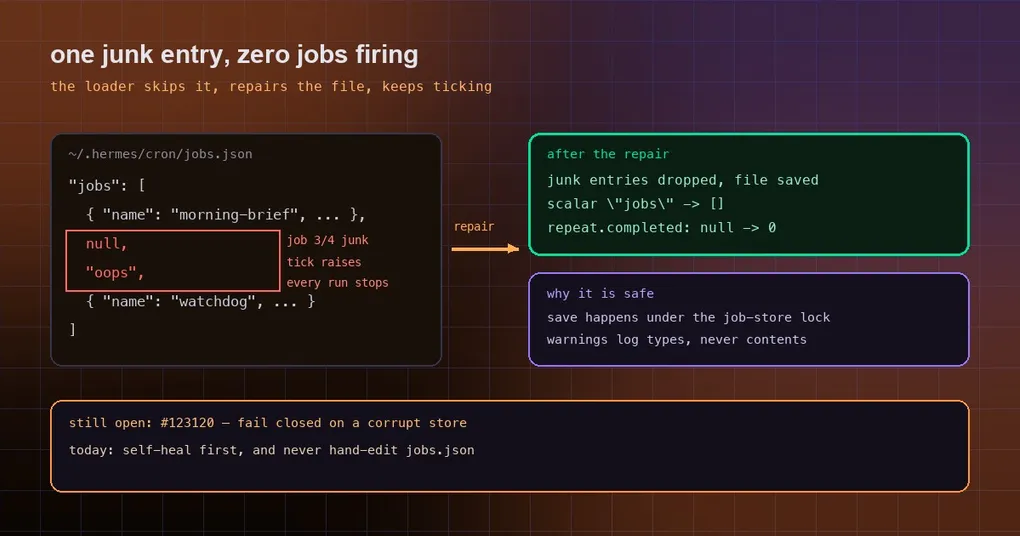
Es lunes por la mañana y el briefing diario nunca ha llegado. Miras el miércoles: vacío. El martes: también vacío. hermes cron list muestra todos los jobs todavía ahí, next_run_at parece razonable y ninguna línea de la salida de estado te está gritando nada. Aun así no se ejecuta nada. Cuando todos los jobs se quedan en silencio a la vez, la causa normalmente no son tus definiciones de jobs: es un null que se ha colado en ~/.hermes/cron/jobs.json. Una sola entrada mala basta para detener el scheduler entero. Una corrección fusionada el 2026-09-26 (PR #124034) cubre ese tipo de entrada; aquí tienes cómo se rompió, qué pasa ahora y cómo comprobar tu propia máquina.
Cómo un único null tumba el scheduler
jobs.json es el almacén de cron jobs. En cada tick, el scheduler llama a load_jobs() para leerlo. Si esa lectura lanza una excepción, el tick falla — y el siguiente tick lee el mismo archivo y vuelve a fallar. Los jobs en sí están perfectamente sanos; simplemente nunca les llega el turno.
Había tres entradas distintas que podían producir ese desenlace por separado:
| Entrada | Comportamiento antiguo | Consecuencia |
|---|---|---|
Una entrada que no es objeto en la lista jobs (null, una cadena, un número) |
load_jobs() lanzaba excepción |
Fallaba cada tick, así que no se ejecutaba ningún job (issue #123281) |
Un campo jobs escalar, p. ej. {"jobs": null} |
Se devolvía al llamante tal cual | Los llamantes reventaban en otro sitio |
Un job cuyo repeat.completed era null |
mark_job_run / update_job lanzaban TypeError: NoneType + int |
El registro de una ejecución se caía (issue #122114) |
El tercero arrastraba además un bug de visualización que lo hacía fácil de ignorar: con un contador roto, la tool de cronjob mostraba un job de una sola ejecución como 1/1, y hermes cron mostraba la cuenta como None/3. Con aspecto raro, no con aspecto de error — así que se quedaba roto.
Qué pasa ahora
- Las entradas malas se saltan y el archivo se repara. El loader ya no lanza excepción por un trozo de basura; descarta las entradas que no son objetos y vuelve a escribir el almacén limpio en disco — incluso cuando no queda ningún job válido, en cuyo caso el archivo pasa a ser
[]. - Un campo
jobsescalar se normaliza.{"jobs": null}pasa a[]y se guarda, para que todos los llamantes reciban una lista. - Un contador que no es entero se normaliza.
repeat.completedse resetea a un recuento válido cuando no es un entero no negativo (0 cuando no se puede leer), una sola vez, al cargar — así todos los lectores ven un entero y los errores de visualización1/1/None/3desaparecen con él. - La reparación corre bajo el lock. El guardado vuelve a leer el archivo después de adquirir el lock del job store, de modo que un
update_jobconcurrente no se revierte. Ese fue el punto de revisión que bloqueaba el parche original, y es la diferencia entre «reparar» y «deshacer en silencio el cambio de alguien». - Los avisos registran tipos, no contenidos. Cada aviso de reparación se emite una vez, y nombra el tipo del valor omitido en lugar del valor en sí.
La documentación ahora lo dice sin rodeos: si una edición manual deja jobs.json malformado, el scheduler lo repara en la siguiente carga en lugar de detenerse.
Comprobar tu propia máquina
Primero confirma que el scheduler y los propios jobs están sanos:
hermes cron list        # jobs and their status
hermes cron doctor      # failed runs, failed deliveries, overdue next_run_at, missing scripts
Para buscar valores que no deberían estar ahí, esta pasada de solo lectura informa de las formas:
python3 - <<'PY'
import json, os
p = os.path.expanduser("~/.hermes/cron/jobs.json")
d = json.load(open(p))
jobs = d.get("jobs")
print("jobs type:", type(jobs).__name__)
if isinstance(jobs, list):
    bad = [(i, type(j).__name__) for i, j in enumerate(jobs) if not isinstance(j, dict)]
    print("entries:", len(jobs), "| non-object entries:", bad or "none")
    for j in jobs:
        c = (j.get("repeat") or {}).get("completed")
        if not isinstance(c, int) or c < 0:
            print("  bad counter:", j.get("name") or j.get("id"), "->", repr(c))
PY
Nunca escribe. La reparación en sí es cosa de Hermes: actualiza, deja que el scheduler haga su tick y las entradas malas habrán desaparecido.
No edites jobs.json a mano
La documentación es explícita: gestiona los jobs a través de la tool cronjob_manage, de hermes cron edit o de /cron — no parcheando jobs.json directamente. Las ediciones directas pueden fallar en silencio cuando la ruta está bloqueada por la seguridad de escritura de archivos (por ejemplo con HERMES_WRITE_SAFE_ROOT configurado), y el footer del verificador de mutaciones de archivo es la única señal autoritativa de que no se ha guardado nada.
Y es exactamente por eso que esta corrección importa: los accidentes que ocurren fuera del camino de la tool — un script externo, una herramienta de sincronización, una edición manual a medias — no deberían costarte todos los jobs programados de la máquina.
Qué sigue abierto
El PR es explícito sobre una cosa que deliberadamente no hizo: la issue #123120 propone fallar en cerrado ante un almacén corrupto en lugar de repararlo, lo cual es una postura de comportamiento distinta y una decisión de los maintainers. Sigue abierta. La política actual es curarse a sí mismo primero.
La conclusión
jobs.json pasó de «una entrada basura mata a toda la flota» a «sáltala, repara el archivo, sigue disparando», y repeat.completed pasó de un crash a un entero garantizado. Si ejecutas trabajo programado sin supervisión, merece la pena adoptarlo pronto — corrige el modo de fallo más difícil de diagnosticar, ese en el que todo parece configurado y no pasa nada. Para el terreno que lo rodea: un comando que hace un chequeo completo a toda la flota, las trampas de timezone y DST en schedules que cruzan días, cron jobs que guardan notas entre ejecuciones, y la referencia del comando hermes cron.