Eine einzige Müllzeile in jobs.json stoppte jeden cron-Job, den Sie haben
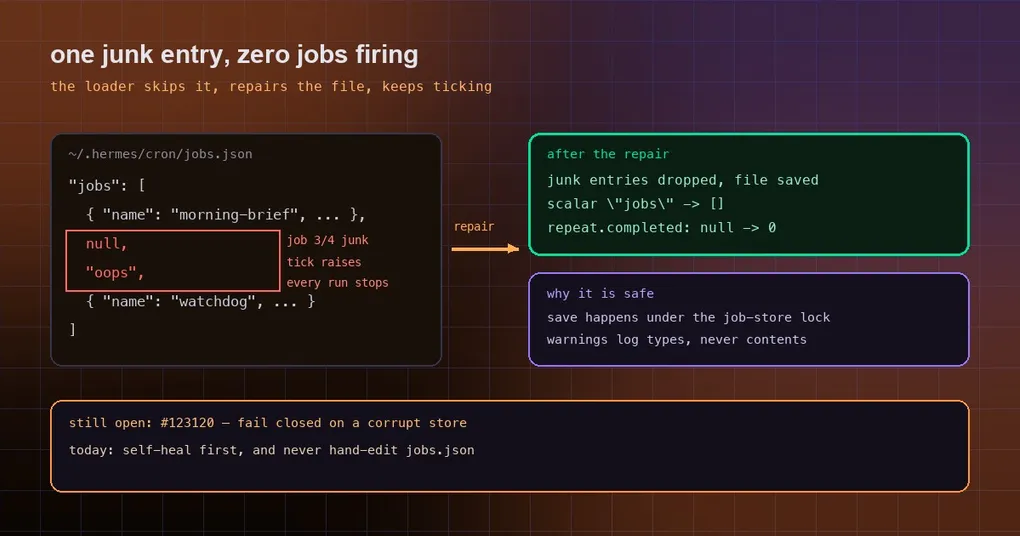
Es ist Montagmorgen, und das Daily Briefing ist nie angekommen. Sie schauen auf Mittwoch — leer. Dienstag — auch leer. hermes cron list zeigt jeden Job weiterhin an, next_run_at sieht vernünftig aus, und keine Zeile in der Status-Ausgabe schreit Sie an. Trotzdem läuft nichts. Wenn alle Jobs auf einmal verstummen, liegt die Ursache meist nicht in Ihren Job-Definitionen: Es ist ein einzelnes null, das in ~/.hermes/cron/jobs.json gelandet ist. Ein schlechter Eintrag reicht, um den gesamten Scheduler zu stoppen. Ein Fix, gemergt am 26. September 2026 (PR #124034), behandelt diese Klasse von Eingaben; hier steht, wie es kaputtging, was jetzt passiert und wie Sie Ihre eigene Maschine prüfen.
Wie ein einzelnes null den Scheduler lahmlegt
jobs.json ist der Job-Store von cron. Bei jedem Tick ruft der Scheduler load_jobs() auf, um ihn zu lesen. Wirft dieses Lesen eine Exception, scheitert der Tick — und der nächste Tick liest dieselbe Datei und scheitert wieder. Die Jobs selbst sind völlig gesund; sie kommen einfach nie an die Reihe.
Drei unterschiedliche Eingaben konnten jeweils zu diesem Ergebnis führen:
| Eingabe | Altes Verhalten | Folge |
|---|---|---|
Ein Nicht-Objekt-Eintrag in der jobs-Liste (null, ein String, eine Zahl) |
load_jobs() warf eine Exception |
Jeder Tick scheiterte, also lief überhaupt kein Job (Issue #123281) |
Ein skalares jobs-Feld, z. B. {"jobs": null} |
Wurde unverändert an den Aufrufer zurückgegeben | Die Aufrufer flogen woanders hoch |
Ein Job, dessen repeat.completed null war |
mark_job_run / update_job warfen TypeError: NoneType + int |
Das Aufzeichnen eines Laufs stürzte ab (Issue #122114) |
Der dritte Fall brachte einen Anzeigefehler mit, der ihn leicht zu ignorieren machte: Mit einem kaputten Counter zeigte das cronjob-Tool einen Run-once-Job als 1/1 an, und hermes cron zeigte die Anzahl als None/3. Seltsam aussehend, nicht fehlerhaft aussehend — also blieb es kaputt.
Was jetzt passiert
- Schlechte Einträge werden übersprungen und die Datei wird repariert. Der Loader wirft wegen eines Stücks Müll keine Exception mehr; er verwirft Nicht-Objekt-Einträge und schreibt den bereinigten Store zurück auf die Platte — auch dann, wenn kein gültiger Job mehr übrig ist; in diesem Fall wird die Datei zu
[]. - Ein skalares
jobs-Feld wird normalisiert.{"jobs": null}wird zu[]und wird gespeichert, sodass jeder Aufrufer eine Liste bekommt. - Ein Nicht-Integer-Counter wird normalisiert.
repeat.completedwird auf einen gültigen Zählerstand zurückgesetzt, wenn er keine nicht-negative Ganzzahl ist (0, wenn er nicht gelesen werden kann), einmalig beim Laden — so sieht jeder Reader eine Ganzzahl, und die Anzeigefehler1/1/None/3verschwinden damit. - Die Reparatur läuft unter dem Lock. Das Speichern liest die Datei nach dem Erwerb des Job-Store-Locks neu ein, sodass ein gleichzeitiges
update_jobnicht zurückgedreht wird. Das war der blockierende Review-Punkt am ursprünglichen Patch, und es ist der Unterschied zwischen „reparieren“ und „stillschweigend die Änderung von jemand anderem rückgängig machen“. - Warnungen protokollieren Typen, nicht Inhalte. Jede Reparatur-Warnung wird einmal ausgegeben, und sie nennt den Typ des übersprungenen Werts statt den Wert selbst.
Die Dokumentation sagt es jetzt klar: Wenn eine Handänderung jobs.json malformed zurücklässt, repariert der Scheduler sie beim nächsten Laden, statt zu stoppen.
Ihre eigene Maschine prüfen
Prüfen Sie zuerst, ob der Scheduler und die Jobs selbst gesund sind:
hermes cron list        # jobs and their status
hermes cron doctor      # failed runs, failed deliveries, overdue next_run_at, missing scripts
Um nach Werten zu suchen, die dort nicht hingehören, meldet dieser Read-only-Durchlauf die Formen:
python3 - <<'PY'
import json, os
p = os.path.expanduser("~/.hermes/cron/jobs.json")
d = json.load(open(p))
jobs = d.get("jobs")
print("jobs type:", type(jobs).__name__)
if isinstance(jobs, list):
    bad = [(i, type(j).__name__) for i, j in enumerate(jobs) if not isinstance(j, dict)]
    print("entries:", len(jobs), "| non-object entries:", bad or "none")
    for j in jobs:
        c = (j.get("repeat") or {}).get("completed")
        if not isinstance(c, int) or c < 0:
            print("  bad counter:", j.get("name") or j.get("id"), "->", repr(c))
PY
Er schreibt nie. Die Reparatur selbst ist Hermes’ Aufgabe: Upgraden, den Scheduler ticken lassen, und die schlechten Einträge sind weg.
Bearbeiten Sie jobs.json nicht per Hand
Die Docs sind explizit: Verwalten Sie Jobs über das cronjob_manage-Tool, hermes cron edit oder /cron — nicht, indem Sie jobs.json direkt patchen. Direkte Änderungen können still scheitern, wenn der Pfad von der Datei-Write-Safety blockiert wird (zum Beispiel mit gesetztem HERMES_WRITE_SAFE_ROOT), und der File-Mutation-Verifier-Footer ist das einzige verlässliche Signal dafür, dass nichts gespeichert wurde.
Genau deshalb ist dieser Fix wichtig: Unfälle, die außerhalb des Tool-Pfads passieren — ein externes Skript, ein Sync-Tool, eine halbfertige manuelle Änderung —, sollten Sie nicht jeden geplanten Job auf der Maschine kosten.
Was noch offen ist
Das PR sagt ausdrücklich, was es bewusst nicht getan hat: Issue #123120 schlägt vor, bei einem kaputten Store fail-closed zu gehen, statt ihn zu reparieren — eine andere Verhaltenshaltung und eine Maintainer-Entscheidung. Sie bleibt offen. Die heutige Politik heißt: erst self-healen.
Das Fazit
jobs.json ist von „ein Müll-Eintrag killt die ganze Flotte“ zu „überspringen, Datei reparieren, weiter feuern“ gewechselt, und repeat.completed ist von einem Crash zu einer garantierten Ganzzahl geworden. Wenn Sie unbeaufsichtigte geplante Arbeit laufen lassen, lohnt es sich, das früh zu übernehmen — es behebt den Fehlermodus, der am schwersten zu diagnostizieren ist: den, bei dem alles konfiguriert aussieht und nichts passiert. Für das Umfeld: ein Befehl, der der ganzen Flotte einen Checkup gibt, Zeitzonen- und DST-Fallen bei tagesübergreifenden Zeitplänen, cron-Jobs, die zwischen Läufen Notizen behalten und die hermes cron Kommando-Referenz.