Uma linha de lixo no jobs.json parou todos os seus cron jobs
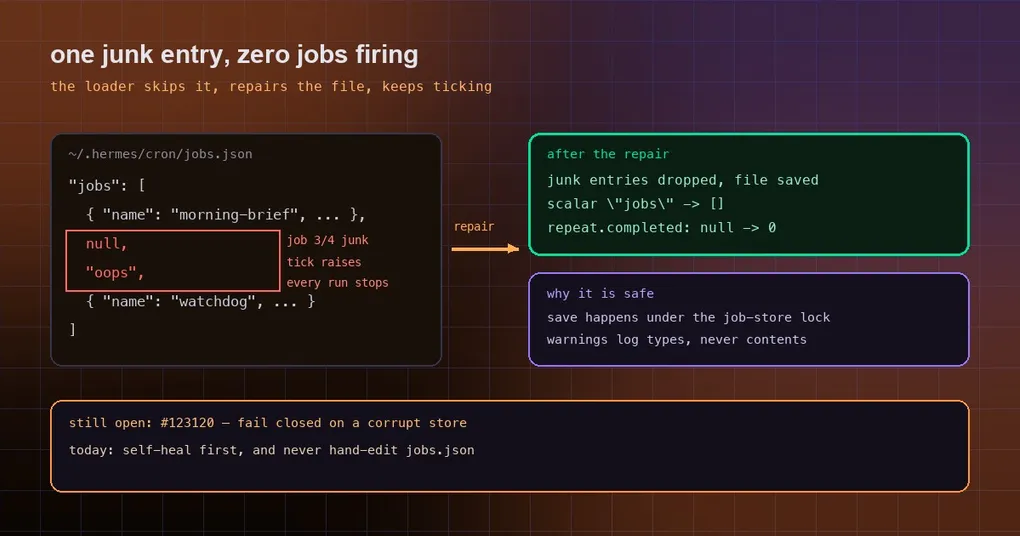
É segunda-feira de manhã e o briefing diário nunca chegou. Você confere quarta — vazio. Terça — vazio também. O hermes cron list mostra todos os jobs ainda ali, o next_run_at parece razoável, e nenhuma linha da saída de status está gritando com você. Mesmo assim nada roda. Quando todos os jobs ficam em silêncio ao mesmo tempo, a causa em geral não está nas suas definições de job: é um único null que entrou no ~/.hermes/cron/jobs.json. Uma entrada ruim basta para parar o scheduler inteiro. Uma correção mesclada em 2026-09-26 (PR #124034) trata essa classe de entrada; veja como isso quebrava, o que acontece agora e como verificar sua própria máquina.
Como um único null derruba o scheduler
O jobs.json é o armazenamento dos cron jobs. A cada tick, o scheduler chama load_jobs() para lê-lo. Se essa leitura lança exceção, o tick falha — e o tick seguinte lê o mesmo arquivo e falha de novo. Os jobs em si estão perfeitamente saudáveis; eles simplesmente nunca chegam a sua vez.
Três entradas distintas podiam produzir esse resultado:
| Entrada | Comportamento antigo | Consequência |
|---|---|---|
Uma entrada que não é objeto na lista jobs (null, uma string, um número) |
load_jobs() lançava exceção |
Todo tick falhava, então nenhum job rodava (issue #123281) |
Um campo jobs escalar, por exemplo {"jobs": null} |
Retornado ao chamador como estava | Os chamadores quebravam em outro lugar |
Um job cujo repeat.completed era null |
mark_job_run / update_job lançava TypeError: NoneType + int |
Registrar uma execução travava (issue #122114) |
A terceira trazia ainda um bug de exibição que ajudava a ignorá-la: com o contador quebrado, a tool de cronjob mostrava um job de execução única como 1/1, e o hermes cron mostrava a contagem como None/3. Com aparência estranha, mas não de erro — então continuava quebrado.
O que acontece agora
- Entradas ruins são puladas e o arquivo é reparado. O loader não lança mais exceção por causa de um pedaço de lixo; ele descarta entradas que não são objetos e regrava o armazenamento limpo no disco — inclusive quando não sobra nenhum job válido, caso em que o arquivo vira
[]. - Um campo
jobsescalar é normalizado.{"jobs": null}vira[]e é salvo, então todo chamador recebe uma lista. - Um contador não inteiro é normalizado.
repeat.completedé redefinido para uma contagem válida quando não é um inteiro não negativo (0 quando não dá para ler), uma única vez, no carregamento — assim todo leitor vê um inteiro e os erros de exibição1/1/None/3somem junto. - O reparo roda sob o lock. O save relê o arquivo depois de adquirir o lock do job-store, então um
update_jobconcorrente não é revertido. Esse foi o ponto de revisão que bloqueou o patch original, e é a diferença entre “reparar” e “desfazer silenciosamente a mudança de alguém”. - Os avisos registram tipos, não conteúdos. Cada aviso de reparo é emitido uma vez, e ele informa o tipo do valor descartado em vez do valor em si.
A documentação agora diz isso sem rodeios: se uma edição manual deixa o jobs.json malformado, o scheduler conserta o arquivo no próximo carregamento em vez de parar.
Como verificar sua própria máquina
Primeiro confirme que o scheduler e os próprios jobs estão saudáveis:
hermes cron list        # jobs e o status deles
hermes cron doctor      # execuções falhas, entregas falhas, next_run_at atrasado, scripts ausentes
Para procurar valores que não deveriam estar ali, esta passagem somente-leitura reporta os formatos:
python3 - <<'PY'
import json, os
p = os.path.expanduser("~/.hermes/cron/jobs.json")
d = json.load(open(p))
jobs = d.get("jobs")
print("jobs type:", type(jobs).__name__)
if isinstance(jobs, list):
    bad = [(i, type(j).__name__) for i, j in enumerate(jobs) if not isinstance(j, dict)]
    print("entries:", len(jobs), "| non-object entries:", bad or "none")
    for j in jobs:
        c = (j.get("repeat") or {}).get("completed")
        if not isinstance(c, int) or c < 0:
            print("  bad counter:", j.get("name") or j.get("id"), "->", repr(c))
PY
Ela nunca escreve. O reparo em si é trabalho do Hermes: faça upgrade, deixe o scheduler dar o próximo tick, e as entradas ruins somem.
Não edite o jobs.json à mão
A documentação é explícita: gerencie os jobs pela tool cronjob_manage, pelo hermes cron edit ou pelo /cron — não corrigindo o jobs.json direto. Edições diretas podem falhar em silêncio quando o caminho é bloqueado pela proteção de escrita de arquivo (por exemplo, com HERMES_WRITE_SAFE_ROOT definido), e o rodapé do verificador de mutação de arquivo é o único sinal autoritativo de que nada foi salvo.
É exatamente por isso que esta correção importa: os acidentes que acontecem fora do caminho da tool — um script externo, uma ferramenta de sincronização, uma edição manual pela metade — não deveriam custar todos os seus jobs agendados na máquina.
O que continua em aberto
O PR é explícito sobre uma coisa que deliberadamente não fez: a issue #123120 propõe falhar fechado em um armazenamento corrompido em vez de repará-lo, o que é uma postura de comportamento diferente e uma decisão de quem mantém o projeto. Ela continua aberta. A política de hoje é se autoconsertar primeiro.
A conclusão
O jobs.json saiu de “uma entrada de lixo mata a frota” para “pula, repara o arquivo, continua disparando”, e o repeat.completed saiu de um crash para um inteiro garantido. Se você roda trabalho agendado sem supervisão, vale adotar isso cedo — corrige o modo de falha mais difícil de diagnosticar, aquele em que tudo parece configurado e nada acontece. Para o terreno ao redor: um comando que faz a revisão completa da frota, armadilhas de fuso horário e horário de verão em agendamentos que cruzam o dia, cron jobs que guardam anotações entre execuções e a referência do comando hermes cron.