Atascado en el arranque: dos autobloqueos en Hermes y cómo se encontraron
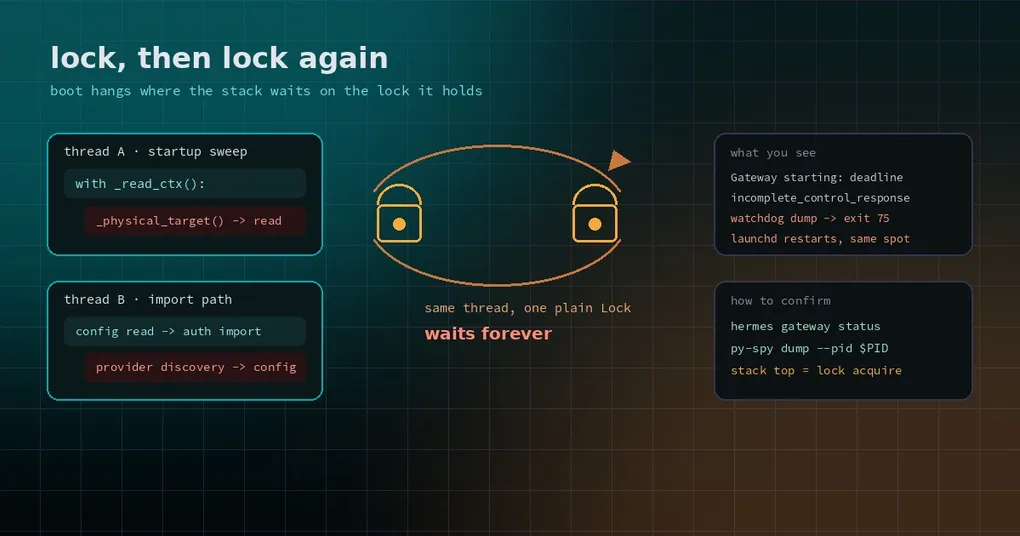
Escribes hermes gateway restart y esperas. Tres segundos, diez, treinta. El terminal te deja una sola línea: Gateway starting: deadline. La app de escritorio informa de Gateway inaccessible: incomplete_control_response, pulsas reintentar y obtienes la misma frase. Reinicias la máquina, el servicio vuelve a levantarse y se atasca exactamente en el mismo sitio: reinicio tras reinicio, sin llegar a arrancar nunca.
El primer instinto es «mi configuración estará mal», «el disco estará lleno», «esta compilación está rota». Hay un modo de fallo más difícil que todos esos: el proceso no se ha caído, la CPU está inactiva, el log no muestra ningún error… simplemente espera un lock que ya tiene tomado. Eso es un autobloqueo, y se presenta como «atascado», no como «fallido».
Alrededor del 2026-10-30 Hermes corrigió dos interbloqueos de arranque de este tipo: uno en el barrido de arranque del gateway y otro en la ruta de arranque del backend de configuración remota. Comparten la lección que merece recordarse: ambos llamaban, desde dentro de una sección crítica, a algo que necesitaba el mismo lock que esa sección ya tenía.
Primero, distingue «lento» de «muerto»
Se parecen y exigen respuestas opuestas, así que aquí va la comparación que conviene conservar:
| Síntoma | Lento (espera) | Interbloqueo (esperar no sirve de nada) |
|---|---|---|
| Duración del arranque | termina solo en decenas de segundos | nunca pasa del mismo punto |
| CPU | ocupada, inicializando | casi a cero, el hilo duerme |
| Log | sigue imprimiendo líneas nuevas | se detiene en seco en la última línea |
| Reinicio | normalmente va bien a la segunda | se atasca en el mismo lugar todas las veces |
| Estado del hilo | esperando E/S o red | esperando un lock (futex, adquisición de lock) |
El gateway ejecuta un watchdog de vitalidad del bucle que vuelca la pila actual y sale con un cierre forzado con estado 75 cuando el bucle de eventos se atasca, para que systemd o launchd lo reinicien. Ese comportamiento es correcto —un proceso reiniciado es mejor que uno congelado—, pero disfraza un interbloqueo de una retahíla de entradas «el gateway se ha vuelto a caer». Lo que ves en el log es arranque tras arranque, nunca un error claro.
Interbloqueo uno: un contexto de lectura anidado dentro del barrido de arranque
El primer caso es el barrido de huérfanos de arranque del gateway, que cierra las sesiones que dejó atrás un proceso anterior. La cadena es recover_local_sessions() → arm_startup_orphan_closes() → _idle_s(), que decide cuánto tiempo lleva inactiva una sesión.
El código culpable tenía este aspecto (simplificado):
with authority.db._read_ctx() as conn:
    row = conn.execute(
        f'SELECT {_sql_session_last_active("s")} FROM sessions s WHERE s.id = ?',
        (_physical_target(authority, session_id),),   # ← abre un SEGUNDO contexto de lectura
    ).fetchone()
El problema es el argumento: _physical_target() lee el recibo de sesión local, y leer el recibo es en sí mismo una lectura de base de datos. Así que dentro de un bloque que ya ha entrado en un contexto de lectura, componer un parámetro entra en un segundo.
Normalmente eso es inofensivo, porque las lecturas pasan por el pool de lectura WAL y se ejecutan en paralelo. Pero cuando el pool de lectura WAL no está disponible —la base de datos no está en modo WAL (journal DELETE), el home está en un sistema de archivos en red como NFS, o todos los permisos de lectura están agotados—, _read_ctx() degrada a «usar la conexión de escritura bajo SessionDB._lock». Ese lock es un threading.Lock normal: no es reentrante.
Resultado: un hilo toma el lock y luego pide el mismo lock desde dentro, y espera para siempre.
El arreglo es conceptual más que ingenioso: calcula primero el objetivo y luego abre el contexto de lectura, de modo que la sonda tome exactamente uno.
target = _physical_target(authority, session_id)
with authority.db._read_ctx() as conn:
    row = conn.execute(..., (target,)).fetchone()
La evidencia en vivo es de manual. En un gateway macOS el hilo de arranque se aparcó exactamente ahí, el socket de control nunca respondió, los clientes de escritorio informaron de Gateway inaccessible: incomplete_control_response y Gateway starting: deadline, el watchdog volcó esa pila y salió con 75, launchd lo reinició y todo se repitió. Esto es un bucle de arranque, no un arranque lento.
Merece la pena decirlo: la ruta de lectura degradada es correcta tal como está diseñada —una lectura más lenta es mejor que quedarse sin descriptores de archivo—. Lo que estaba mal era anidar una segunda lectura dentro de ella.
Interbloqueo dos: leer la configuración antes de que la configuración pueda leerse
El segundo caso es más sutil y más valioso, porque es una inversión del orden de locks entre módulos.
Un agente en Cloud con el backend de configuración en remoto (HERMES_CONFIG_BACKEND=remote) no arranca nunca: la primera lectura de configuración en la segunda etapa del arranque se cuelga para siempre. Solo ocurre en el modo de credenciales de Nous; el modo IdP no se ve afectado.
La cadena:
- La primera lectura de configuración de un perfil toma el lock de descarga de ese perfil y luego ejecuta la descarga de arranque.
- La descarga resuelve su token portador —el access token de Nous—, lo que importa en frío
hermes_cli.auth. hermes_cli.authimportahermes_cli.configen tiempo de importación, y ese módulo rellenabaOPTIONAL_ENV_VARS(los metadatos de «qué variable de entorno necesita este proveedor») a partir de los perfiles de proveedor.- Listar proveedores ejecuta el descubrimiento de proveedores, y el descubrimiento lee configuración (
plugins.enabled,plugins.isolation). - Esa lectura pide al backend el mismo perfil y espera el lock de descarga del paso 1, que tiene tomado el mismísimo hilo que hace todo esto.
En una frase: para leer la configuración, tenía que leer la configuración. No es reentrada simple; es un módulo que hace E/S con efectos secundarios en tiempo de importación y luego lo importa otro módulo que ya tiene un lock.
El arreglo elimina la lectura de configuración en tiempo de importación en lugar de sortearla:
- Importar
hermes_cli.configohermes_cli.authno lee configuración. El catálogo de variables de entorno de proveedores se construye en la primera lectura: cada plugin de proveedor incluido se ejecuta en un módulo privado, se recogen sus registros —sin configuración, sin descubrimiento, sin mutar el registro— y el resultado se cachea de forma idempotente. - El backend remoto resuelve su credencial antes de tomar el lock de descarga, y mantiene ese lock solo para el GET; los lectores concurrentes hacen cola ahí y comparten el resultado.
- No se registra nada mientras se tiene un lock del backend. Un manejador de log puede leer configuración, así que los mensajes se acumulan y se emiten después de soltar el lock.
- El formateador del log no lee configuración.
RedactingFormatterconsultaba antes la política de redacción del perfil enrutado para cada registro, bajo el lock del propio manejador de logging. Ahora solo lee el alcance de secretos vivo y la política registrada cuando se cargó el.envo la configuración de ese perfil; desconocido significa redactar.
Esa última es, en voz baja, una mejora de seguridad: «no se pudo determinar la política» y «la política es no redactar» eran fáciles de confundir, y ahora el valor por defecto es el seguro.
Cómo confirmar que es un interbloqueo
No lo adivines. Un volcado de pila vale más que diez lecturas del log:
- Localiza el proceso:
hermes gateway statuslista los servicios y procesos en ejecución. - Toma una instantánea con
py-spy(un generador de perfiles de terceros,pip install py-spy):py-spy dump --pid $GATEWAY_PID. - Mira dónde se queda el hilo de arranque. Los marcos superiores de un interbloqueo son adquisición de locks (
threading.Lock.acquire,futex,_read_ctx,with self._lock), no E/S de red o de disco. - Si la pila del mismo hilo muestra a la vez al dueño del lock y al que espera —un bloque
withcuyo cuerpo llama a algo que toma el mismo lock—, ya tienes tu respuesta.
También hay una prueba muy práctica: prueba con otro home. Arranca HERMES_HOME=/tmp/hermes-probe hermes gateway contra un home vacío. Si arranca al instante, el código está bien y el problema es el estado o el sistema de archivos de tu home, que es exactamente el disparador del caso uno (sin WAL, o un home en NFS).
Qué hacer cuando te topas con esto
- Caso uno (autobloqueo del barrido de arranque): el disparador es un home cuyo pool de lectura WAL no está disponible. Si estás anclado a una compilación sin el arreglo, reiniciar no ayudará: se atasca igual todas las veces. La mitigación práctica es mantener
HERMES_HOMEen un disco local en modo WAL y no en NFS ni en otro recurso compartido de red. - Caso dos (interbloqueo de arranque con configuración remota): el backend remoto no tiene alternativa local, así que volver a poner
HERMES_CONFIG_BACKENDenfilesolo funciona si ese perfil aún tiene unconfig.yamllocal utilizable. Sin él, cambiarlo solo produce un error distinto. La respuesta real es actualizar a una compilación con el arreglo. - Los dos arreglos están en
main(#144845 es P0, #146130 es P2) y ya están en la v0.22.6 (2026-11-02); si sigues en v0.22.5 o anterior, actualizar es la solución.
Qué enseña esto a quien escribe plugins
Si escribes plugins de Hermes o backends de configuración, estos dos casos son buenas plantillas:
- No leas configuración, no hagas llamadas de red ni mutes registros globales en tiempo de importación. Nunca sabes quién tiene un lock mientras te importa.
- No hagas E/S ni logging mientras tienes un lock. Un manejador de log es lo que más fácilmente se olvida que lee configuración.
- Prepara los argumentos antes de entrar en una sección crítica. Así murió exactamente el caso uno: componer un parámetro volvía a entrar en la misma sección.
- Las rutas degradadas son donde viven estos bugs. La ruta rápida era concurrente, así que el bug solo aparecía cuando el pool no estaba disponible: por eso sobrevivió tanto tiempo en producción.
Para los modos de fallo vecinos, lee las ocho razones por las que se congela el bucle de eventos del gateway y cómo ajustar los umbrales del watchdog del bucle. Junto con este artículo, cubren buena parte de lo que puede significar «el gateway ha dejado de responder».