Travado no boot: dois autodeadlocks no Hermes e como foram encontrados
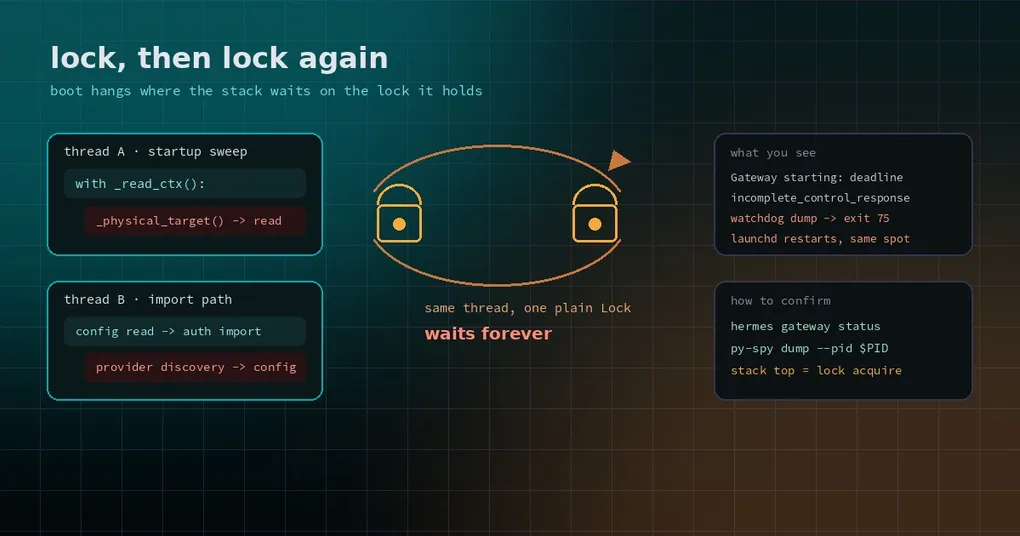
Você digita hermes gateway restart e espera. Três segundos, dez, trinta. O terminal te devolve uma linha: Gateway starting: deadline. O app desktop reporta Gateway inaccessible: incomplete_control_response, você aperta retry e recebe a mesma frase. Reinicia a máquina, o serviço volta, e trava exatamente no mesmo ponto — restart atrás de restart, sem nunca subir de fato.
O primeiro instinto é “meu config deve estar quebrado”, “o disco deve estar cheio”, “esse build está ruim”. Existe um modo de falha mais difícil que todos esses: o processo não crashou, a CPU está ociosa, o log não tem erro — ele simplesmente espera por um lock que ele mesmo já segura. É um autodeadlock, e ele se apresenta como “travado”, não como “falhou”.
Por volta de 2026-10-30 o Hermes corrigiu dois deadlocks de boot desse tipo: um na varredura de inicialização do gateway, outro no caminho de boot do backend de config remoto. Eles compartilham a lição que vale guardar: os dois chamavam, de dentro de uma seção crítica que já segurava o lock, algo que precisava do mesmo lock.
Primeiro, separe “lento” de “morto”
Os dois se parecem e pedem respostas opostas, então aqui vai a comparação que vale ter à mão:
| Sintoma | Lento (espere) | Deadlock (esperar não resolve) |
|---|---|---|
| Duração do boot | termina sozinho em dezenas de segundos | nunca passa do mesmo ponto |
| CPU | ocupada, inicializando | perto de zero, thread dormindo |
| Log | continua imprimindo linhas novas | para seco na última linha |
| Restart | costuma dar certo na segunda vez | trava no lugar idêntico toda vez |
| Estado da thread | esperando IO ou rede | esperando um lock (futex, aquisição de lock) |
O gateway roda um watchdog de vivacidade do loop que despeja a stack atual e sai à força com status 75 quando o event loop trava, para que systemd ou launchd o reiniciem. Esse comportamento está certo — um processo reiniciado é melhor que um congelado —, mas ele disfarça um deadlock como uma sequência de “o gateway caiu de novo”. O que você vê no log é boot após boot, nunca um erro claro.
Deadlock um: um contexto de leitura aninhado dentro da varredura de inicialização
O primeiro caso é a varredura de órfãos da inicialização do gateway, que encerra sessões deixadas por um processo anterior. A corrente é recover_local_sessions() → arm_startup_orphan_closes() → _idle_s(), que decide há quanto tempo uma sessão está ociosa.
O código culpado era assim (simplificado):
with authority.db._read_ctx() as conn:
    row = conn.execute(
        f'SELECT {_sql_session_last_active("s")} FROM sessions s WHERE s.id = ?',
        (_physical_target(authority, session_id),),   # ← abre um SEGUNDO contexto de leitura
    ).fetchone()
O problema está no argumento: _physical_target() lê o recibo local da sessão, e ler o recibo é, por si só, uma leitura de banco. Então, dentro de um bloco que já entrou num contexto de leitura, compor um parâmetro entra num segundo.
Normalmente isso é inofensivo, porque as leituras passam pelo pool de leitura WAL e rodam em paralelo. Mas quando o pool de leitura WAL está indisponível — o banco não está em modo WAL (journal DELETE), a home fica num filesystem de rede como NFS, ou todas as permissões de leitura estão gastas —, o _read_ctx() degrada para “use a conexão de escrita sob SessionDB._lock”. Esse lock é um threading.Lock puro: não é reentrante.
Então uma thread pega o lock e, de dentro dele, pede o mesmo lock, e espera para sempre.
A correção é conceitual, não genial: calcule o alvo primeiro e só depois abra o contexto de leitura, para que a sondagem use exatamente um.
target = _physical_target(authority, session_id)
with authority.db._read_ctx() as conn:
    row = conn.execute(..., (target,)).fetchone()
A evidência em produção é de manual. Num gateway macOS, a thread de boot parou exatamente ali, o socket de controle nunca respondeu, os clientes desktop reportaram Gateway inaccessible: incomplete_control_response e Gateway starting: deadline, o watchdog despejou aquela stack e saiu com 75, o launchd reiniciou, e tudo se repetiu. Isso é um loop de boot, não uma inicialização lenta.
Vale dizer: o caminho de leitura degradado está correto como projetado — uma leitura mais lenta é melhor do que ficar sem file descriptors. O erro era aninhar uma segunda leitura dentro dele.
Deadlock dois: ler config antes de a config poder ser lida
O segundo caso é mais sutil e mais valioso, porque é uma inversão de ordem de locks entre módulos.
Um agente Cloud com o backend de config definido como remoto (HERMES_CONFIG_BACKEND=remote) nunca sobe: a primeira leitura de config no segundo estágio da inicialização pendura para sempre. Só no modo de credencial Nous; o modo IdP não é afetado.
A corrente:
- A primeira leitura de config de um perfil pega o fetch lock daquele perfil e então roda o fetch de boot.
- O fetch resolve o seu bearer — o access token da Nous —, o que importa a frio o
hermes_cli.auth. - O
hermes_cli.authimporta ohermes_cli.configem tempo de import, e esse módulo preenchiaOPTIONAL_ENV_VARS(a metadata de “qual variável de ambiente este provider precisa”) a partir dos perfis de provider. - Listar providers roda a descoberta de providers, e a descoberta lê config (
plugins.enabled,plugins.isolation). - Essa leitura pede ao backend o mesmo perfil e espera o fetch lock do passo 1 — segurado pela própria thread que está fazendo tudo isso.
Numa frase: para ler config, era preciso ler config. Isso não é reentrância simples; é um módulo fazendo IO com efeito colateral em tempo de import, e depois sendo importado por outro módulo que já segura um lock.
A correção remove a leitura de config em tempo de import em vez de contorná-la:
- Importar
hermes_cli.configouhermes_cli.authnão lê config. O catálogo de variáveis de ambiente dos providers é montado na primeira leitura: cada plugin de provider embutido é executado num módulo privado, seus registros são coletados — sem config, sem descoberta, sem mutação do registro —, e o resultado é cacheado de forma idempotente. - O backend remoto resolve a credencial antes de pegar o fetch lock, e segura esse lock só durante o GET; leitores concorrentes fazem fila ali e compartilham o resultado.
- Nada é logado enquanto um lock de backend está preso. Um handler de log pode ler config, então as mensagens são coletadas e emitidas depois que o lock é liberado.
- O formatador de log não lê config. O
RedactingFormatterconsultava a política de redação do perfil roteado a cada registro, sob o lock do próprio handler de logging. Agora ele lê apenas o escopo de segredos vivo e a política registrada quando o.envou o config daquele perfil foi carregado; desconhecido significa redigir.
Esse último é, silenciosamente, um ganho de segurança: “não foi possível determinar a política” e “a política é não redigir” eram fáceis de confundir, e agora o padrão é o seguro.
Como confirmar que é um deadlock
Não adivinhe. Um dump de stack vale mais que dez leituras de log:
- Ache o processo:
hermes gateway statuslista os serviços e processos em execução. - Tire um snapshot com
py-spy(um profiler de terceiros,pip install py-spy):py-spy dump --pid $GATEWAY_PID. - Olhe onde a thread de boot está parada. Os frames do topo de um deadlock são aquisição de lock (
threading.Lock.acquire,futex,_read_ctx,with self._lock), não IO de rede ou de disco. - Se a stack da mesma thread mostra o dono do lock e o esperador — um bloco
withcujo corpo chama algo que pega o mesmo lock —, você tem sua resposta.
Há também um teste bem prático: tente outra home. Suba HERMES_HOME=/tmp/hermes-probe hermes gateway contra uma home vazia. Se ele sobe na hora, o código está bem e o problema é o estado ou o filesystem da sua home — que é justamente o gatilho do caso um (sem WAL, ou uma home em NFS).
O que fazer quando você esbarrar nisso
- Caso um (autolock na varredura de inicialização): o gatilho é uma home cujo pool de leitura WAL está indisponível. Se você está preso a um build sem a correção, reiniciar não ajuda — ele trava igual toda vez. A mitigação prática é manter o
HERMES_HOMEnum disco local em modo WAL, e não em NFS ou outro compartilhamento de rede. - Caso dois (deadlock de boot com config remoto): o backend remoto não tem fallback local, então voltar o
HERMES_CONFIG_BACKENDparafilesó funciona se aquele perfil ainda tiver umconfig.yamllocal utilizável. Sem ele, a mudança só produz um erro diferente. A resposta real é atualizar para um build com a correção. - As duas correções estão na
main(#144845 é P0, #146130 é P2) e já estão na v0.22.6 (2026-11-02); se você está no v0.22.5 ou anterior, atualizar resolve.
O que isso ensina a quem escreve plugins
Se você escreve plugins ou backends de config para o Hermes, esses dois casos são bons modelos:
- Não leia config, não faça chamadas de rede e não mute registros globais em tempo de import. Você nunca sabe quem está segurando um lock enquanto te importa.
- Não faça IO nem logging segurando um lock. Um handler de log é a coisa que lê config mais fácil de esquecer.
- Prepare os argumentos antes de entrar numa seção crítica. Foi exatamente assim que o caso um morreu: compor um parâmetro reentrou na mesma seção.
- É nos caminhos degradados que esses bugs moram. O caminho rápido era concorrente, então o bug só aparecia quando o pool estava indisponível — e é por isso que ele sobreviveu tanto tempo em produção.
Para os modos de falha vizinhos, leia as oito razões pelas quais o event loop do gateway congela e como ajustar os limiares do watchdog do loop. Junto com este texto, eles cobrem boa parte do que “o gateway parou de responder” pode significar.