启动即卡死:Hermes 里两个"自己等自己"的死锁是怎么被找出来的
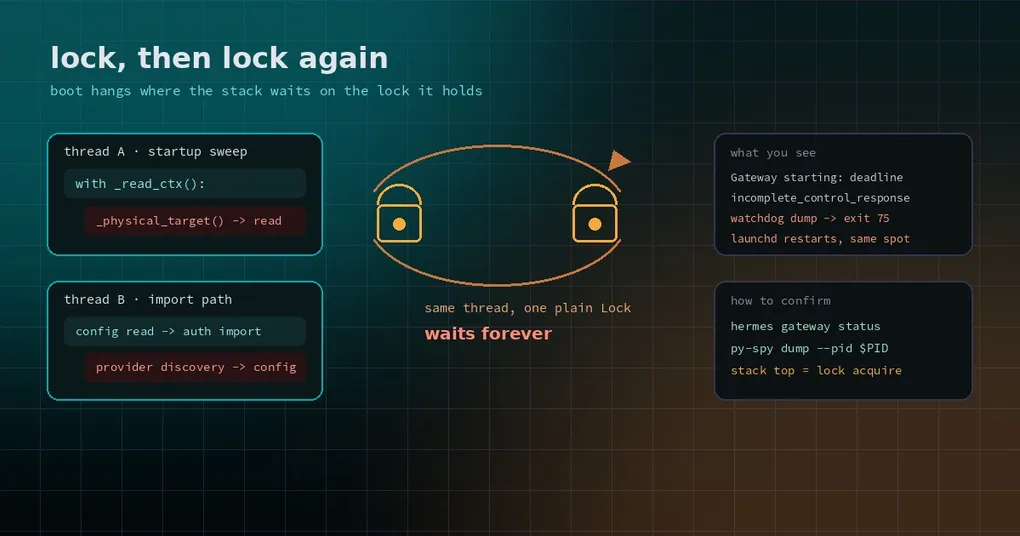
你敲下 hermes gateway restart,等了三秒、十秒、三十秒。终端最后只留下一行 Gateway starting: deadline。桌面端弹出一句 Gateway inaccessible: incomplete_control_response,点重试,还是同一句。你把电脑重启了,服务被重新拉起来,然后又卡在同一个地方——一圈一圈地重启,永远起不来。
大多数人第一反应是“是不是配置写坏了”“是不是磁盘满了”“是不是这个版本有问题”。但有一种情况比这些都难查:进程没有崩、CPU 不忙、日志不报错,它只是在等一把自己已经握在手里的锁。这种叫自锁(self-deadlock),表现出来就是“卡住”,而不是“失败”。
2026-10-30 前后,Hermes 修掉了两个这样的启动死锁,一个在网关启动清扫里,一个在远程配置后端的引导路径上。它们的共同点很值得记住:都是在一个已经被锁住的临界区里,又调用了需要同一把锁的东西。
先分清“慢”和“死”
这两种情况的表象很像,但处理方式完全相反,所以先给一份对照:
| 症状 | 慢(可以等) | 死锁(等多久都没用) |
|---|---|---|
| 启动耗时 | 几十秒后自己走完 | 永远停在同一个点 |
| CPU | 有占用,在跑初始化 | 接近 0,进程在睡眠 |
| 日志 | 持续输出新行 | 停在最后一行不动 |
| 重启 | 第二次通常就好 | 每次都在完全相同的位置卡住 |
| 线程状态 | 在等 IO / 网络 | 在等一把锁(futex / lock) |
网关有一个“事件循环看门狗”,当它发现事件循环被卡住时会 dump 出当前堆栈然后以 退出码 75 硬退出,让 systemd / launchd 重新拉起。这个行为本身是对的(总比僵在那儿好),但它会把一个死锁伪装成一串“网关又崩了”的重启记录——于是你在日志里看到的是一遍又一遍的启动,而不是一条明确的错误。
死锁一:启动清扫里嵌套开了一个读上下文
第一个案子来自网关启动时的“孤儿会话清扫”(把上次进程留下的、没人管的会话收尾)。流程是 recover_local_sessions() → arm_startup_orphan_closes() → _idle_s(),也就是判断一条会话空闲了多久。
出事的代码长这样(简化过):
with authority.db._read_ctx() as conn:
    row = conn.execute(
        f'SELECT {_sql_session_last_active("s")} FROM sessions s WHERE s.id = ?',
        (_physical_target(authority, session_id),),   # ← 这里又开了一个读上下文
).fetchone()问题就在那个参数上:_physical_target() 要去读本地会话回执,而读回执本身也是一次数据库读。也就是说,在“已经进入读上下文”的代码块里,为了拼一个参数,又进了一次读上下文。
正常情况下这没事,因为读走的是 WAL 只读连接池,可以并发。但当 WAL 只读池不可用时——数据库不是 WAL 模式(DELETE journal)、或者 home 在 NFS 这类网络文件系统上、或者读许可已经被用完——_read_ctx() 会降级成“用写连接、在 SessionDB._lock 保护下读”。而那把锁是普通的 threading.Lock,不可重入。
于是同一条线程:先拿到锁,然后在里面再次请求同一把锁,永远等下去。
修复只有一行思路上的事:先把 target 算出来,再进读上下文,让这次探测只开一个读上下文。
target = _physical_target(authority, session_id)
with authority.db._read_ctx() as conn:
    row = conn.execute(..., (target,)).fetchone()
现场证据也很典型:macOS 上一台网关的启动线程就停在这个位置,控制 socket 一直不应答,桌面端报 Gateway inaccessible: incomplete_control_response 和 Gateway starting: deadline,看门狗 dump 了这条堆栈后退出 75,launchd 再拉起来,进入完全一样的循环。这是启动死循环,不是启动慢。
顺带说一句:那个“降级成写连接”的设计本身是对的——宁可慢一点也别把文件句柄耗尽。错的是调用方在降级路径里嵌套了第二次读。
死锁二:读配置之前要先读配置
第二个案子更绕,也更值得记住,因为它是一条跨模块的锁顺序反转。
场景是:一个 Cloud agent 把配置后端设成了远程(HERMES_CONFIG_BACKEND=remote),启动第二阶段的第一次配置读取会永久挂住。只在 Nous 凭据模式下出现,IdP 模式不受影响。
链条是这样的:
- 某个 profile 的第一次读配置,先拿这个 profile 的 fetch 锁,然后去后端拉配置。
- 拉取要解析 bearer,也就是 Nous 的访问令牌,这会冷导入
hermes_cli.auth。 - 而
hermes_cli.auth在导入时会导入hermes_cli.config;hermes_cli.config在导入时又要填充OPTIONAL_ENV_VARS(那些“这个 provider 需要哪个环境变量”的描述信息),来源是各个 provider 的 profile。 - 列举 provider 会触发 provider 发现,而 provider 发现要读配置(
plugins.enabled、plugins.isolation)。 - 这次读配置,请求的还是同一个 profile,于是等待第 1 步那把 fetch 锁——而它正被同一条线程握在手里。
一句话:为了读配置,先读了配置。 这不是简单的重入,而是一个模块在 import 时干了“有副作用、需要 IO”的事,然后被另一个模块在持锁状态下 import 了。
修复的思路是“消掉 import 时的配置读取”,而不是在原地绕:
- 导入
hermes_cli.config或hermes_cli.auth不再读任何配置,provider 的环境变量目录改成首次读取时才构建:把每个内置 provider 插件执行进一个私有的模块里,收集它注册的信息,不碰配置、不做发现、不改全局注册表,结果幂等缓存。 - 远程后端先解析凭据,再拿 fetch 锁,并且只把锁持有到 GET 结束;并发读在这把锁上排队、共享同一个结果。
- 持锁期间不打日志:日志处理器本身可能去读配置,所以消息先收集,释放锁之后再输出。
- 日志格式化器不读配置:
RedactingFormatter原来是每条日志按 profile 去配置里取脱敏策略(而且是在 logging 自己的锁里)。现在它只读当前的密钥作用域,以及该 profile 加载.env/ 配置时记录下的策略;不知道就按脱敏处理。
最后这一条其实是个安全上的改进:以前“取不到策略”和“策略是不脱敏”在代码上容易混,现在默认值是“脱敏”。
怎么自己确认“是死锁”
不要靠猜,抓一次堆栈比读十遍日志有用:
- 确定网关进程:
hermes gateway status会列出正在跑的服务和进程。 - 用
py-spy(第三方 profiler,pip install py-spy)抓一次:py-spy dump --pid $GATEWAY_PID(把$GATEWAY_PID换成上一步查到的进程号)。 - 看主线程/启动线程停在哪。死锁的特征是栈顶停在锁的获取上(
threading.Lock.acquire、futex、_read_ctx、with self._lock之类),而不是停在网络读写、磁盘 IO 上。 - 如果同一条线程的栈里同时出现“持锁者”和“等锁者”(比如一个
with块里面又调了一个自己会加锁的函数),基本可以定案。
还有一个非常实用的判别法:换一个 home 试试。 HERMES_HOME=/tmp/hermes-probe hermes gateway 起一个空白 home,如果它秒起,说明问题不在代码,而在你这个 home 的状态或文件系统——这也正好对应案子一里“没有 WAL / 在 NFS 上”这个触发条件。
遇到它怎么办
- 案子一(启动清扫自锁):触发条件是这个 home 的 WAL 只读池不可用。如果你被钉在一个还没修好的版本上,重启是没用的(每次都会卡在同一处)。可行的缓解是把
HERMES_HOME放到本地磁盘、并确认数据库是 WAL 模式,而不是放在 NFS / 网络盘上。 - 案子二(远程配置引导死锁):远程后端没有本地兜底,所以“把
HERMES_CONFIG_BACKEND改回 file”只在那个 profile 仍然有可用的本地config.yaml时才成立;没有的话,改回去只会得到另一个错误。真正的办法是升级到带修复的版本。 - 两个案子的修复都在
main上(#144845 是 P0,#146130 是 P2),并已随 v0.22.6(2026-11-02 发布) 进入正式发行版——卡在 v0.22.5 及更早版本的,升级即可。
这一课对写插件的人意味着什么
如果你在给 Hermes 写插件或后端,这两个案子是很好的模板:
- 不要在 import 时读配置、做网络请求、或注册会触发发现的全局状态。 你永远不知道谁会持着锁来 import 你。
- 持锁期间不做 IO,不打日志。 日志处理器是最容易被忘掉的“会读配置的东西”。
- 进临界区之前把参数准备好。 案子一就是这么死的:为了拼一个参数又进了同一个临界区。
- 降级路径尤其危险。 正常路径能并发,所以问题只在“池子不可用”时才出现——这也是它能在生产里活那么久的原因。
想继续看网关这块的其他坑,可以读网关事件循环被卡死的八种原因,以及看门狗的几个阈值该怎么调。这三篇凑一起,基本能覆盖“网关不动了”这个现象的主要成因。